SHAP: modelni tushuntirish
Sahna: "nega rad etildi?"
Modelingiz ishlaydi. Menejer xursand. Keyin mijoz qo'ng'iroq qiladi:
"Nega mening e'lonim 'sekin ketadi' deb belgilandi?"
Siz nima deysiz? "Random Forest dagi 200 daraxtning ko'pchiligi shunday ovoz berdi" — bu javob emas.
Bu bob shu savolga javob beradigan asbobni beradi.
Ikki xil savol — ikki xil asbob
import pandas as pd
import numpy as np
show(pd.DataFrame([
    {"Savol": "Model UMUMAN nimaga qaraydi?", "Nomi": "Global tushuntirish",
     "Asboblar": "feature_importances_, permutation importance, SHAP summary"},
    {"Savol": "BU QATOR nega shunday baholandi?", "Nomi": "Lokal tushuntirish",
     "Asboblar": "SHAP waterfall, LIME"},
]))
| Savol | Nomi | Asboblar |
|---|---|---|
| Model UMUMAN nimaga qaraydi? | Global tushuntirish | feature_importances_, permutation importance, SHAP summary |
| BU QATOR nega shunday baholandi? | Lokal tushuntirish | SHAP waterfall, LIME |
17-bobda global tushuntirishni ko'rganmiz (feature_importances_ va permutation). Lekin ikkisi ham lokal savolga javob bermaydi.
SHAP ikkisini ham beradi.
Modelni quramiz
from sklearn.model_selection import train_test_split
from sklearn.ensemble import RandomForestClassifier

df = pd.read_csv(DATA / "uy_ijara.csv")
son = ["xonalar", "maydon_m2", "qavat", "qavatlar_soni", "metro_km", "mebel"]
X, y = df[son], df["ijaraga_berildi_30k"]
X_tr, X_te, y_tr, y_te = train_test_split(X, y, test_size=0.3, random_state=42, stratify=y)

model = RandomForestClassifier(n_estimators=200, min_samples_leaf=10, random_state=42).fit(X_tr, y_tr)
print(f"test accuracy: {model.score(X_te, y_te):.4f}")
print()
print("Eski usul — feature_importances_:")
for nom, v in sorted(zip(son, model.feature_importances_), key=lambda x: -x[1]):
    print(f"  {nom:16s} {v:.4f}")
print()
print("Muammo: bu bitta kvartira haqida HECH NARSA aytmaydi.")
test accuracy: 0.7750

Eski usul — feature_importances_:
  maydon_m2        0.4548
  xonalar          0.2437
  metro_km         0.1361
  qavatlar_soni    0.0877
  qavat            0.0626
  mebel            0.0151

Muammo: bu bitta kvartira haqida HECH NARSA aytmaydi.
SHAP ning g'oyasi: adolatli taqsimot
SHAP o'yin nazariyasidan keladi (Shapley, 1951). Savol shunday qo'yiladi:
Bashoratni o'rtachadan shu qiymatga olib kelgan hissani xususiyatlar orasida ADOLATLI taqsimlash.
"Adolatli" degani: har bir xususiyatning hissasi uning hamma mumkin bo'lgan kombinatsiyalardagi o'rtacha ta'siriga teng.
Natijada bitta tenglik hosil bo'ladi:
import shap

tushuntiruvchi = shap.TreeExplainer(model)
sh = tushuntiruvchi(X_te)
qiymatlar = sh.values[:, :, 1] if sh.values.ndim == 3 else sh.values
asos = sh.base_values[0, 1] if np.ndim(sh.base_values) > 1 else sh.base_values[0]

print(f"SHAP qiymatlari shakli: {qiymatlar.shape}  -> har QATOR va har USTUN uchun bitta son")
print(f"Asos qiymat (o'rtacha bashorat): {asos:.4f}")
print()
# tenglikni tekshiramiz
i = 0
jami = asos + qiymatlar[i].sum()
haqiqiy = model.predict_proba(X_te.iloc[[i]])[0, 1]
print(f"1-qator uchun tekshiruv:")
print(f"  asos + SHAP yig'indisi = {asos:.4f} + {qiymatlar[i].sum():+.4f} = {jami:.4f}")
print(f"  modelning haqiqiy bashorati          = {haqiqiy:.4f}")
print(f"  mos keldimi: {bool(np.isclose(jami, haqiqiy, atol=1e-6))}")
SHAP qiymatlari shakli: (360, 6)  -> har QATOR va har USTUN uchun bitta son
Asos qiymat (o'rtacha bashorat): 0.5072

1-qator uchun tekshiruv:
  asos + SHAP yig'indisi = 0.5072 + -0.2555 = 0.2517
  modelning haqiqiy bashorati          = 0.2517
  mos keldimi: True
Tenglik aynan bajarildi. Bu — SHAP ning asosiy kafolati, va shuning uchun uning natijasiga ishonish mumkin.
Lokal tushuntirish: bitta kvartira
i = 0
qator = X_te.iloc[i]
hissa = pd.DataFrame({
    "xususiyat": son,
    "qiymati": qator.values,
    "SHAP hissasi": qiymatlar[i].round(4),
}).sort_values("SHAP hissasi", key=abs, ascending=False)
hissa["yo'nalish"] = ["TEZ ketish tomoniga" if v > 0 else "SEKIN ketish tomoniga"
                      for v in hissa["SHAP hissasi"]]
show(hissa)
print()
print(f"O'rtacha bashorat     : {asos:.4f}")
print(f"Hissalar yig'indisi   : {qiymatlar[i].sum():+.4f}")
print(f"Bu kvartira bashorati : {model.predict_proba(X_te.iloc[[i]])[0, 1]:.4f}")
print(f"Haqiqiy javob         : {y_te.iloc[i]}")
O'rtacha bashorat     : 0.5072
Hissalar yig'indisi   : -0.2555
Bu kvartira bashorati : 0.2517
Haqiqiy javob         : 1
| xususiyat | qiymati | SHAP hissasi | yo'nalish |
|---|---|---|---|
| maydon_m2 | 79.2 | -0.175 | SEKIN ketish tomoniga |
| xonalar | 4 | -0.124 | SEKIN ketish tomoniga |
| qavat | 9 | 0.021 | TEZ ketish tomoniga |
| metro_km | 2.01 | 0.021 | TEZ ketish tomoniga |
| mebel | 0 | 0.008 | TEZ ketish tomoniga |
| qavatlar_soni | 10 | -0.007 | SEKIN ketish tomoniga |
Mana mijozga aytiladigan javob. Jadvalning birinchi qatorini o'qib, aniq sabab aytasiz.
import matplotlib.pyplot as plt
rasm, ax = plt.subplots(figsize=(9.5, 4.5))
tartib = np.argsort(np.abs(qiymatlar[i]))
ranglar = ["#137333" if qiymatlar[i][k] > 0 else "#c5221f" for k in tartib]
ax.barh(range(len(tartib)), qiymatlar[i][tartib], color=ranglar, alpha=.85)
ax.set_yticks(range(len(tartib)))
ax.set_yticklabels([f"{son[k]} = {qator.values[k]:.4g}" for k in tartib])
ax.axvline(0, color="k", lw=1)
ax.set_xlabel("SHAP hissasi (ehtimollikka ta'siri)")
ax.set_title(f"Bitta kvartira: o'rtacha {asos:.3f} -> bashorat {asos + qiymatlar[i].sum():.3f}",
             fontweight="bold")
ax.grid(alpha=.3, axis="x")
fig("shap_lokal.png", caption="Yashil — tez ketish tomoniga, qizil — sekin ketish tomoniga. Uzunlik hissaning kuchini ko'rsatadi.")
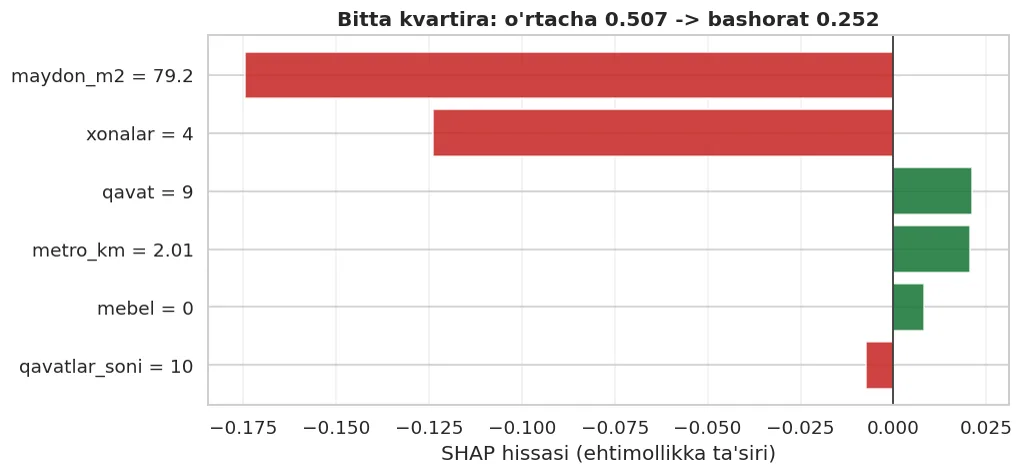
Yashil — tez ketish tomoniga, qizil — sekin ketish tomoniga. Uzunlik hissaning kuchini ko'rsatadi.
Global tushuntirish: SHAP o'rtachasi
Lokal hissalarning mutlaq o'rtachasi global muhimlikni beradi — va u feature_importances_ dan ishonchliroq.
from sklearn.inspection import permutation_importance
pi = permutation_importance(model, X_te, y_te, n_repeats=20, random_state=42, scoring="f1")

taqqos = pd.DataFrame({
    "xususiyat": son,
    "feature_importances_": model.feature_importances_.round(4),
    "permutation": pi.importances_mean.round(4),
    "SHAP (|o'rtacha|)": np.abs(qiymatlar).mean(axis=0).round(4),
}).sort_values("SHAP (|o'rtacha|)", ascending=False)
show(taqqos)
print()
print("Uch ustunning tartibi mos keladimi — tekshiring.")
Uch ustunning tartibi mos keladimi — tekshiring.
| xususiyat | feature_importances_ | permutation | SHAP (|o'rtacha|) |
|---|---|---|---|
| maydon_m2 | 0.455 | 0.145 | 0.095 |
| xonalar | 0.244 | 0.086 | 0.091 |
| qavatlar_soni | 0.088 | 0.001 | 0.019 |
| metro_km | 0.136 | -0.006 | 0.014 |
| qavat | 0.063 | 0.004 | 0.013 |
| mebel | 0.015 | -0.005 | 0.004 |
rasm, axes = plt.subplots(1, 2, figsize=(14, 4.8))

# summary bar
tartib_g = np.argsort(np.abs(qiymatlar).mean(axis=0))
axes[0].barh(range(len(son)), np.abs(qiymatlar).mean(axis=0)[tartib_g], color="#1a73e8", alpha=.85)
axes[0].set_yticks(range(len(son)))
axes[0].set_yticklabels([son[k] for k in tartib_g])
axes[0].set_xlabel("|SHAP| o'rtachasi")
axes[0].set_title("Global muhimlik", fontweight="bold")
axes[0].grid(alpha=.3, axis="x")

# beeswarm o'rniga: eng muhim xususiyat uchun qiymat va SHAP bog'liqligi
eng_muhim = int(np.argmax(np.abs(qiymatlar).mean(axis=0)))
axes[1].scatter(X_te.iloc[:, eng_muhim], qiymatlar[:, eng_muhim], alpha=.5, s=22, c="#c5221f")
axes[1].axhline(0, color="k", lw=1, ls="--")
axes[1].set_xlabel(son[eng_muhim])
axes[1].set_ylabel(f"SHAP hissasi")
axes[1].set_title(f"'{son[eng_muhim]}' qiymati va uning ta'siri", fontweight="bold")
axes[1].grid(alpha=.3)
fig("shap_global.png", caption="Chapda: qaysi xususiyat umuman muhim. O'ngda: eng muhim xususiyatning qiymati oshganda ta'siri qanday o'zgaradi.")
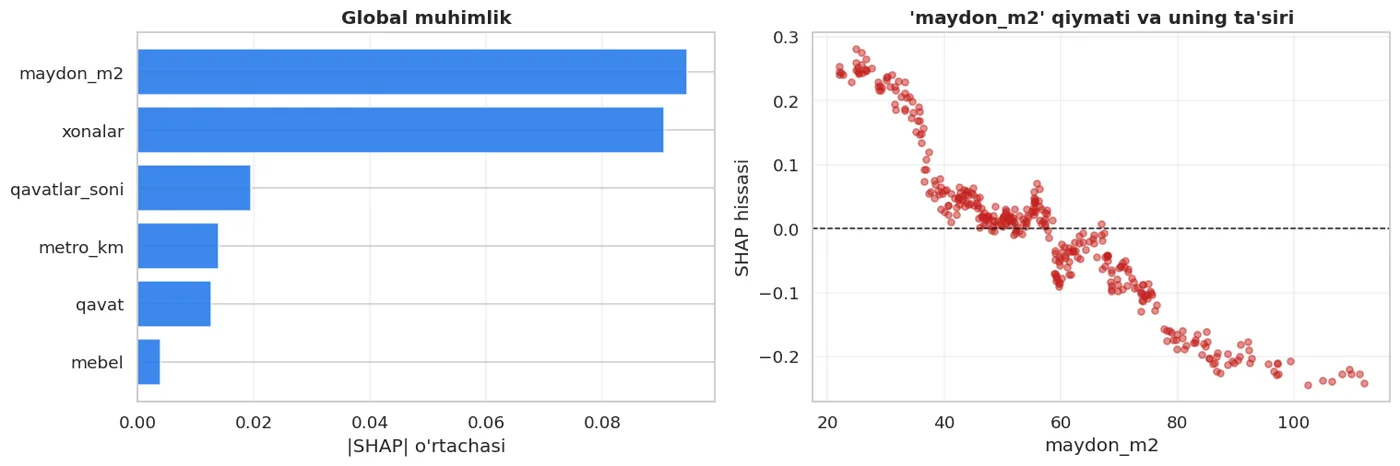
Chapda: qaysi xususiyat umuman muhim. O'ngda: eng muhim xususiyatning qiymati oshganda ta'siri qanday o'zgaradi.
O'ngdagi grafik juda qimmatli: u xususiyatning ta'siri chiziqlimi yoki yo'qligini ko'rsatadi. Agar nuqtalar egri chiziq hosil qilsa, bog'lanish chiziqsiz.
SHAP nega feature_importances_ dan yaxshi
show(pd.DataFrame([
    {"Xususiyat": "Lokal (bitta qator) tushuntirish", "feature_importances_": "YO'Q", "SHAP": "BOR"},
    {"Xususiyat": "Yo'nalish (oshiradi/kamaytiradi)", "feature_importances_": "YO'Q", "SHAP": "BOR (belgi)"},
    {"Xususiyat": "Yig'indi bashoratga teng", "feature_importances_": "YO'Q", "SHAP": "BOR (kafolat)"},
    {"Xususiyat": "Ko'p qiymatli ustunga moyillik", "feature_importances_": "BOR (muammo)", "SHAP": "Kamroq"},
    {"Xususiyat": "Hisoblash narxi", "feature_importances_": "Bepul", "SHAP": "Qimmat"},
]))
| Xususiyat | feature_importances_ | SHAP |
|---|---|---|
| Lokal (bitta qator) tushuntirish | YO'Q | BOR |
| Yo'nalish (oshiradi/kamaytiradi) | YO'Q | BOR (belgi) |
| Yig'indi bashoratga teng | YO'Q | BOR (kafolat) |
| Ko'p qiymatli ustunga moyillik | BOR (muammo) | Kamroq |
| Hisoblash narxi | Bepul | Qimmat |
import time
print("Hisoblash narxi — o'lchaymiz:")
t0 = time.perf_counter(); _ = model.feature_importances_; t1 = time.perf_counter()
print(f"  feature_importances_ : {(t1-t0)*1000:.3f} ms")
t0 = time.perf_counter(); _ = shap.TreeExplainer(model)(X_te); t1 = time.perf_counter()
print(f"  SHAP (TreeExplainer) : {(t1-t0)*1000:.1f} ms  ({len(X_te)} qator uchun)")
t0 = time.perf_counter()
_ = permutation_importance(model, X_te, y_te, n_repeats=20, random_state=42, scoring="f1")
t1 = time.perf_counter()
print(f"  permutation (20 marta): {(t1-t0)*1000:.1f} ms")
Hisoblash narxi — o'lchaymiz:
  feature_importances_ : 3.454 ms
  SHAP (TreeExplainer) : 165.5 ms  (360 qator uchun)
  permutation (20 marta): 815.9 ms
`TreeExplainer` tez, `KernelExplainer` juda sekin
SHAP da bir nechta tushuntiruvchi bor:
TreeExplainer— daraxt modellari uchun (RF, XGBoost, LightGBM). Aniq va tez.LinearExplainer— chiziqli modellar uchun. Tez.KernelExplainer— har qanday model uchun, lekin taqribiy va juda sekin.
KernelExplainer ni 1000 qatorga ishlatmoqchi bo'lsangiz, bir necha daqiqa kutishingiz mumkin. Shuning uchun u bilan odatda 50-100 qatorlik namuna tushuntiriladi.
Chiziqli model uchun SHAP — koeffitsiyent bilan tekshirish
from sklearn.linear_model import LogisticRegression
from sklearn.preprocessing import StandardScaler
from sklearn.pipeline import Pipeline

sc = StandardScaler().fit(X_tr)
lr = LogisticRegression(max_iter=3000).fit(sc.transform(X_tr), y_tr)

lin_exp = shap.LinearExplainer(lr, sc.transform(X_tr))
lin_sh = lin_exp(sc.transform(X_te))

taqqos2 = pd.DataFrame({
    "xususiyat": son,
    "koeffitsiyent": lr.coef_[0].round(4),
    "SHAP |o'rtacha|": np.abs(lin_sh.values).mean(axis=0).round(4),
}).sort_values("SHAP |o'rtacha|", ascending=False)
show(taqqos2)
print()
print("Chiziqli modelda SHAP = koeffitsiyent x (qiymat - o'rtacha).")
print("Shuning uchun tartib koeffitsiyentlar mutlaq qiymati bilan MOS keladi.")
Chiziqli modelda SHAP = koeffitsiyent x (qiymat - o'rtacha).
Shuning uchun tartib koeffitsiyentlar mutlaq qiymati bilan MOS keladi.
| xususiyat | koeffitsiyent | SHAP |o'rtacha| |
|---|---|---|
| maydon_m2 | -0.945 | 0.726 |
| xonalar | -0.175 | 0.146 |
| qavat | 0.086 | 0.07 |
| metro_km | 0.041 | 0.032 |
| qavatlar_soni | -0.028 | 0.024 |
| mebel | -0.021 | 0.021 |
SHAP sababiy bog'liqlikni (causality) ko'rsatmaydi
Bu — eng ko'p qilinadigan xato. SHAP sizga "model shu xususiyatga qanday tayandi" deb aytadi. U "o'sha xususiyatni o'zgartirsak natija o'zgaradi" degani EMAS.
Misol: model metro_km ga tayanadi. Lekin kvartirani metroga yaqinlashtirsangiz, u tezroq ijaraga ketishini SHAP isbotlamaydi — u faqat modelning qarorini tushuntiradi.
Sababiylik uchun tajriba kerak: A/B test (Data Analytics kursida) yoki sababiy xulosa usullari.
Mijozga aytganda ham ehtiyot bo'ling: "model sizning e'loningizni metrodan uzoqligi uchun past bahladi" — to'g'ri. "Metroga ko'chsangiz tezroq ijaraga beriladi" — SHAP buni aytmaydi.
Amaliy foydalanish: xato tahlilida
SHAP ning eng kuchli qo'llanilishi — 10-bobdagi xato tahlilini chuqurlashtirish.
bashorat = model.predict(X_te)
xato_mask = (bashorat != y_te.to_numpy())
print(f"Xato qatorlar: {xato_mask.sum()} / {len(y_te)}")
print()
taqq = pd.DataFrame({
    "xususiyat": son,
    "to'g'ri qatorlarda |SHAP|": np.abs(qiymatlar[~xato_mask]).mean(axis=0).round(4),
    "XATO qatorlarda |SHAP|": np.abs(qiymatlar[xato_mask]).mean(axis=0).round(4),
})
taqq["farq"] = (taqq["XATO qatorlarda |SHAP|"] - taqq["to'g'ri qatorlarda |SHAP|"]).round(4)
show(taqq.sort_values("farq", key=abs, ascending=False))
print()
print("Eng katta farqli xususiyat — model aynan unda chalg'iydi.")
Xato qatorlar: 81 / 360


Eng katta farqli xususiyat — model aynan unda chalg'iydi.
| xususiyat | to'g'ri qatorlarda |SHAP| | XATO qatorlarda |SHAP| | farq |
|---|---|---|---|
| maydon_m2 | 0.107 | 0.052 | -0.055 |
| xonalar | 0.096 | 0.073 | -0.023 |
| qavatlar_soni | 0.019 | 0.022 | 0.003 |
| metro_km | 0.013 | 0.016 | 0.002 |
| qavat | 0.013 | 0.012 | -0.001 |
| mebel | 0.004 | 0.004 | 0.001 |
Bu jadval 10-bobdagi "xatolar qaysi guruhda to'plangan" savoliga xususiyat darajasida javob beradi.
Bugun nima o'rgandik
show(pd.DataFrame([
    {"Tushuncha": "Global vs lokal", "Bitta jumla": "Model umuman nimaga qaraydi / bu qator nega shunday"},
    {"Tushuncha": "SHAP g'oyasi", "Bitta jumla": "Bashoratni o'rtachadan farqini adolatli taqsimlash"},
    {"Tushuncha": "Kafolat", "Bitta jumla": "asos + SHAP yig'indisi = AYNAN bashorat"},
    {"Tushuncha": "Belgi", "Bitta jumla": "Musbat — target tomoniga, manfiy — teskari"},
    {"Tushuncha": "TreeExplainer", "Bitta jumla": "Daraxtlar uchun aniq va tez"},
    {"Tushuncha": "KernelExplainer", "Bitta jumla": "Har qanday model, lekin sekin — namuna oling"},
    {"Tushuncha": "Eng katta xato", "Bitta jumla": "SHAP ni SABABIYLIK deb o'qish"},
    {"Tushuncha": "Amaliy foyda", "Bitta jumla": "Xato tahlilini xususiyat darajasiga tushiradi"},
]))
| Tushuncha | Bitta jumla |
|---|---|
| Global vs lokal | Model umuman nimaga qaraydi / bu qator nega shunday |
| SHAP g'oyasi | Bashoratni o'rtachadan farqini adolatli taqsimlash |
| Kafolat | asos + SHAP yig'indisi = AYNAN bashorat |
| Belgi | Musbat — target tomoniga, manfiy — teskari |
| TreeExplainer | Daraxtlar uchun aniq va tez |
| KernelExplainer | Har qanday model, lekin sekin — namuna oling |
| Eng katta xato | SHAP ni SABABIYLIK deb o'qish |
| Amaliy foyda | Xato tahlilini xususiyat darajasiga tushiradi |
Shu bilan 5-qism tugadi. Siz endi modelni yaxshilashning to'rtta yo'lini bilasiz: yangi xususiyat (22), sozlash (23), birlashtirish (24) va tushuntirish (25).
Keyingi qismda target yo'q bo'lgan holatga o'tamiz.
Bu bobni bepul o'qidingiz.
Kitob o'rgatadi, lekin sizning kodingiz nega ishlamaganini ayta olmaydi. Kursda uy vazifangiz tekshiriladi.