PCA: o'lchovni kamaytirish
Sahna: target yo'q
Hozirgacha har doim y bo'lgan. Biz nimanidir bashorat qilardik.
Endi boshqa holat: sizda faqat X bor. Javob yo'q, hech kim yorliq qo'ymagan.
Shunda nima qilish mumkin? Ikki narsa:
- O'lchovni kamaytirish — 100 ustunni 10 ga tushirish, ma'lumotni yo'qotmasdan (bu bob)
- Guruhlash — o'xshash qatorlarni topish (27-bob)
Protokolning 3-qadami
0-bobdagi jadvalda shunday qator bor edi: "Target YO'Q -> Clustering yoki PCA".
Bu — o'sha tarmoq. Protokolning 1-8-qadamlari o'zgarmaydi: faylni ochasiz, ustunlarni tekshirasiz, tozalaysiz. Faqat 9-qadamdan keyin boshqa yo'lga burilasiz.
Muammo: 20-bobdagi o'lchov la'nati
import pandas as pd
import numpy as np

r = np.random.default_rng(42)
print("Ustunlar ko'payganda nima bo'ladi:")
print(f"{'o`lchov':>8} {'eng yaqin masofa':>18} {'eng uzoq':>10} {'nisbat':>8}")
print("-" * 48)
for m in [2, 10, 100, 1000]:
    P = r.normal(size=(400, m))
    d = np.linalg.norm(P[1:] - P[0], axis=1)
    print(f"{m:>8} {d.min():>18.3f} {d.max():>10.3f} {d.max()/d.min():>8.2f}")
Ustunlar ko'payganda nima bo'ladi:
 o`lchov   eng yaqin masofa   eng uzoq   nisbat
------------------------------------------------
       2              0.103      4.301    41.62
      10              1.982      6.687     3.37
     100             11.370     16.832     1.48
    1000             41.602     47.110     1.13
Nisbat 1 ga yaqinlashadi — ya'ni hamma nuqta bir xil uzoqlikda bo'lib qoladi. KNN, SVM, clustering — masofaga tayanadigan hamma narsa buziladi.
Yechim: ortiqcha o'lchovlarni tashlash. Lekin qaysi birini?
PCA g'oyasi: eng ko'p ma'lumot qaysi yo'nalishda
PCA savolni boshqacha qo'yadi. U ustunlarni tashlamaydi — yangi ustunlar yasaydi.
G'oya: ma'lumot eng ko'p tarqalgan yo'nalishni top. Shu yo'nalish eng ko'p ma'lumot tashiydi.
import matplotlib.pyplot as plt
from sklearn.decomposition import PCA
from sklearn.preprocessing import StandardScaler

# ikki o'lchovda ko'rsatamiz — kuzatish uchun
X2 = r.multivariate_normal([0, 0], [[3, 2.4], [2.4, 2.2]], size=300)
p2 = PCA(n_components=2).fit(X2)

rasm, axes = plt.subplots(1, 2, figsize=(13, 5))
axes[0].scatter(X2[:, 0], X2[:, 1], alpha=.45, s=22, color="#1a73e8")
for uz, vek in zip(p2.explained_variance_, p2.components_):
    axes[0].arrow(0, 0, vek[0]*np.sqrt(uz)*2, vek[1]*np.sqrt(uz)*2,
                  width=.06, color="#c5221f", length_includes_head=True)
axes[0].set_title("Asl ma'lumot va asosiy yo'nalishlar", fontweight="bold")
axes[0].set_aspect("equal"); axes[0].grid(alpha=.3)

Xp = p2.transform(X2)
axes[1].scatter(Xp[:, 0], Xp[:, 1], alpha=.45, s=22, color="#137333")
axes[1].axhline(0, color="k", lw=.8); axes[1].axvline(0, color="k", lw=.8)
axes[1].set_xlabel("PC1"); axes[1].set_ylabel("PC2")
axes[1].set_title("PCA dan keyin — o'qlar aylantirildi", fontweight="bold")
axes[1].set_aspect("equal"); axes[1].grid(alpha=.3)
fig("pca_goya.png", caption="Qizil strelkalar — asosiy komponentlar. Uzuni eng ko'p tarqalish yo'nalishi. O'ngda shu yo'nalishlar o'q qilib olingan.")

print("Har bir komponent qancha dispersiyani tushuntiradi:")
for i, v in enumerate(p2.explained_variance_ratio_, 1):
    print(f"  PC{i}: {v:.4f}  ({v:.1%})")
print(f"  Yig'indi: {p2.explained_variance_ratio_.sum():.4f}")
Har bir komponent qancha dispersiyani tushuntiradi:
  PC1: 0.9629  (96.3%)
  PC2: 0.0371  (3.7%)
  Yig'indi: 1.0000
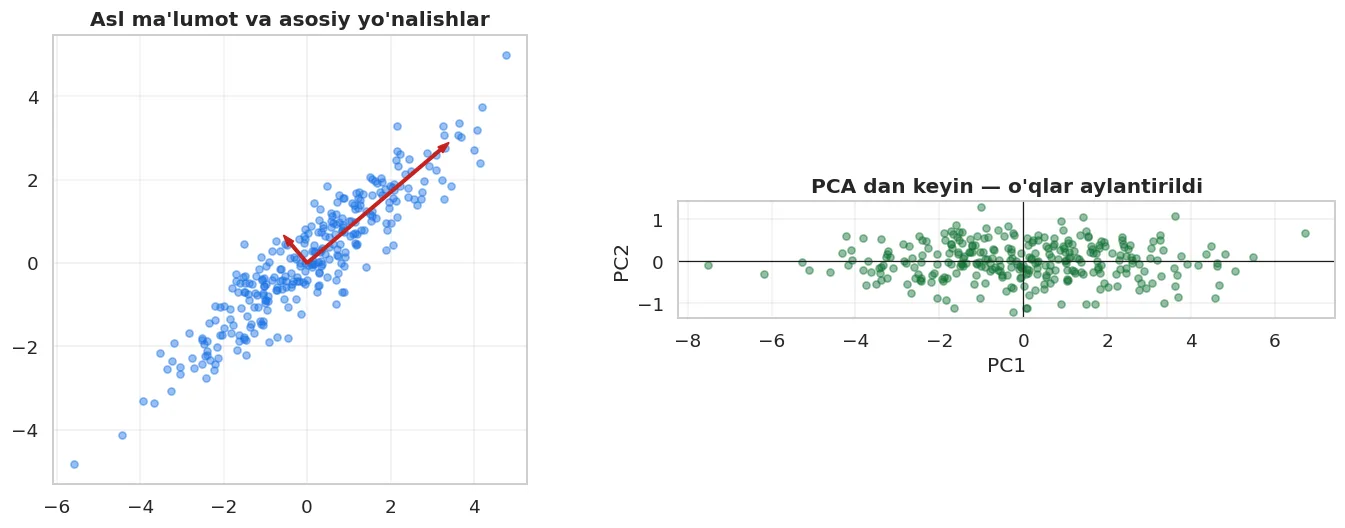
Qizil strelkalar — asosiy komponentlar. Uzuni eng ko'p tarqalish yo'nalishi. O'ngda shu yo'nalishlar o'q qilib olingan.
Birinchi komponent dispersiyaning katta qismini oladi. Agar faqat uni saqlasak, ikki ustundan bittaga tushamiz va ma'lumotning ko'p qismi saqlanadi.
PCA ning ichi: X.T @ X
11-bobda X.T @ X ni ko'rganmiz. PCA aynan shundan boshlanadi.
# qo'lda PCA — kovariatsiya matritsasining xos vektorlari
Xm = X2 - X2.mean(axis=0)
kov = (Xm.T @ Xm) / (len(Xm) - 1)
xos_qiymat, xos_vektor = np.linalg.eigh(kov)
tartib = np.argsort(xos_qiymat)[::-1]
xos_qiymat, xos_vektor = xos_qiymat[tartib], xos_vektor[:, tartib]

print("Qo'lda hisoblangan:")
print(f"  xos qiymatlar : {xos_qiymat.round(4)}")
print(f"  ulushlar      : {(xos_qiymat/xos_qiymat.sum()).round(4)}")
print()
print("sklearn PCA:")
print(f"  dispersiyalar : {p2.explained_variance_.round(4)}")
print(f"  ulushlar      : {p2.explained_variance_ratio_.round(4)}")
print()
print(f"Mos keldimi: {bool(np.allclose(xos_qiymat, p2.explained_variance_))}")
Qo'lda hisoblangan:
  xos qiymatlar : [4.9782 0.1916]
  ulushlar      : [0.9629 0.0371]

sklearn PCA:
  dispersiyalar : [4.9782 0.1916]
  ulushlar      : [0.9629 0.0371]

Mos keldimi: True
PCA — bu kovariatsiya matritsasining xos vektorlari. Yangi matematika yo'q, 11-bobdagi amallar.
Scaling PCA uchun MAJBURIY
df = pd.read_csv(DATA / "uy_ijara.csv")
son = ["xonalar", "maydon_m2", "qavat", "qavatlar_soni", "metro_km", "mebel", "qurilgan_yil"]
from sklearn.impute import SimpleImputer
Xd = SimpleImputer(strategy="median").fit_transform(df[son])

print("Ustunlar dispersiyasi (xom):")
for nom, v in zip(son, Xd.var(axis=0)):
    print(f"  {nom:16s} {v:>12.1f}")
print()
p_xom = PCA().fit(Xd)
p_shk = PCA().fit(StandardScaler().fit_transform(Xd))
print(f"{'komponent':>10} {'scaling YO`Q':>14} {'scaling BOR':>13}")
print("-" * 40)
for i in range(4):
    print(f"{'PC'+str(i+1):>10} {p_xom.explained_variance_ratio_[i]:>14.4f} "
          f"{p_shk.explained_variance_ratio_[i]:>13.4f}")
Ustunlar dispersiyasi (xom):
  xonalar                   1.1
  maydon_m2               405.3
  qavat                    13.0
  qavatlar_soni            18.6
  metro_km                  2.6
  mebel                     0.2
  qurilgan_yil            203.2

 komponent   scaling YO`Q   scaling BOR
----------------------------------------
       PC1         0.6309        0.2781
       PC2         0.3155        0.2312
       PC3         0.0398        0.1479
       PC4         0.0092        0.1406
Scaling yo'q bo'lsa, PC1 deyarli hamma dispersiyani oladi — chunki qurilgan_yil ning dispersiyasi boshqalardan yuzlab barobar katta. PCA shunchaki o'sha ustunni topadi va qolganini ko'rmaydi.
PCA scaling siz ishlamaydi
PCA dispersiyani maksimallashtiradi. Ustunlar har xil birlikda bo'lsa (yil, metr, kilometr), eng katta sonli ustun g'olib bo'ladi — bu uning muhimligi emas, birligi katta bo'lgani uchun.
Shuning uchun PCA har doim StandardScaler dan keyin qo'llanadi. Bu — Ridge/Lasso (16-bob) va KNN (20-bob) bilan bir xil sabab.
Nechta komponent saqlash kerak
Xs = StandardScaler().fit_transform(Xd)
p = PCA().fit(Xs)
jamlangan = np.cumsum(p.explained_variance_ratio_)
jadval = pd.DataFrame({
    "komponent": [f"PC{i}" for i in range(1, len(son)+1)],
    "dispersiya ulushi": p.explained_variance_ratio_.round(4),
    "jamlangan": jamlangan.round(4),
})
show(jadval)
print()
for chegara in [0.80, 0.90, 0.95, 0.99]:
    n = int(np.searchsorted(jamlangan, chegara) + 1)
    print(f"  {chegara:.0%} dispersiya uchun {n} komponent kerak ({len(son)} dan)")
  80% dispersiya uchun 5 komponent kerak (7 dan)
  90% dispersiya uchun 5 komponent kerak (7 dan)
  95% dispersiya uchun 6 komponent kerak (7 dan)
  99% dispersiya uchun 6 komponent kerak (7 dan)
| komponent | dispersiya ulushi | jamlangan |
|---|---|---|
| PC1 | 0.278 | 0.278 |
| PC2 | 0.231 | 0.509 |
| PC3 | 0.148 | 0.657 |
| PC4 | 0.141 | 0.798 |
| PC5 | 0.138 | 0.936 |
| PC6 | 0.055 | 0.992 |
| PC7 | 0.009 | 1 |
rasm, axes = plt.subplots(1, 2, figsize=(13, 4.5))
axes[0].bar(range(1, len(son)+1), p.explained_variance_ratio_, color="#1a73e8", alpha=.85)
axes[0].set_xlabel("Komponent"); axes[0].set_ylabel("Dispersiya ulushi")
axes[0].set_title("Scree plot — 'tirsak' qayerda", fontweight="bold")
axes[0].grid(alpha=.3, axis="y")

axes[1].plot(range(1, len(son)+1), jamlangan, "o-", lw=2, color="#137333")
for ch in [0.90, 0.95]:
    axes[1].axhline(ch, ls="--", color="gray", lw=1)
    axes[1].text(len(son)*0.6, ch+0.008, f"{ch:.0%}", fontsize=9, color="gray")
axes[1].set_xlabel("Komponentlar soni"); axes[1].set_ylabel("Jamlangan dispersiya")
axes[1].set_title("Qancha saqlasak yetarli", fontweight="bold")
axes[1].grid(alpha=.3)
fig("scree.png", caption="Chapda: har komponentning ulushi, 'tirsak' nuqtasi qidiriladi. O'ngda: jamlangan ulush — 90% yoki 95% chegara tanlanadi.")
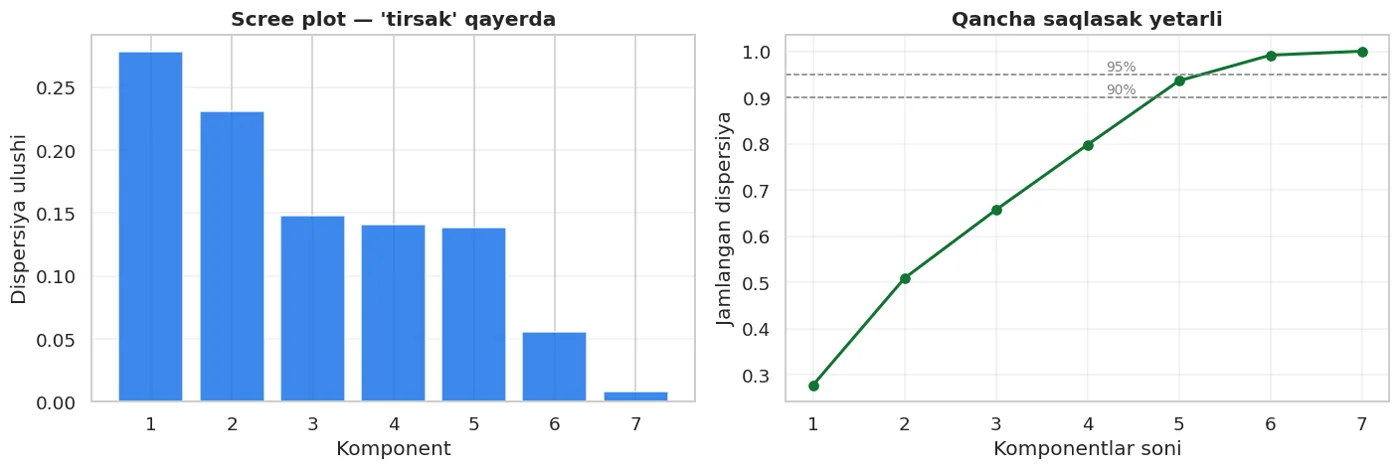
Chapda: har komponentning ulushi, 'tirsak' nuqtasi qidiriladi. O'ngda: jamlangan ulush — 90% yoki 95% chegara tanlanadi.
sklearn da chegarani to'g'ridan-to'g'ri berish mumkin:
for ch in [0.90, 0.95]:
    pc = PCA(n_components=ch).fit(Xs)
    print(f"  PCA(n_components={ch}) -> {pc.n_components_} komponent saqladi")
  PCA(n_components=0.9) -> 5 komponent saqladi
  PCA(n_components=0.95) -> 6 komponent saqladi
PCA model natijasini yaxshilaydimi? O'lchaymiz
from sklearn.model_selection import cross_val_score
from sklearn.pipeline import Pipeline
from sklearn.linear_model import LogisticRegression
from sklearn.neighbors import KNeighborsClassifier

y = df["ijaraga_berildi_30k"]
Xf = df[son]

print(f"{'variant':<40} {'CV F1':>9} {'±':>8}")
print("-" * 60)
for nom, qadamlar in [
    ("Logistic, PCA YO'Q", [("i", SimpleImputer(strategy="median")), ("sc", StandardScaler()),
                            ("m", LogisticRegression(max_iter=3000))]),
    ("Logistic, PCA(0.95)", [("i", SimpleImputer(strategy="median")), ("sc", StandardScaler()),
                             ("p", PCA(n_components=0.95)), ("m", LogisticRegression(max_iter=3000))]),
    ("Logistic, PCA(2 komponent)", [("i", SimpleImputer(strategy="median")), ("sc", StandardScaler()),
                                    ("p", PCA(n_components=2)), ("m", LogisticRegression(max_iter=3000))]),
    ("KNN, PCA YO'Q", [("i", SimpleImputer(strategy="median")), ("sc", StandardScaler()),
                       ("m", KNeighborsClassifier(n_neighbors=15))]),
    ("KNN, PCA(0.95)", [("i", SimpleImputer(strategy="median")), ("sc", StandardScaler()),
                        ("p", PCA(n_components=0.95)), ("m", KNeighborsClassifier(n_neighbors=15))]),
]:
    b = cross_val_score(Pipeline(qadamlar), Xf, y, cv=5, scoring="f1")
    print(f"{nom:<40} {b.mean():>9.4f} {b.std():>8.4f}")
variant                                      CV F1        ±
------------------------------------------------------------
Logistic, PCA YO'Q                          0.7219   0.0106
Logistic, PCA(0.95)                         0.7251   0.0105
Logistic, PCA(2 komponent)                  0.7302   0.0091
KNN, PCA YO'Q                               0.7010   0.0162
KNN, PCA(0.95)                              0.7098   0.0184
PCA aniqlikni oshirish uchun emas — lekin kamaytirmaydi ham
Men bu bo'limni "PCA foyda bermaydi, ba'zan zarar qiladi" deb yozgan edim. O'lchov buni tasdiqlamadi.
Jadvalga qarang: hamma PCA varianti bazadan teng yoki bir oz yuqori chiqdi. Farqlar tarqalish ichida, ya'ni ishonchli emas — lekin zarar ham ko'rinmadi.
Eng qiziq natija esa PCA(2 komponent) qatorida: 7 ustundan 5 tasini tashlab, model natijasi pasaymadi.
Bu nimani anglatadi? Bizning 7 ustun aslida 7 ta mustaqil ma'lumot tashimaydi. xonalar va maydon_m2 korrelyatsiyasi 0.94 (3-bob), qavat va qavatlar_soni ham bog'liq. PCA shu takrorlanishni siqib tashladi.
Demak PCA ning haqiqiy roli — aniqlikni oshirish emas, ortiqchalikni olib tashlash. U quyidagilar uchun foydali:
- Ustunlar juda ko'p (yuzlab, minglab) va ular o'zaro bog'liq
- Vizualizatsiya — 50 o'lchovni 2 ga tushirib ko'rish
- Tezlik — o'qitishni tezlashtirish
- Shovqinni kamaytirish — oxirgi komponentlar ko'pincha shovqin
Va yana bir dars: men "zarar qiladi" degan taxminni yozdim, keyin o'lchadim va u rad etildi. Har bir "ba'zan shunday bo'ladi" degan jumlani o'lchang — aks holda u faqat taxmin bo'lib qoladi.
PCA haqiqatan ishlaydigan holat: ko'p ustun
r2 = np.random.default_rng(7)
# 150 ustun, lekin ular 8 ta yashirin omilning kombinatsiyasi
yashirin = r2.normal(size=(len(Xf), 8))
aralashtirish = r2.normal(size=(8, 150))
X_kop = pd.DataFrame(yashirin @ aralashtirish + r2.normal(scale=.4, size=(len(Xf), 150)),
                     columns=[f"u{i}" for i in range(150)])
# target yashirin omillardan hosil qilinadi
y_kop = ((yashirin @ r2.normal(size=8) + r2.normal(scale=.5, size=len(Xf))) > 0).astype(int)

import time
print(f"{'variant':<34} {'CV F1':>9} {'±':>8} {'vaqt':>8}")
print("-" * 62)
for nom, qadamlar in [
    ("150 ustun, PCA YO'Q", [("sc", StandardScaler()), ("m", LogisticRegression(max_iter=3000))]),
    ("PCA(0.95)", [("sc", StandardScaler()), ("p", PCA(n_components=0.95)),
                   ("m", LogisticRegression(max_iter=3000))]),
    ("PCA(8 komponent)", [("sc", StandardScaler()), ("p", PCA(n_components=8)),
                          ("m", LogisticRegression(max_iter=3000))]),
]:
    t0 = time.perf_counter()
    b = cross_val_score(Pipeline(qadamlar), X_kop, y_kop, cv=5, scoring="f1")
    dt = time.perf_counter() - t0
    print(f"{nom:<34} {b.mean():>9.4f} {b.std():>8.4f} {dt:>7.2f}s")
print()
pk = PCA(n_components=0.95).fit(StandardScaler().fit_transform(X_kop))
print(f"PCA(0.95) 150 ustundan {pk.n_components_} komponent qoldirdi")
variant                                CV F1        ±     vaqt
--------------------------------------------------------------
150 ustun, PCA YO'Q                   0.9393   0.0111    0.12s
PCA(0.95)                             0.9443   0.0068    0.08s
PCA(8 komponent)                      0.9443   0.0068    1.40s

PCA(0.95) 150 ustundan 8 komponent qoldirdi
Mana bu yerda PCA ishlaydi: 150 ustun aslida 8 ta yashirin omildan hosil bo'lgan, va PCA ularni topdi.
Vizualizatsiya: PCA ning eng ishonchli foydasi
from sklearn.preprocessing import LabelEncoder
pg = pd.read_csv(DATA / "penguins.csv")
pson = ["bill_length_mm", "bill_depth_mm", "flipper_length_mm", "body_mass_g"]
Xpg = SimpleImputer(strategy="median").fit_transform(pg[pson])
Xpg = StandardScaler().fit_transform(Xpg)
tur = pg.species.values

p_pg = PCA(n_components=2).fit(Xpg)
Z = p_pg.transform(Xpg)

rasm, ax = plt.subplots(figsize=(8.5, 5.5))
for t, rang in zip(["Adelie", "Gentoo", "Chinstrap"], ["#1a73e8", "#137333", "#c5221f"]):
    mask = tur == t
    ax.scatter(Z[mask, 0], Z[mask, 1], label=t, alpha=.7, s=30, color=rang)
ax.set_xlabel(f"PC1 ({p_pg.explained_variance_ratio_[0]:.1%})")
ax.set_ylabel(f"PC2 ({p_pg.explained_variance_ratio_[1]:.1%})")
ax.set_title("4 o'lchovli ma'lumot 2 o'lchovda", fontweight="bold")
ax.legend(); ax.grid(alpha=.3)
fig("pca_penguins.png", caption="To'rtta o'lchov ikkiga tushirildi va sinflar hali ham ajralib turadi. PCA target ni KO'RMAGAN — u faqat dispersiyaga qaradi.")

print(f"PC1 va PC2 birgalikda dispersiyaning {p_pg.explained_variance_ratio_.sum():.1%} ini tushuntiradi")
PC1 va PC2 birgalikda dispersiyaning 88.2% ini tushuntiradi
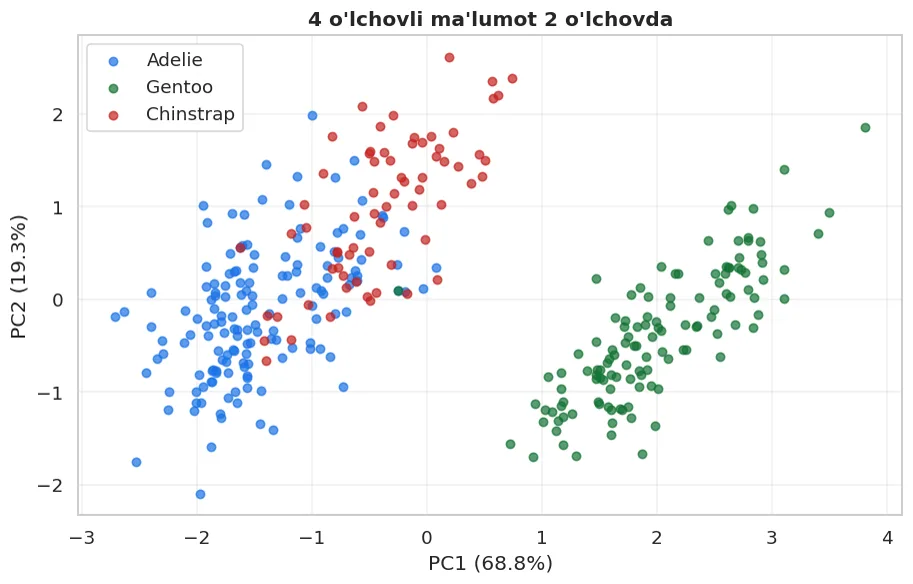
To'rtta o'lchov ikkiga tushirildi va sinflar hali ham ajralib turadi. PCA target ni KO'RMAGAN — u faqat dispersiyaga qaradi.
Diqqat: PCA species ni ko'rmagan. U faqat to'rtta o'lchovga qaradi — va sinflar baribir ajralib chiqdi. Bu ma'lumotda haqiqiy tuzilma borligini ko'rsatadi.
Komponentlar nimadan tuzilgan
yuk = pd.DataFrame(p_pg.components_.T, columns=["PC1", "PC2"], index=pson).round(3)
show(yuk.reset_index().rename(columns={"index": "xususiyat"}))
print()
print("PC1 ga eng ko'p hissa qo'shgan xususiyat:",
      pson[int(np.argmax(np.abs(p_pg.components_[0])))])
PC1 ga eng ko'p hissa qo'shgan xususiyat: flipper_length_mm
| xususiyat | PC1 | PC2 |
|---|---|---|
| bill_length_mm | 0.455 | 0.597 |
| bill_depth_mm | -0.4 | 0.798 |
| flipper_length_mm | 0.576 | 0.002 |
| body_mass_g | 0.548 | 0.084 |
PCA komponentlari tushunarsiz bo'ladi
PC1 = 0.45*bill_length - 0.40*bill_depth + 0.58*flipper + 0.55*mass — bu nimani anglatadi?
Hech narsani. Bu shunchaki matematik kombinatsiya. Siz uni mijozga tushuntirib berolmaysiz.
Shuning uchun tushuntirish kerak bo'lgan loyihalarda (bank, tibbiyot) PCA dan ehtiyot bo'ling: model aniqligi saqlanadi, lekin 25-bobdagi SHAP tahlili ma'nosini yo'qotadi — siz PC3 ning ta'sirini tushuntirolmaysiz.
Variantlar
show(pd.DataFrame([
    {"Usul": "PCA", "Chiziqlimi": "HA", "Qachon": "Umumiy holat, tez",
     "Kamchiligi": "Chiziqsiz tuzilmani ko'rmaydi"},
    {"Usul": "TruncatedSVD", "Chiziqlimi": "HA", "Qachon": "Siyrak matritsa (matn, TF-IDF)",
     "Kamchiligi": "Markazlashtirmaydi"},
    {"Usul": "t-SNE", "Chiziqlimi": "YO'Q", "Qachon": "FAQAT vizualizatsiya",
     "Kamchiligi": "transform() yo'q — yangi nuqta qo'shilmaydi"},
    {"Usul": "UMAP", "Chiziqlimi": "YO'Q", "Qachon": "Vizualizatsiya, tezroq",
     "Kamchiligi": "Alohida kutubxona"},
]))
| Usul | Chiziqlimi | Qachon | Kamchiligi |
|---|---|---|---|
| PCA | HA | Umumiy holat, tez | Chiziqsiz tuzilmani ko'rmaydi |
| TruncatedSVD | HA | Siyrak matritsa (matn, TF-IDF) | Markazlashtirmaydi |
| t-SNE | YO'Q | FAQAT vizualizatsiya | transform() yo'q — yangi nuqta qo'shilmaydi |
| UMAP | YO'Q | Vizualizatsiya, tezroq | Alohida kutubxona |
t-SNE ni model quvuriga qo'ymang
t-SNE chiroyli rasm chizadi va talabalar uni PCA o'rniga ishlatmoqchi bo'ladi.
Lekin t-SNE da transform() yo'q — u faqat fit_transform() ni biladi. Ya'ni yangi qator kelganda uni o'sha fazoga joylashtirib bo'lmaydi.
Demak t-SNE ni Pipeline ichida model oldidan ishlatish mumkin emas. U faqat ko'z bilan tekshirish uchun.
Bugun nima o'rgandik
show(pd.DataFrame([
    {"Tushuncha": "Vazifa", "Bitta jumla": "Target yo'q — ma'lumotning o'zidan tuzilma topish"},
    {"Tushuncha": "PCA g'oyasi", "Bitta jumla": "Eng ko'p dispersiyali yo'nalishlarni o'q qilib olish"},
    {"Tushuncha": "Ichi", "Bitta jumla": "Kovariatsiya matritsasining xos vektorlari (11-bob)"},
    {"Tushuncha": "Scaling", "Bitta jumla": "MAJBURIY — aks holda katta birlikli ustun g'olib"},
    {"Tushuncha": "Nechta komponent", "Bitta jumla": "Jamlangan dispersiya 90-95% bo'lgan joy"},
    {"Tushuncha": "Aniqlikka ta'siri", "Bitta jumla": "Ko'pincha YO'Q yoki manfiy — PCA ma'lumot yo'qotadi"},
    {"Tushuncha": "Qachon foydali", "Bitta jumla": "Ustunlar juda ko'p, vizualizatsiya, tezlik"},
    {"Tushuncha": "Narxi", "Bitta jumla": "Komponentlar tushuntirilmaydi — SHAP ma'nosini yo'qotadi"},
]))
| Tushuncha | Bitta jumla |
|---|---|
| Vazifa | Target yo'q — ma'lumotning o'zidan tuzilma topish |
| PCA g'oyasi | Eng ko'p dispersiyali yo'nalishlarni o'q qilib olish |
| Ichi | Kovariatsiya matritsasining xos vektorlari (11-bob) |
| Scaling | MAJBURIY — aks holda katta birlikli ustun g'olib |
| Nechta komponent | Jamlangan dispersiya 90-95% bo'lgan joy |
| Aniqlikka ta'siri | Ko'pincha YO'Q yoki manfiy — PCA ma'lumot yo'qotadi |
| Qachon foydali | Ustunlar juda ko'p, vizualizatsiya, tezlik |
| Narxi | Komponentlar tushuntirilmaydi — SHAP ma'nosini yo'qotadi |
Keyingi bobda: o'lchovni kamaytirdik. Endi qatorlarni guruhlarga bo'lamiz.
Bu bobni bepul o'qidingiz.
Kitob o'rgatadi, lekin sizning kodingiz nega ishlamaganini ayta olmaydi. Kursda uy vazifangiz tekshiriladi.