LDA: target ni biladigan o'lchov kamaytirish
Sahna: PCA target ni ko'rmaydi
26-bobda PCA ni ko'rdik. U ma'lumotning eng tarqalgan yo'nalishini topadi.
Lekin bitta savol javobsiz qoldi: eng tarqalgan yo'nalish — eng foydali yo'nalishmi?
Javob: shart emas. PCA y ni ko'rmaydi, shuning uchun u sinflarni ajratishga harakat ham qilmaydi.
LDA (Linear Discriminant Analysis) aynan shu bo'shliqni to'ldiradi: u y ni biladi va sinflarni eng yaxshi ajratadigan yo'nalishni izlaydi.
Farqni ko'rish
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
from sklearn.decomposition import PCA
from sklearn.discriminant_analysis import LinearDiscriminantAnalysis as LDA
from sklearn.preprocessing import StandardScaler

# sun'iy misol: sinflar bitta yo'nalishda ajralgan, lekin tarqalish BOSHQA yo'nalishda
r = np.random.default_rng(3)
n = 300
x1 = r.normal(0, 4, n)                     # katta tarqalish — PCA shuni tanlaydi
x2 = r.normal(0, 0.6, n)                   # kichik tarqalish, LEKIN sinflar shu bo'yicha ajralgan
y_s = (x2 > 0).astype(int)
x2 = x2 + y_s * 1.4                        # sinflarni x2 bo'yicha ajratamiz
Xs_misol = np.c_[x1, x2]

p1 = PCA(n_components=1).fit(Xs_misol)
l1 = LDA(n_components=1).fit(Xs_misol, y_s)

rasm, axes = plt.subplots(1, 3, figsize=(16, 4.4))
for t, rang in [(0, "#c5221f"), (1, "#137333")]:
    m = y_s == t
    axes[0].scatter(Xs_misol[m, 0], Xs_misol[m, 1], s=18, alpha=.6, color=rang, label=f"sinf {t}")
o = np.array([-10, 10])
axes[0].plot(o * p1.components_[0, 0], o * p1.components_[0, 1], "b-", lw=2.5, label="PCA yo'nalishi")
lv = l1.scalings_[:, 0] / np.linalg.norm(l1.scalings_[:, 0])
axes[0].plot(o * lv[0], o * lv[1], "m-", lw=2.5, label="LDA yo'nalishi")
axes[0].set_xlim(-14, 14); axes[0].set_ylim(-4, 5)
axes[0].legend(fontsize=8); axes[0].set_title("Ikki yo'nalish", fontweight="bold")
axes[0].grid(alpha=.3)

for ax, Z, nom in [(axes[1], p1.transform(Xs_misol), "PCA proyeksiyasi"),
                   (axes[2], l1.transform(Xs_misol), "LDA proyeksiyasi")]:
    for t, rang in [(0, "#c5221f"), (1, "#137333")]:
        ax.hist(Z[y_s == t, 0], bins=28, alpha=.65, color=rang, label=f"sinf {t}")
    ax.set_title(nom, fontweight="bold"); ax.legend(fontsize=8); ax.grid(alpha=.3)
fig("pca_vs_lda.png", caption="PCA eng tarqalgan yo'nalishni oldi va sinflar ARALASHDI. LDA kichikroq tarqalishli yo'nalishni oldi, lekin sinflar AJRALDI.")
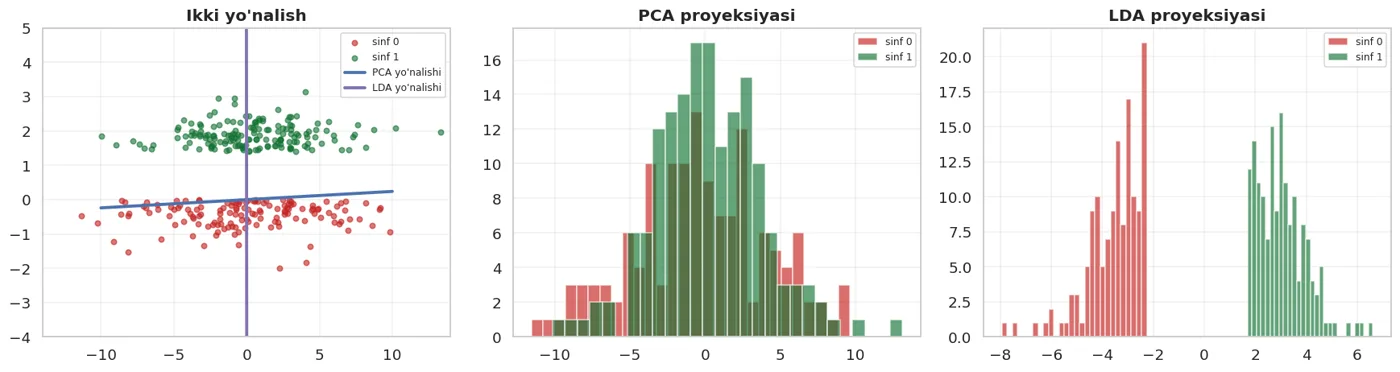
PCA eng tarqalgan yo'nalishni oldi va sinflar ARALASHDI. LDA kichikroq tarqalishli yo'nalishni oldi, lekin sinflar AJRALDI.
Mana farq. PCA eng tarqalgan yo'nalishni tanladi va sinflarni aralashtirib yubordi. LDA esa tarqalishi kichikroq, lekin sinflarni ajratadigan yo'nalishni topdi.
from sklearn.model_selection import cross_val_score
from sklearn.pipeline import Pipeline
from sklearn.linear_model import LogisticRegression

print("Bitta komponentga tushirib, keyin klassifikatsiya:")
for nom, kam in [("PCA(1)", PCA(n_components=1)), ("LDA(1)", LDA(n_components=1))]:
    b = cross_val_score(Pipeline([("sc", StandardScaler()), ("k", kam),
                                  ("m", LogisticRegression())]), Xs_misol, y_s, cv=5)
    print(f"  {nom}: accuracy = {b.mean():.4f} ±{b.std():.4f}")
Bitta komponentga tushirib, keyin klassifikatsiya:
  PCA(1): accuracy = 0.8500 ±0.0506
  LDA(1): accuracy = 1.0000 ±0.0000
LDA ning ikki yuzi
LDA chalkash, chunki u ikki xil ish qiladi va sklearn da bitta klassda:
show(pd.DataFrame([
    {"Roli": "1. O'lchov kamaytirish", "Metod": "transform()",
     "Nima qiladi": "Sinflarni ajratadigan yo'nalishlarga proyeksiya",
     "Taqqoslanadi": "PCA bilan (26-bob)"},
    {"Roli": "2. Klassifikator", "Metod": "predict()",
     "Nima qiladi": "Sinf markazlariga qarab bashorat",
     "Taqqoslanadi": "LogisticRegression bilan (15-bob)"},
]))
| Roli | Metod | Nima qiladi | Taqqoslanadi |
|---|---|---|---|
| 1. O'lchov kamaytirish | transform() | Sinflarni ajratadigan yo'nalishlarga proyeksiya | PCA bilan (26-bob) |
| 2. Klassifikator | predict() | Sinf markazlariga qarab bashorat | LogisticRegression bilan (15-bob) |
df = pd.read_csv(DATA / "penguins.csv")
pson = ["bill_length_mm", "bill_depth_mm", "flipper_length_mm", "body_mass_g"]
from sklearn.impute import SimpleImputer
Xp = SimpleImputer(strategy="median").fit_transform(df[pson])
yp = df.species.values

l = LDA().fit(Xp, yp)
print("LDA ikkala ishni ham bajaradi:")
print(f"  transform() -> {l.transform(Xp).shape}  (4 ustundan {l.transform(Xp).shape[1]} ga)")
print(f"  predict()   -> {l.predict(Xp[:5])}")
print(f"  score()     -> {l.score(Xp, yp):.4f}")
LDA ikkala ishni ham bajaradi:
  transform() -> (344, 2)  (4 ustundan 2 ga)
  predict()   -> ['Adelie' 'Adelie' 'Adelie' 'Adelie' 'Adelie']
  score()     -> 0.9855
LDA komponentlari soni CHEKLANGAN
PCA da n_components ustunlar soniga teng bo'lishi mumkin. LDA da esa qattiq chegara bor:
Pingvinlarda 3 sinf bor, shuning uchun LDA maksimum 2 komponent beradi — 4 ustun bo'lsa ham.
Binary classification da esa (bizning ijaraga_berildi_30k) LDA faqat 1 komponent beradi. Ya'ni 7 ustunni bittaga tushiradi.
print("Chegarani tekshiramiz:")
for n in [1, 2, 3]:
    try:
        LDA(n_components=n).fit(Xp, yp)
        print(f"  n_components={n}: ishladi")
    except Exception as e:
        print(f"  n_components={n}: {type(e).__name__} -> {str(e)[:66]}")
print()
y_bin = pd.read_csv(DATA / "uy_ijara.csv")["ijaraga_berildi_30k"]
Xb = SimpleImputer(strategy="median").fit_transform(
    pd.read_csv(DATA / "uy_ijara.csv")[["xonalar", "maydon_m2", "qavat", "qavatlar_soni",
                                        "metro_km", "mebel", "qurilgan_yil"]])
l_bin = LDA().fit(Xb, y_bin)
print(f"Binary target, 7 ustun -> LDA {l_bin.transform(Xb).shape[1]} komponent beradi")
Chegarani tekshiramiz:
  n_components=1: ishladi
  n_components=2: ishladi
  n_components=3: ValueError -> n_components cannot be larger than min(n_features, n_classes - 1).

Binary target, 7 ustun -> LDA 1 komponent beradi
Vizualizatsiyada PCA va LDA
Xp_s = StandardScaler().fit_transform(Xp)
Zp = PCA(n_components=2).fit_transform(Xp_s)
Zl = LDA(n_components=2).fit(Xp_s, yp).transform(Xp_s)

rasm, axes = plt.subplots(1, 2, figsize=(13.5, 5))
for Z, ax, nom in [(Zp, axes[0], "PCA (y ni ko'rmagan)"), (Zl, axes[1], "LDA (y ni bilgan)")]:
    for t, rang in zip(["Adelie", "Gentoo", "Chinstrap"], ["#1a73e8", "#137333", "#c5221f"]):
        m = yp == t
        ax.scatter(Z[m, 0], Z[m, 1], s=26, alpha=.7, color=rang, label=t)
    ax.set_xlabel("1-komponent"); ax.set_ylabel("2-komponent")
    ax.set_title(nom, fontweight="bold"); ax.legend(fontsize=8); ax.grid(alpha=.3)
fig("lda_penguins.png", caption="Ikkisi ham 4 o'lchovni 2 ga tushirdi. LDA da sinflar zichroq va aniqroq ajralgan — chunki u aynan shunga intilgan.")
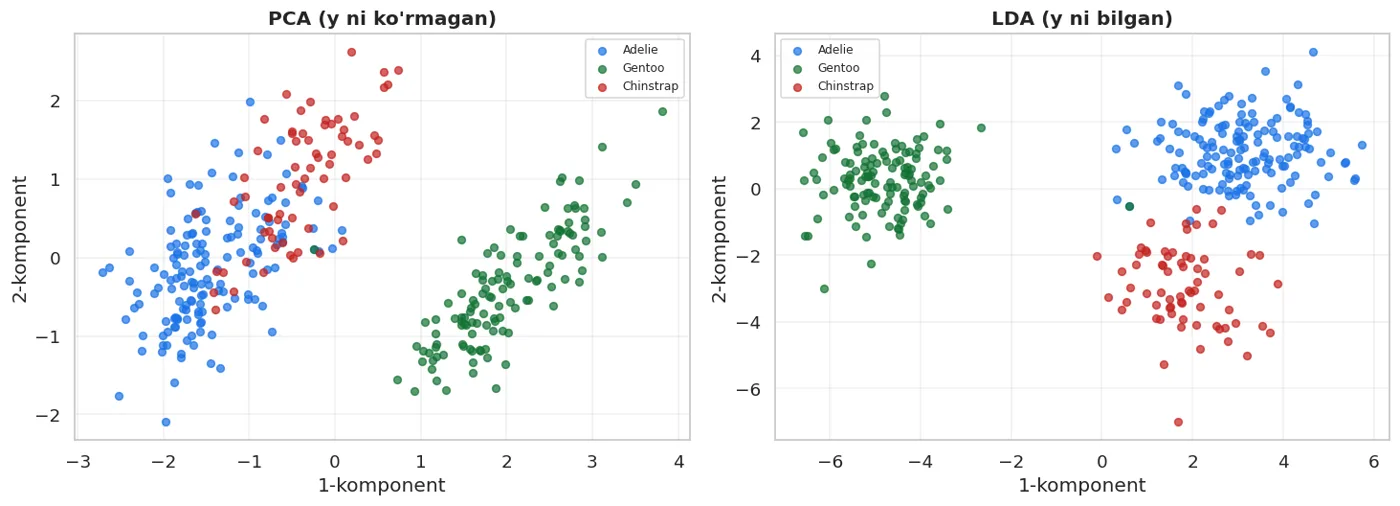
Ikkisi ham 4 o'lchovni 2 ga tushirdi. LDA da sinflar zichroq va aniqroq ajralgan — chunki u aynan shunga intilgan.
LDA ning chiroyli rasmi sizni aldashi mumkin
LDA grafigida sinflar PCA dagidan har doim yaxshiroq ajralgan ko'rinadi. Bu LDA ning afzalligi emas — u shunga o'qitilgan.
Agar siz LDA proyeksiyasini butun ma'lumotda hisoblab, keyin uni modelning sifatini ko'rsatish uchun ishlatsangiz — bu leakage (5-bob). LDA y ni ko'rgan.
Shuning uchun: LDA ni vizualizatsiya uchun ishlatish mumkin, lekin "qarang, sinflar qanday ajralgan" degan xulosa chiqarishdan ehtiyot bo'ling. U Pipeline ichida, CV bilan o'lchanishi kerak.
print("Isbot — LDA ni butun ma'lumotda hisoblash vs Pipeline ichida:")
# NOTO'G'RI: LDA butun ma'lumotda
Z_yomon = LDA(n_components=2).fit(Xp_s, yp).transform(Xp_s)
b_yomon = cross_val_score(LogisticRegression(max_iter=2000), Z_yomon, yp, cv=5)
# TO'G'RI: LDA Pipeline ichida
b_yaxshi = cross_val_score(Pipeline([("sc", StandardScaler()), ("l", LDA(n_components=2)),
                                     ("m", LogisticRegression(max_iter=2000))]), Xp, yp, cv=5)
print(f"  LDA butun ma'lumotda (leakage): {b_yomon.mean():.4f} ±{b_yomon.std():.4f}")
print(f"  LDA Pipeline ichida (to'g'ri) : {b_yaxshi.mean():.4f} ±{b_yaxshi.std():.4f}")
Isbot — LDA ni butun ma'lumotda hisoblash vs Pipeline ichida:
  LDA butun ma'lumotda (leakage): 0.9884 ±0.0109
  LDA Pipeline ichida (to'g'ri) : 0.9854 ±0.0131
LDA klassifikator sifatida
from sklearn.discriminant_analysis import QuadraticDiscriminantAnalysis as QDA
from sklearn.naive_bayes import GaussianNB
from sklearn.ensemble import RandomForestClassifier
import time

print(f"{'model':<34} {'CV accuracy':>13} {'±':>8} {'vaqt':>8}")
print("-" * 68)
for nom, m in [
    ("LDA", LDA()),
    ("QDA", QDA()),
    ("LogisticRegression (15-bob)", LogisticRegression(max_iter=3000)),
    ("GaussianNB (20-bob)", GaussianNB()),
    ("RandomForest (18-bob)", RandomForestClassifier(n_estimators=200, random_state=42)),
]:
    t0 = time.perf_counter()
    b = cross_val_score(Pipeline([("i", SimpleImputer(strategy="median")),
                                  ("sc", StandardScaler()), ("m", m)]), df[pson], yp, cv=5)
    dt = time.perf_counter() - t0
    print(f"{nom:<34} {b.mean():>13.4f} {b.std():>8.4f} {dt:>7.2f}s")
model                                CV accuracy        ±     vaqt
--------------------------------------------------------------------
LDA                                       0.9796   0.0150    0.01s
QDA                                       0.9825   0.0109    0.01s
LogisticRegression (15-bob)               0.9854   0.0131    0.02s
GaussianNB (20-bob)                       0.9651   0.0117    0.01s
RandomForest (18-bob)                     0.9709   0.0131    0.51s
Pingvinlar dataseti oson (42-bobda ko'rganmiz), shuning uchun hamma model yuqori natija beradi.
LDA, QDA va Naive Bayes — bitta oilaning uch a'zosi
Uchtasi ham bir xil g'oyadan chiqadi: har sinf uchun taqsimot modellashtiriladi, keyin Bayes teoremasi qo'llanadi. Farq — taqsimot haqidagi taxminda.
show(pd.DataFrame([
    {"Model": "GaussianNB", "Taxmini": "Har xususiyat mustaqil (kovariatsiya diagonal)",
     "Chegarasi": "Egri", "Parametrlar soni": "Eng kam"},
    {"Model": "LDA", "Taxmini": "Hamma sinf BIR XIL kovariatsiyaga ega",
     "Chegarasi": "CHIZIQLI", "Parametrlar soni": "O'rtacha"},
    {"Model": "QDA", "Taxmini": "Har sinf O'Z kovariatsiyasiga ega",
     "Chegarasi": "Kvadratik (egri)", "Parametrlar soni": "Eng ko'p"},
]))
| Model | Taxmini | Chegarasi | Parametrlar soni |
|---|---|---|---|
| GaussianNB | Har xususiyat mustaqil (kovariatsiya diagonal) | Egri | Eng kam |
| LDA | Hamma sinf BIR XIL kovariatsiyaga ega | CHIZIQLI | O'rtacha |
| QDA | Har sinf O'Z kovariatsiyasiga ega | Kvadratik (egri) | Eng ko'p |
# chegara shaklini ko'rsatamiz — ikki xususiyatda
X2d = SimpleImputer(strategy="median").fit_transform(df[["bill_length_mm", "flipper_length_mm"]])
X2d = StandardScaler().fit_transform(X2d)

rasm, axes = plt.subplots(1, 3, figsize=(16, 4.4))
xx, yy = np.meshgrid(np.linspace(X2d[:, 0].min()-.5, X2d[:, 0].max()+.5, 200),
                     np.linspace(X2d[:, 1].min()-.5, X2d[:, 1].max()+.5, 200))
panjara = np.c_[xx.ravel(), yy.ravel()]
kod = pd.Categorical(yp).codes
for ax, (nom, m) in zip(axes, [("GaussianNB", GaussianNB()), ("LDA", LDA()), ("QDA", QDA())]):
    m.fit(X2d, kod)
    Zg = m.predict(panjara).reshape(xx.shape)
    ax.contourf(xx, yy, Zg, alpha=.22, cmap="viridis")
    ax.scatter(X2d[:, 0], X2d[:, 1], c=kod, cmap="viridis", s=16, alpha=.8, edgecolors="k", linewidths=.2)
    ax.set_title(f"{nom}  (accuracy {m.score(X2d, kod):.3f})", fontweight="bold")
    ax.set_xlabel("bill_length"); ax.grid(alpha=.3)
axes[0].set_ylabel("flipper_length")
fig("lda_qda_chegara.png", caption="LDA chegaralari to'g'ri chiziq. QDA egri chiziq chizadi, chunki har sinfga o'z kovariatsiyasi ruxsat etilgan.")
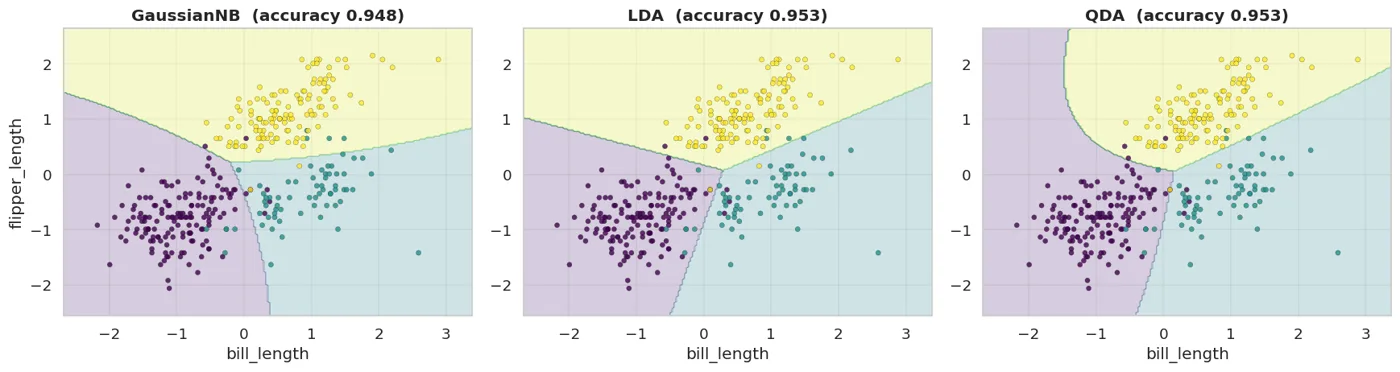
LDA chegaralari to'g'ri chiziq. QDA egri chiziq chizadi, chunki har sinfga o'z kovariatsiyasi ruxsat etilgan.
QDA kichik ma'lumotda yiqilmaydi — JIM ravishda yodlab oladi
Men bu bo'limni "QDA kichik sinfda ishlamaydi, Singular matrix xatosi beradi" deb yozgan edim. O'lchadim — tasdiqlanmadi, va haqiqat xavfliroq.
QDA har sinf uchun alohida kovariatsiya matritsasini baholaydi. Sinfda qator kamayganda u xato bermaydi — shunchaki o'sha qatorlarni yodlab oladi.
Pastdagi jadval shuni ko'rsatadi.
import warnings
from sklearn.model_selection import train_test_split

X2d_t = X2d
r3 = np.random.default_rng(0)
print(f"{'sinfda qator':>13} {'QDA train':>10} {'QDA test':>9} {'LDA test':>9} {'ogohlantirish':>14}")
print("-" * 60)
for n_s in [60, 20, 8, 4]:
    idx = []
    for cls in np.unique(kod):
        m = np.where(kod == cls)[0]
        idx.extend(r3.choice(m, min(n_s, len(m)), replace=False))
    idx = np.array(idx)
    Xk, yk = X2d_t[idx], kod[idx]
    tr, te, ytr, yte = train_test_split(Xk, yk, test_size=.4, random_state=42, stratify=yk)
    with warnings.catch_warnings(record=True) as w:
        warnings.simplefilter("always")
        q = QDA().fit(tr, ytr)
        n_ogoh = len(w)
    lq = LDA().fit(tr, ytr)
    print(f"{n_s:>13} {q.score(tr, ytr):>10.3f} {q.score(te, yte):>9.3f} "
          f"{lq.score(te, yte):>9.3f} {n_ogoh:>14}")
 sinfda qator  QDA train  QDA test  LDA test  ogohlantirish
------------------------------------------------------------
           60      0.935     0.931     0.944              0
           20      0.917     0.917     0.958              0
            8      0.929     0.600     1.000              0
            4      0.286     0.400     1.000              2
Jadvalni qator-qator o'qing:
- 60 va 20 qator: QDA va LDA deyarli bir xil, train va test yaqin. Hammasi yaxshi.
- 8 qator: QDA train da 0.929, test da esa 0.600. Ya'ni u yodlab oldi. Va diqqat qiling — ogohlantirish nol. Hech narsa sizga xato qilayotganingizni aytmaydi.
- 4 qator: QDA butunlay buziladi (train 0.286 — tasodifdan ham yomon) va faqat shu yerda ogohlantirish chiqaradi.
LDA esa hamma holatda barqaror qoladi, chunki u bitta umumiy kovariatsiya matritsasini baholaydi — ya'ni hamma sinfning qatorlarini birgalikda ishlatadi.
Xato bermaslik — "to'g'ri ishlayapti" degani EMAS
Bu — kitobdagi takrorlanadigan mavzu. 0-bobda leakage xato bermadi. 5-bobda StandardScaler butun ma'lumotda xato bermadi. Bu yerda QDA kichik sinfda xato bermadi.
Uchtasida ham kod ishlaydi, raqam chiqadi, va u yolg'on.
Himoya bitta: train va test ballini yonma-yon ko'rish. Yuqoridagi jadvalda 8-qatorda farq 0.33 — bu darhol ko'zga tashlanadi. Faqat test ballini ko'rsangiz, hech narsa sezmaysiz.
Qoida: sinfdagi qatorlar soni ustunlar sonidan kamida 10 barobar ko'p bo'lmasa, QDA ni ishlatmang. LDA yoki GaussianNB ni oling.
Qachon LDA tanlanadi
show(pd.DataFrame([
    {"Holat": "Vizualizatsiya, sinflar ajralishini ko'rish", "Tanlov": "LDA transform (lekin leakage ga ehtiyot)"},
    {"Holat": "Ustunlar ko'p, sinflar kam", "Tanlov": "LDA — o'lchovni n_classes-1 ga tushiradi"},
    {"Holat": "Tez va oddiy klassifikator kerak", "Tanlov": "LDA — parametrsiz, sozlash kerak emas"},
    {"Holat": "Chegarasi chiziqsiz", "Tanlov": "QDA yoki daraxt (17-bob)"},
    {"Holat": "Ma'lumot kam", "Tanlov": "LDA (QDA emas)"},
    {"Holat": "Ehtimollik kerak", "Tanlov": "LDA ham, LogisticRegression ham beradi"},
]))
| Holat | Tanlov |
|---|---|
| Vizualizatsiya, sinflar ajralishini ko'rish | LDA transform (lekin leakage ga ehtiyot) |
| Ustunlar ko'p, sinflar kam | LDA — o'lchovni n_classes-1 ga tushiradi |
| Tez va oddiy klassifikator kerak | LDA — parametrsiz, sozlash kerak emas |
| Chegarasi chiziqsiz | QDA yoki daraxt (17-bob) |
| Ma'lumot kam | LDA (QDA emas) |
| Ehtimollik kerak | LDA ham, LogisticRegression ham beradi |
LDA ning kamdan-kam eslanadigan afzalligi
LDA da sozlanadigan parametr yo'q. alpha, C, max_depth, n_estimators — hech biri.
Ya'ni 23-bobdagi GridSearchCV unga kerak emas. Bu — tez baza model sifatida juda qulay: bir qatorda yozasiz, natija olasiz, va keyin murakkabroq modellar shundan oshadimi deb tekshirasiz.
6-bobdagi baza ketma-ketligiga uni ham qo'shing: DummyClassifier -> LDA -> LogisticRegression -> murakkab modellar.
PCA va LDA yonma-yon
show(pd.DataFrame([
    {"": "PCA", "y ni ko'radimi": "YO'Q (unsupervised)",
     "Nimani maksimallashtiradi": "Dispersiya", "Komponentlar chegarasi": "n_features gacha",
     "Leakage xavfi": "Yo'q (y ishlatmaydi)"},
    {"": "LDA", "y ni ko'radimi": "HA (supervised)",
     "Nimani maksimallashtiradi": "Sinflar ajralishi", "Komponentlar chegarasi": "n_classes - 1",
     "Leakage xavfi": "BOR — Pipeline ichida ishlatish shart"},
]))
| y ni ko'radimi | Nimani maksimallashtiradi | Komponentlar chegarasi | Leakage xavfi | |
|---|---|---|---|---|
| PCA | YO'Q (unsupervised) | Dispersiya | n_features gacha | Yo'q (y ishlatmaydi) |
| LDA | HA (supervised) | Sinflar ajralishi | n_classes - 1 | BOR — Pipeline ichida ishlatish shart |
print("Bizning binary ma'lumotda ikkisini taqqoslaymiz:")
Xd = pd.read_csv(DATA / "uy_ijara.csv")
sond = ["xonalar", "maydon_m2", "qavat", "qavatlar_soni", "metro_km", "mebel", "qurilgan_yil"]
Xf, yf = Xd[sond], Xd["ijaraga_berildi_30k"]
print(f"{'variant':<40} {'CV F1':>9} {'±':>8}")
print("-" * 60)
for nom, qadamlar in [
    ("Kamaytirish YO'Q (7 ustun)", [("i", SimpleImputer(strategy="median")), ("sc", StandardScaler()),
                                    ("m", LogisticRegression(max_iter=3000))]),
    ("PCA(2)", [("i", SimpleImputer(strategy="median")), ("sc", StandardScaler()),
                ("k", PCA(n_components=2)), ("m", LogisticRegression(max_iter=3000))]),
    ("LDA(1) — binary da maksimum", [("i", SimpleImputer(strategy="median")), ("sc", StandardScaler()),
                                     ("k", LDA(n_components=1)), ("m", LogisticRegression(max_iter=3000))]),
]:
    b = cross_val_score(Pipeline(qadamlar), Xf, yf, cv=5, scoring="f1")
    print(f"{nom:<40} {b.mean():>9.4f} {b.std():>8.4f}")
Bizning binary ma'lumotda ikkisini taqqoslaymiz:
variant                                      CV F1        ±
------------------------------------------------------------
Kamaytirish YO'Q (7 ustun)                  0.7219   0.0106
PCA(2)                                      0.7302   0.0091
LDA(1) — binary da maksimum                 0.7245   0.0101
Bugun nima o'rgandik
show(pd.DataFrame([
    {"Tushuncha": "PCA va LDA farqi", "Bitta jumla": "PCA dispersiyani, LDA sinflar ajralishini maksimallashtiradi"},
    {"Tushuncha": "LDA ning ikki yuzi", "Bitta jumla": "transform() — kamaytirish, predict() — klassifikator"},
    {"Tushuncha": "Komponentlar chegarasi", "Bitta jumla": "n_classes - 1; binary da faqat 1"},
    {"Tushuncha": "Leakage xavfi", "Bitta jumla": "LDA y ni ko'radi — Pipeline ichida ishlatish SHART"},
    {"Tushuncha": "LDA / QDA / GaussianNB", "Bitta jumla": "Bir oila; farq kovariatsiya taxminida"},
    {"Tushuncha": "QDA cheklovi", "Bitta jumla": "Har sinfda qator kam bo'lsa yiqiladi"},
    {"Tushuncha": "LDA afzalligi", "Bitta jumla": "Sozlanadigan parametr YO'Q — tez baza model"},
]))
| Tushuncha | Bitta jumla |
|---|---|
| PCA va LDA farqi | PCA dispersiyani, LDA sinflar ajralishini maksimallashtiradi |
| LDA ning ikki yuzi | transform() — kamaytirish, predict() — klassifikator |
| Komponentlar chegarasi | n_classes - 1; binary da faqat 1 |
| Leakage xavfi | LDA y ni ko'radi — Pipeline ichida ishlatish SHART |
| LDA / QDA / GaussianNB | Bir oila; farq kovariatsiya taxminida |
| QDA cheklovi | Har sinfda qator kam bo'lsa yiqiladi |
| LDA afzalligi | Sozlanadigan parametr YO'Q — tez baza model |
Shu bilan 6-qism tugadi. Siz endi yorliqsiz ma'lumot bilan ishlashni bilasiz: o'lchovni kamaytirish (26), guruhlash (27) va target ni hisobga olgan kamaytirish (28).
Keyingi qism — chuqur o'rganish.
Bu bobni bepul o'qidingiz.
Kitob o'rgatadi, lekin sizning kodingiz nega ishlamaganini ayta olmaydi. Kursda uy vazifangiz tekshiriladi.