Keras bilan amalda
Sahna: 29-bobdagi 40 qator
29-bobda tarmoqni noldan yozdik — 40 qator kod. Forward, backward, gradient, yangilash.
Keras da xuddi shu narsa besh qator bo'ladi.
Bu bob kutubxonadan qanday foydalanishni o'rgatadi. Lekin diqqat: 29 va 30-boblarni o'tkazib yubormang. Keras ni ishlatish oson, uning nega ishlamayotganini tushunish esa faqat ichini bilsangiz mumkin.
Birinchi model: besh qator
import os
os.environ["CUDA_VISIBLE_DEVICES"] = "-1"       # CPU — takrorlanishi uchun
os.environ["TF_CPP_MIN_LOG_LEVEL"] = "3"
import numpy as np
import pandas as pd
import tensorflow as tf
from tensorflow import keras

tf.random.set_seed(42)
np.random.seed(42)
tf.config.threading.set_intra_op_parallelism_threads(2)
print(f"TensorFlow {tf.__version__}  |  Keras {keras.__version__}")
print(f"Qurilma: {'GPU' if tf.config.list_physical_devices('GPU') else 'CPU'}")
TensorFlow 2.20.0  |  Keras 3.12.0
Qurilma: CPU
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
from sklearn.impute import SimpleImputer

df = pd.read_csv(DATA / "uy_ijara.csv")
son = ["xonalar", "maydon_m2", "qavat", "qavatlar_soni", "metro_km", "mebel", "qurilgan_yil"]
X = SimpleImputer(strategy="median").fit_transform(df[son])
y = df["ijaraga_berildi_30k"].to_numpy(dtype="float32")

X_tr, X_te, y_tr, y_te = train_test_split(X, y, test_size=0.3, random_state=42, stratify=y)
sc = StandardScaler().fit(X_tr)
X_tr, X_te = sc.transform(X_tr).astype("float32"), sc.transform(X_te).astype("float32")

model = keras.Sequential([
    keras.layers.Input(shape=(X_tr.shape[1],)),
    keras.layers.Dense(16, activation="relu"),
    keras.layers.Dense(1, activation="sigmoid"),
])
model.compile(optimizer="adam", loss="binary_crossentropy", metrics=["accuracy"])
tarix = model.fit(X_tr, y_tr, epochs=40, batch_size=32, verbose=0,
                  validation_split=0.2)
yoq, aniq = model.evaluate(X_te, y_te, verbose=0)
print(f"Test yo'qotish: {yoq:.4f}   Test aniqlik: {aniq:.4f}")
Test yo'qotish: 0.5128 Test aniqlik: 0.7667
Besh qator. 29-bobdagi 40 qator bilan bir xil ish.
Sequential ning tuzilishi
model.summary(print_fn=lambda s: print(" " + s))
  Model: "sequential"
┏━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━┳━━━━━━━━━━━━━━━━━━━━━━━━┳━━━━━━━━━━━━━━━┓
┃ Layer (type)                    ┃ Output Shape           ┃       Param # ┃
┡━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━╇━━━━━━━━━━━━━━━━━━━━━━━━╇━━━━━━━━━━━━━━━┩
│ dense (Dense)                   │ (None, 16)             │           128 │
├─────────────────────────────────┼────────────────────────┼───────────────┤
│ dense_1 (Dense)                 │ (None, 1)              │            17 │
└─────────────────────────────────┴────────────────────────┴───────────────┘
 Total params: 437 (1.71 KB)
 Trainable params: 145 (580.00 B)
 Non-trainable params: 0 (0.00 B)
 Optimizer params: 292 (1.14 KB)
Param # ustunini tekshiramiz — 11-bobdagi matritsa shakllari bilan:
n_kirish = X_tr.shape[1]
print(f"1-qatlam: Dense(16)")
print(f"  W shakli: ({n_kirish}, 16) -> {n_kirish * 16} parametr")
print(f"  b shakli: (16,)            -> 16 parametr")
print(f"  jami: {n_kirish * 16 + 16}")
print()
print(f"2-qatlam: Dense(1)")
print(f"  W: (16, 1) -> 16  |  b: (1,) -> 1  |  jami: 17")
print()
print(f"Umumiy: {n_kirish * 16 + 16 + 17}")
print(f"model.count_params(): {model.count_params()}")
1-qatlam: Dense(16)
  W shakli: (7, 16) -> 112 parametr
  b shakli: (16,)            -> 16 parametr
  jami: 128

2-qatlam: Dense(1)
  W: (16, 1) -> 16  |  b: (1,) -> 1  |  jami: 17

Umumiy: 145
model.count_params(): 145
Uchta qadam: build, compile, fit
show(pd.DataFrame([
    {"Qadam": "1. Qurish (build)", "Nima qilinadi": "Qatlamlar va ularning shakli",
     "Kodda": "keras.Sequential([...])"},
    {"Qadam": "2. Kompilyatsiya", "Nima qilinadi": "Optimizer, yo'qotish, metrikalar",
     "Kodda": "model.compile(...)"},
    {"Qadam": "3. O'qitish (fit)", "Nima qilinadi": "Ma'lumot, epoxalar, batch",
     "Kodda": "model.fit(...)"},
]))
| Qadam | Nima qilinadi | Kodda |
|---|---|---|
| 1. Qurish (build) | Qatlamlar va ularning shakli | keras.Sequential([...]) |
| 2. Kompilyatsiya | Optimizer, yo'qotish, metrikalar | model.compile(...) |
| 3. O'qitish (fit) | Ma'lumot, epoxalar, batch | model.fit(...) |
Eng ko'p xato qilinadigan joy — chiqish qatlami va yo'qotish funksiyasi juftligi:
show(pd.DataFrame([
    {"Vazifa": "Binary classification", "Chiqish qatlami": "Dense(1, activation='sigmoid')",
     "loss": "binary_crossentropy", "metrics": "accuracy, AUC"},
    {"Vazifa": "Multiclass (3+ sinf)", "Chiqish qatlami": "Dense(n_sinf, activation='softmax')",
     "loss": "sparse_categorical_crossentropy", "metrics": "accuracy"},
    {"Vazifa": "Multilabel (bir nechta yorliq)", "Chiqish qatlami": "Dense(n, activation='sigmoid')",
     "loss": "binary_crossentropy", "metrics": "accuracy"},
    {"Vazifa": "Regression", "Chiqish qatlami": "Dense(1) — activation YO'Q",
     "loss": "mse yoki mae", "metrics": "mae, RootMeanSquaredError"},
]))
| Vazifa | Chiqish qatlami | loss | metrics |
|---|---|---|---|
| Binary classification | Dense(1, activation='sigmoid') | binary_crossentropy | accuracy, AUC |
| Multiclass (3+ sinf) | Dense(n_sinf, activation='softmax') | sparse_categorical_crossentropy | accuracy |
| Multilabel (bir nechta yorliq) | Dense(n, activation='sigmoid') | binary_crossentropy | accuracy |
| Regression | Dense(1) — activation YO'Q | mse yoki mae | mae, RootMeanSquaredError |
`softmax` + `binary_crossentropy` — jim xato
Bu juftlik xato bermaydi, kod ishlaydi, lekin model o'rganmaydi yoki juda yomon o'rganadi.
Qoida: sigmoid -> binary_crossentropy. softmax -> categorical_crossentropy. Regression -> activation yo'q + mse.
Va yana bitta: sparse_categorical_crossentropy yorliqlar butun son bo'lsa (0, 1, 2), categorical_crossentropy esa one-hot bo'lsa. Chalkashtirsangiz shakl xatosi chiqadi.
print("Regression masalasi — uchta variant:")
yn = df["narx_usd"].to_numpy(dtype="float32")
Xn_tr, Xn_te, yn_tr, yn_te = train_test_split(X, yn, test_size=0.3, random_state=42)
scn = StandardScaler().fit(Xn_tr)
Xn_tr, Xn_te = scn.transform(Xn_tr).astype("float32"), scn.transform(Xn_te).astype("float32")

print(f"  (o'rtacha narx {yn.mean():.0f} USD — MAE shundan ANCHA past bo'lishi shart)")
print()
print(f"{'variant':<34} {'epoxa':>6} {'test MAE':>10}")
print("-" * 54)
for nom, oxirgi, ep in [
    ("Dense(1) — to'g'ri, kam epoxa", keras.layers.Dense(1), 30),
    ("Dense(1) — to'g'ri, yetarli epoxa", keras.layers.Dense(1), 400),
    ("Dense(1, 'sigmoid') — XATO", keras.layers.Dense(1, activation="sigmoid"), 400),
]:
    tf.random.set_seed(42)
    m = keras.Sequential([keras.layers.Input(shape=(Xn_tr.shape[1],)),
                          keras.layers.Dense(32, activation="relu"), oxirgi])
    m.compile(optimizer="adam", loss="mse", metrics=["mae"])
    m.fit(Xn_tr, yn_tr, epochs=ep, batch_size=32, verbose=0)
    _, mae = m.evaluate(Xn_te, yn_te, verbose=0)
    print(f"{nom:<34} {ep:>6} {mae:>10.1f}")
Regression masalasi — uchta variant:
  (o'rtacha narx 776 USD — MAE shundan ANCHA past bo'lishi shart)

variant                             epoxa   test MAE
------------------------------------------------------
Dense(1) — to'g'ri, kam epoxa          30      721.6
Dense(1) — to'g'ri, yetarli epoxa     400       71.3
Dense(1, 'sigmoid') — XATO            400      785.7
Jadval ikkita darsni beradi, va men birinchisini dastlab o'tkazib yuborgandim.
1-dars: kam epoxa ham xatoga o'xshaydi. To'g'ri arxitektura 30 epoxada o'rtacha narxga yaqin MAE beradi — ya'ni model hali hech narsa o'rganmagan. 400 epoxada esa MAE o'n barobardan ko'proq tushadi va 14-bobdagi Ridge natijasiga yaqinlashadi.
Ya'ni men "sigmoid yomon" demoqchi bo'lib, aslida ikkala modelni ham yetarli o'qitmagandim — va farq kichik ko'rinib qoldi.
2-dars: sigmoid esa hech qachon tuzalmaydi. 400 epoxada ham uning MAE si o'rtacha narx darajasida qoladi. Sabab aniq: sigmoid chiqishni 0 va 1 orasiga siqadi, narx esa 225 dan 1515 gacha. Model qancha o'qisa ham o'sha oraliqqa yetib bormaydi.
Yomon natija ikki xil sababdan bo'ladi — ularni ajratish kerak
Yuqoridagi uch qator buni ko'rsatadi:
| Sabab | Belgisi | Yechimi |
|---|---|---|
| Kam o'qitilgan | train yo'qotish hali tushib boryapti | Ko'proq epoxa, kattaroq lr |
| Arxitektura xato | train yo'qotish to'xtagan, lekin baland | Chiqish qatlami/loss ni tuzatish |
Ajratish usuli: train yo'qotish grafigiga qarang. Agar u hali pasayib borsa — vaqt kerak. Agar yassilangan bo'lsa-yu natija yomon bo'lsa — tuzilmada xato.
Men bu farqni tekshirmasdan xulosa chiqardim. 10-bobdagi qoida bu yerda ham amal qiladi: avval diagnoz, keyin harakat.
Keras raqamlari har safar BIR OZ boshqacha chiqadi
Yuqoridagi jadvalni ikki marta ishga tushirsangiz, MAE qiymatlari bir xil bo'lmaydi — odatda 1-2% farq qiladi.
Men buni o'lchab tekshirdim: tf.random.set_seed(42), np.random.seed(42) va hatto tf.config.experimental.enable_op_determinism() bilan ham TensorFlow bir xil natija bermadi.
PyTorch esa (30-bob) torch.manual_seed(42) bilan to'liq takrorlanadi — olti kasr xonasigacha bir xil.
Buning amaliy natijasi bor va u bu kitobga ham tegishli: shu bobdagi aniq raqamlarni matnga ko'chirmadim. Jadvalga qarang — u har qurishda qaytadan hisoblanadi. Matnda esa faqat yo'nalish yozilgan ("o'n barobar tushadi"), aniq son emas.
Siz ham shunday qiling: Keras natijasini hisobotga yozganda bitta son emas, bir necha urinishning o'rtachasi va tarqalishi ni bering (9-bobdagi qoida).
Callback lar: o'qitishni boshqarish
tf.random.set_seed(42)
model2 = keras.Sequential([
    keras.layers.Input(shape=(X_tr.shape[1],)),
    keras.layers.Dense(64, activation="relu"),
    keras.layers.Dropout(0.3),
    keras.layers.Dense(32, activation="relu"),
    keras.layers.Dense(1, activation="sigmoid"),
])
model2.compile(optimizer=keras.optimizers.Adam(1e-3),
               loss="binary_crossentropy", metrics=["accuracy"])

callbacklar = [
    keras.callbacks.EarlyStopping(monitor="val_loss", patience=15, restore_best_weights=True),
    keras.callbacks.ReduceLROnPlateau(monitor="val_loss", factor=0.3, patience=7, min_lr=1e-5),
]
t2 = model2.fit(X_tr, y_tr, epochs=300, batch_size=32, verbose=0,
                validation_split=0.2, callbacks=callbacklar)
print(f"Ruxsat berilgan epoxalar : 300")
print(f"Early stopping to'xtatdi : {len(t2.history['loss'])} epoxada")
print(f"Eng yaxshi val_loss      : {min(t2.history['val_loss']):.4f}")
yoq2, aniq2 = model2.evaluate(X_te, y_te, verbose=0)
print(f"Test aniqlik             : {aniq2:.4f}")
Ruxsat berilgan epoxalar : 300
Early stopping to'xtatdi : 18 epoxada
Eng yaxshi val_loss      : 0.6325
Test aniqlik             : 0.7639
show(pd.DataFrame([
    {"Callback": "EarlyStopping", "Nima qiladi": "val_loss yaxshilanmasa to'xtatadi",
     "Muhim parametr": "patience, restore_best_weights=True"},
    {"Callback": "ReduceLROnPlateau", "Nima qiladi": "Plato da learning rate ni kamaytiradi",
     "Muhim parametr": "factor, patience"},
    {"Callback": "ModelCheckpoint", "Nima qiladi": "Eng yaxshi modelni diskka saqlaydi",
     "Muhim parametr": "save_best_only=True"},
    {"Callback": "TensorBoard", "Nima qiladi": "Grafiklarni jurnalga yozadi",
     "Muhim parametr": "log_dir"},
]))
| Callback | Nima qiladi | Muhim parametr |
|---|---|---|
| EarlyStopping | val_loss yaxshilanmasa to'xtatadi | patience, restore_best_weights=True |
| ReduceLROnPlateau | Plato da learning rate ni kamaytiradi | factor, patience |
| ModelCheckpoint | Eng yaxshi modelni diskka saqlaydi | save_best_only=True |
| TensorBoard | Grafiklarni jurnalga yozadi | log_dir |
`restore_best_weights=True` ni unutmang
EarlyStopping sukut bo'yicha oxirgi vaznlarni qoldiradi — ya'ni patience epoxa davomida yomonlashgan model.
restore_best_weights=True esa eng yaxshi epoxaga qaytaradi. Bu deyarli har doim kerak, lekin sukut bo'yicha o'chirilgan.
O'qitish egri chiziqlari — eng muhim diagnostika
import matplotlib.pyplot as plt

rasm, axes = plt.subplots(1, 2, figsize=(13.5, 4.6))
axes[0].plot(t2.history["loss"], lw=2, label="train", color="#1a73e8")
axes[0].plot(t2.history["val_loss"], lw=2, label="validation", color="#c5221f")
axes[0].set_xlabel("Epoxa"); axes[0].set_ylabel("Yo'qotish")
axes[0].set_title("Yo'qotish", fontweight="bold"); axes[0].legend(); axes[0].grid(alpha=.3)

axes[1].plot(t2.history["accuracy"], lw=2, label="train", color="#1a73e8")
axes[1].plot(t2.history["val_accuracy"], lw=2, label="validation", color="#c5221f")
axes[1].set_xlabel("Epoxa"); axes[1].set_ylabel("Aniqlik")
axes[1].set_title("Aniqlik", fontweight="bold"); axes[1].legend(); axes[1].grid(alpha=.3)
fig("keras_tarix.png", caption="Ikki chiziq ajralib ketsa — overfitting. Yonma-yon borsa — yaxshi.")

oxir_farq = t2.history["val_loss"][-1] - t2.history["loss"][-1]
print(f"Oxirgi epoxada val_loss - loss = {oxir_farq:+.4f}")
print("Diagnoz:", "overfitting belgisi" if oxir_farq > 0.1 else "chiziqlar yaqin — yaxshi")
Oxirgi epoxada val_loss - loss = +0.0956
Diagnoz: chiziqlar yaqin — yaxshi
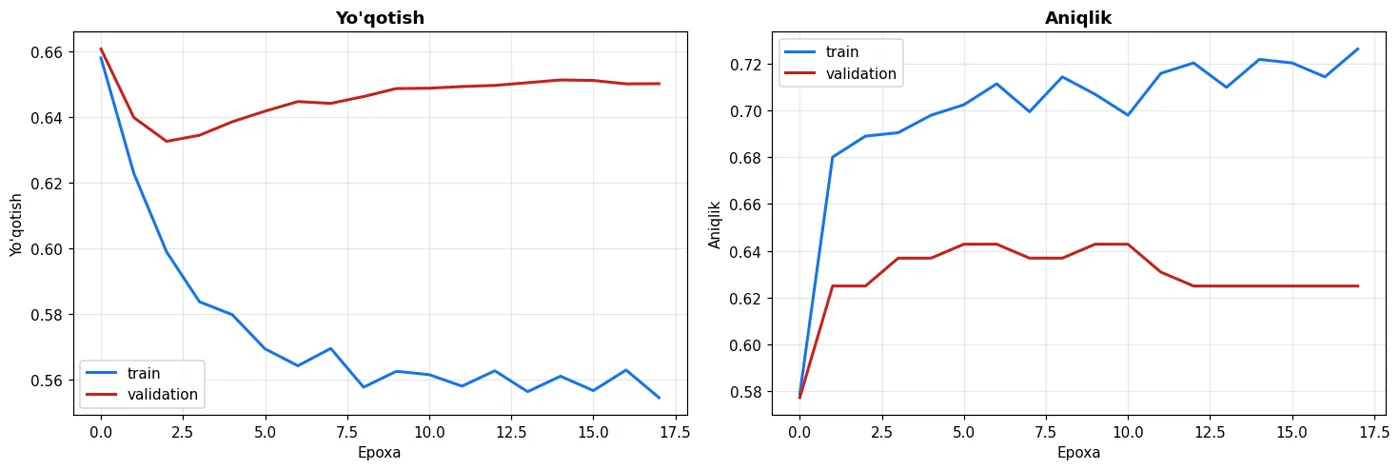
Ikki chiziq ajralib ketsa — overfitting. Yonma-yon borsa — yaxshi.
Bu grafik 10-bobdagi learning curve bilan bir xil g'oyada: train va validation ni yonma-yon ko'rish.
Functional API: tarmoq chiziq bo'lmasa
Sequential faqat chiziqli ketma-ketlikni biladi. Ikki kirish yoki ikki chiqish kerak bo'lsa — Functional API.
tf.random.set_seed(42)
kirish = keras.layers.Input(shape=(X_tr.shape[1],), name="xususiyatlar")
h = keras.layers.Dense(32, activation="relu")(kirish)
h = keras.layers.Dense(16, activation="relu")(h)
chiqish_sinf = keras.layers.Dense(1, activation="sigmoid", name="tez_ketadi")(h)
chiqish_narx = keras.layers.Dense(1, name="narx")(h)

ikki_chiqish = keras.Model(kirish, [chiqish_sinf, chiqish_narx])
ikki_chiqish.compile(
    optimizer="adam",
    loss={"tez_ketadi": "binary_crossentropy", "narx": "mse"},
    loss_weights={"tez_ketadi": 1.0, "narx": 0.0001},
    metrics={"tez_ketadi": "accuracy", "narx": "mae"},
)
yn_tr2 = df["narx_usd"].to_numpy(dtype="float32")[
    train_test_split(np.arange(len(df)), test_size=0.3, random_state=42, stratify=y)[0]]
t3 = ikki_chiqish.fit(X_tr, {"tez_ketadi": y_tr, "narx": yn_tr2},
                      epochs=40, batch_size=32, verbose=0, validation_split=0.2)
natija = ikki_chiqish.evaluate(X_te, {"tez_ketadi": y_te,
                                      "narx": df["narx_usd"].to_numpy(dtype="float32")[
                                          train_test_split(np.arange(len(df)), test_size=0.3,
                                                           random_state=42, stratify=y)[1]]},
                              verbose=0, return_dict=True)
print("Bitta tarmoq, IKKI vazifa:")
for k, v in natija.items():
    print(f"  {k:28s} {v:.4f}")
Bitta tarmoq, IKKI vazifa:
  loss                         3.5646
  narx_loss                    29570.5137
  narx_mae                     145.7609
  tez_ketadi_accuracy          0.7500
  tez_ketadi_loss              0.5337
Bitta tarmoq ikki narsani bir vaqtda o'rgandi: kvartira tez ketadimi va narxi qancha. Yashirin qatlamlar ikkisiga ham xizmat qiladi.
Functional API qachon kerak
- Bir nechta kirish (masalan rasm + matn)
- Bir nechta chiqish (yuqoridagi misol)
- Qatlamlarni bo'lish yoki birlashtirish (ResNet dagi skip connection)
- Transfer learning — oldingi modelning o'rtasidan ulanish
Sequential oddiy holatlar uchun qoladi.
tf.data: ma'lumotni samarali uzatish
import time
paket = 64
ds_tr = (tf.data.Dataset.from_tensor_slices((X_tr, y_tr))
         .shuffle(1000, seed=42).batch(paket).prefetch(tf.data.AUTOTUNE))
ds_te = tf.data.Dataset.from_tensor_slices((X_te, y_te)).batch(paket)

tf.random.set_seed(42)
m4 = keras.Sequential([keras.layers.Input(shape=(X_tr.shape[1],)),
                       keras.layers.Dense(32, activation="relu"),
                       keras.layers.Dense(1, activation="sigmoid")])
m4.compile(optimizer="adam", loss="binary_crossentropy", metrics=["accuracy"])
t0 = time.perf_counter(); m4.fit(ds_tr, epochs=30, verbose=0); dt_ds = time.perf_counter()-t0
print(f"tf.data bilan    : {dt_ds:.1f}s, test aniqlik {m4.evaluate(ds_te, verbose=0)[1]:.4f}")

tf.random.set_seed(42)
m5 = keras.Sequential([keras.layers.Input(shape=(X_tr.shape[1],)),
                       keras.layers.Dense(32, activation="relu"),
                       keras.layers.Dense(1, activation="sigmoid")])
m5.compile(optimizer="adam", loss="binary_crossentropy", metrics=["accuracy"])
t0 = time.perf_counter(); m5.fit(X_tr, y_tr, batch_size=paket, epochs=30, verbose=0); dt_np = time.perf_counter()-t0
print(f"numpy massiv bilan: {dt_np:.1f}s, test aniqlik {m5.evaluate(X_te, y_te, verbose=0)[1]:.4f}")
print()
print("Kichik ma'lumotda farq yo'q. tf.data katta ma'lumotda kerak:")
print("  - hammasi xotiraga sig'masa (diskdan oqimli o'qish)")
print("  - rasm augmentatsiyasi kerak bo'lsa")
print("  - prefetch bilan GPU kutib turmasligi uchun")
tf.data bilan    : 0.5s, test aniqlik 0.7806
numpy massiv bilan: 1.0s, test aniqlik 0.7750

Kichik ma'lumotda farq yo'q. tf.data katta ma'lumotda kerak:
  - hammasi xotiraga sig'masa (diskdan oqimli o'qish)
  - rasm augmentatsiyasi kerak bo'lsa
  - prefetch bilan GPU kutib turmasligi uchun
Modelni saqlash va yuklash
yol = ISH / "model.keras"
model2.save(yol)
print(f"Saqlandi: {yol.name}  ({yol.stat().st_size / 1024:.0f} KB)")

yuklangan = keras.models.load_model(yol)
a1 = model2.predict(X_te[:5], verbose=0).ravel()
a2 = yuklangan.predict(X_te[:5], verbose=0).ravel()
print(f"Asl model bashorati    : {a1.round(5)}")
print(f"Yuklangan model        : {a2.round(5)}")
print(f"Aynan bir xilmi        : {bool(np.allclose(a1, a2))}")
Saqlandi: model.keras  (58 KB)
Asl model bashorati    : [0.39834 0.74787 0.5355  0.23477 0.83576]
Yuklangan model        : [0.39834 0.74787 0.5355  0.23477 0.83576]
Aynan bir xilmi        : True
Model saqlansa, `StandardScaler` saqlanmaydi
model.save() faqat tarmoqni saqlaydi. Scaler, imputer, encoder — ularning hech biri ichida yo'q.
Serverda model noto'g'ri shkalada ma'lumot olsa, bashoratlari ma'nosiz bo'ladi — va xato bermaydi.
Yechim: tozalash qadamlarini alohida saqlash (joblib.dump(scaler, ...)) yoki normallashtirishni tarmoq ichiga qo'yish — keras.layers.Normalization.
39-bobda shu masalaga qaytamiz.
import joblib
sc_yol = ISH / "scaler.joblib"
joblib.dump(sc, sc_yol)
print(f"Scaler alohida saqlandi: {sc_yol.name} ({sc_yol.stat().st_size} bayt)")
print()
# yoki normallashtirishni tarmoq ICHIGA qo'yamiz
tf.random.set_seed(42)
norm = keras.layers.Normalization()
X_xom_tr = SimpleImputer(strategy="median").fit_transform(df[son])[
    train_test_split(np.arange(len(df)), test_size=0.3, random_state=42, stratify=y)[0]]
norm.adapt(X_xom_tr.astype("float32"))
ichki = keras.Sequential([keras.layers.Input(shape=(len(son),)), norm,
                          keras.layers.Dense(32, activation="relu"),
                          keras.layers.Dense(1, activation="sigmoid")])
ichki.compile(optimizer="adam", loss="binary_crossentropy", metrics=["accuracy"])
ichki.fit(X_xom_tr.astype("float32"), y_tr, epochs=40, batch_size=32, verbose=0)
X_xom_te = SimpleImputer(strategy="median").fit_transform(df[son])[
    train_test_split(np.arange(len(df)), test_size=0.3, random_state=42, stratify=y)[1]]
print("Normallashtirish tarmoq ICHIDA — XOM ma'lumot beriladi:")
print(f"  test aniqlik: {ichki.evaluate(X_xom_te.astype('float32'), y_te, verbose=0)[1]:.4f}")
print("  Bu modelni saqlasangiz, shkalalash ham birga saqlanadi.")
Scaler alohida saqlandi: scaler.joblib (767 bayt)

Normallashtirish tarmoq ICHIDA — XOM ma'lumot beriladi:
  test aniqlik: 0.7694
  Bu modelni saqlasangiz, shkalalash ham birga saqlanadi.
Keras va sklearn: taqqoslash
from sklearn.ensemble import RandomForestClassifier
from sklearn.linear_model import LogisticRegression
from sklearn.model_selection import cross_val_score

print(f"{'model':<34} {'test aniqlik':>14}")
print("-" * 50)
print(f"{'Keras MLP (64-32, dropout)':<34} {aniq2:>14.4f}")
for nom, m in [("LogisticRegression", LogisticRegression(max_iter=3000)),
               ("RandomForest", RandomForestClassifier(n_estimators=200, random_state=42))]:
    m.fit(X_tr, y_tr)
    print(f"{nom:<34} {m.score(X_te, y_te):>14.4f}")
model                                test aniqlik
--------------------------------------------------
Keras MLP (64-32, dropout)                 0.7639
LogisticRegression                         0.7694
RandomForest                               0.7250
29-bobdagi xulosa kuchda qoladi: tabular ma'lumotda Keras ustunlik bermaydi.
Bugun nima o'rgandik
show(pd.DataFrame([
    {"Tushuncha": "Uch qadam", "Bitta jumla": "Sequential -> compile -> fit"},
    {"Tushuncha": "Chiqish va loss juftligi", "Bitta jumla": "sigmoid+BCE, softmax+CCE, regression: activation yo'q+MSE"},
    {"Tushuncha": "EarlyStopping", "Bitta jumla": "restore_best_weights=True ni UNUTMANG"},
    {"Tushuncha": "O'qitish egri chizig'i", "Bitta jumla": "train va val ni yonma-yon ko'rish — asosiy diagnostika"},
    {"Tushuncha": "Functional API", "Bitta jumla": "Bir nechta kirish/chiqish yoki shoxlangan tarmoq"},
    {"Tushuncha": "tf.data", "Bitta jumla": "Katta ma'lumot, augmentatsiya, prefetch uchun"},
    {"Tushuncha": "Saqlash tuzog'i", "Bitta jumla": "model.save() scaler ni saqlamaydi"},
]))
| Tushuncha | Bitta jumla |
|---|---|
| Uch qadam | Sequential -> compile -> fit |
| Chiqish va loss juftligi | sigmoid+BCE, softmax+CCE, regression: activation yo'q+MSE |
| EarlyStopping | restore_best_weights=True ni UNUTMANG |
| O'qitish egri chizig'i | train va val ni yonma-yon ko'rish — asosiy diagnostika |
| Functional API | Bir nechta kirish/chiqish yoki shoxlangan tarmoq |
| tf.data | Katta ma'lumot, augmentatsiya, prefetch uchun |
| Saqlash tuzog'i | model.save() scaler ni saqlamaydi |
Keyingi bobda xuddi shu ishni PyTorch da qilamiz — va ikki kutubxona farqini ko'ramiz.
Bu bobni bepul o'qidingiz.
Kitob o'rgatadi, lekin sizning kodingiz nega ishlamaganini ayta olmaydi. Kursda uy vazifangiz tekshiriladi.