Stacking, blending va voting
Sahna: 21-bobdagi jadval
4-qism oxirida sakkizta algoritmni taqqoslagandik, va to'rttasi bir xil darajada chiqdi.
Savol tabiiy: agar ularning har biri ma'lumotning boshqa tomonini ko'rsa, ularni birlashtirsak bo'lmaydimi?
18-bobda shu g'oyani ko'rganmiz — lekin u yerda bir xil turdagi daraxtlarni birlashtirdik. Endi turli xil modellarni birlashtiramiz.
Uch usul
import pandas as pd
import numpy as np
show(pd.DataFrame([
    {"Usul": "Voting", "Qanday birlashtiradi": "Ovoz berish yoki o'rtacha",
     "Meta-model": "Yo'q", "Murakkabligi": "Eng oddiy"},
    {"Usul": "Stacking", "Qanday birlashtiradi": "Meta-model bashoratlardan o'rganadi",
     "Meta-model": "BOR", "Murakkabligi": "O'rtacha"},
    {"Usul": "Blending", "Qanday birlashtiradi": "Stacking, lekin alohida hold-out da",
     "Meta-model": "BOR", "Murakkabligi": "Soddaroq, lekin ma'lumot sarflaydi"},
]))
| Usul | Qanday birlashtiradi | Meta-model | Murakkabligi |
|---|---|---|---|
| Voting | Ovoz berish yoki o'rtacha | Yo'q | Eng oddiy |
| Stacking | Meta-model bashoratlardan o'rganadi | BOR | O'rtacha |
| Blending | Stacking, lekin alohida hold-out da | BOR | Soddaroq, lekin ma'lumot sarflaydi |
Avval: baza modellar
from sklearn.model_selection import train_test_split, cross_val_score
from sklearn.pipeline import Pipeline
from sklearn.compose import ColumnTransformer
from sklearn.preprocessing import StandardScaler, OneHotEncoder
from sklearn.impute import SimpleImputer
from sklearn.linear_model import LogisticRegression
from sklearn.ensemble import RandomForestClassifier, VotingClassifier, StackingClassifier
from sklearn.svm import SVC
from sklearn.neighbors import KNeighborsClassifier
from sklearn.naive_bayes import GaussianNB

df = pd.read_csv(DATA / "uy_ijara.csv")
son = ["xonalar", "maydon_m2", "qavat", "qavatlar_soni", "metro_km", "mebel", "qurilgan_yil"]
matn = ["tuman"]
X, y = df[son + matn], df["ijaraga_berildi_30k"]

def tayyorla():
    return ColumnTransformer([
        ("son", Pipeline([("i", SimpleImputer(strategy="median")), ("sc", StandardScaler())]), son),
        ("matn", OneHotEncoder(handle_unknown="ignore"), matn),
    ])

def quvur(model):
    return Pipeline([("t", tayyorla()), ("m", model)])

bazalar = {
    "LogisticRegression": LogisticRegression(max_iter=3000),
    "RandomForest": RandomForestClassifier(n_estimators=200, random_state=42),
    "SVC": SVC(probability=True, random_state=42),
    "KNN": KNeighborsClassifier(n_neighbors=15),
    "GaussianNB": GaussianNB(),
}

print(f"{'baza model':<24} {'CV F1':>9} {'±':>8}")
print("-" * 44)
ballar = {}
for nom, m in bazalar.items():
    b = cross_val_score(quvur(m), X, y, cv=5, scoring="f1")
    ballar[nom] = b
    print(f"{nom:<24} {b.mean():>9.4f} {b.std():>8.4f}")
eng_yaxshi_baza = max(ballar.items(), key=lambda kv: kv[1].mean())
print()
print(f"Eng yaxshi yakka model: {eng_yaxshi_baza[0]} ({eng_yaxshi_baza[1].mean():.4f})")
baza model                   CV F1        ±
--------------------------------------------
LogisticRegression          0.7273   0.0118
RandomForest                0.6998   0.0138
SVC                         0.7263   0.0134
KNN                         0.6999   0.0183
GaussianNB                  0.7299   0.0054

Eng yaxshi yakka model: GaussianNB (0.7299)
Modellar bir-biridan farq qiladimi?
18-bobdagi qoida: ensemble faqat modellar farqli bo'lsa ishlaydi. Shuni tekshiramiz — bashoratlar korrelyatsiyasini o'lchaymiz.
from sklearn.model_selection import cross_val_predict

ehtimollar = {}
for nom, m in bazalar.items():
    ehtimollar[nom] = cross_val_predict(quvur(m), X, y, cv=5, method="predict_proba")[:, 1]

korr = pd.DataFrame(ehtimollar).corr().round(3)
show(korr)
print()
yuqori = [(a, b2, korr.loc[a, b2]) for i, a in enumerate(korr.columns)
          for b2 in korr.columns[i+1:] if korr.loc[a, b2] > 0.9]
print(f"0.9 dan yuqori korrelyatsiya: {len(yuqori)} juftlik")
for a, b2, v in yuqori:
    print(f"  {a} ~ {b2}: {v}")
0.9 dan yuqori korrelyatsiya: 5 juftlik
  LogisticRegression ~ RandomForest: 0.917
  LogisticRegression ~ SVC: 0.938
  LogisticRegression ~ GaussianNB: 0.972
  RandomForest ~ SVC: 0.919
  SVC ~ GaussianNB: 0.943
| index | LogisticRegression | RandomForest | SVC | KNN | GaussianNB |
|---|---|---|---|---|---|
| LogisticRegression | 1 | 0.917 | 0.938 | 0.874 | 0.972 |
| RandomForest | 0.917 | 1 | 0.919 | 0.887 | 0.895 |
| SVC | 0.938 | 0.919 | 1 | 0.894 | 0.943 |
| KNN | 0.874 | 0.887 | 0.894 | 1 | 0.853 |
| GaussianNB | 0.972 | 0.895 | 0.943 | 0.853 | 1 |
Korrelyatsiya past bo'lgan juftliklar — ensemble uchun eng qimmatli. Agar hamma model 0.99 korrelyatsiya qilsa, ularni birlashtirish foyda bermaydi.
Voting: eng oddiy usul
hard = VotingClassifier([(n, quvur(m)) for n, m in bazalar.items()], voting="hard")
soft = VotingClassifier([(n, quvur(m)) for n, m in bazalar.items()], voting="soft")

print(f"{'usul':<30} {'CV F1':>9} {'±':>8}")
print("-" * 50)
print(f"{'Eng yaxshi yakka model':<30} {eng_yaxshi_baza[1].mean():>9.4f} {eng_yaxshi_baza[1].std():>8.4f}")
for nom, m in [("Voting (hard — ovoz)", hard), ("Voting (soft — ehtimollik)", soft)]:
    b = cross_val_score(m, X, y, cv=5, scoring="f1")
    print(f"{nom:<30} {b.mean():>9.4f} {b.std():>8.4f}")
usul                               CV F1        ±
--------------------------------------------------
Eng yaxshi yakka model            0.7299   0.0054
Voting (hard — ovoz)              0.7313   0.0156
Voting (soft — ehtimollik)        0.7321   0.0104
show(pd.DataFrame([
    {"Turi": "hard", "Qanday ishlaydi": "Har model 0 yoki 1 deydi, ko'pchilik yutadi",
     "Qachon": "Modellar ehtimollik bermasa"},
    {"Turi": "soft", "Qanday ishlaydi": "Ehtimolliklar o'rtachalanadi",
     "Qachon": "ODATDA YAXSHIROQ — ishonch darajasi hisobga olinadi"},
]))
| Turi | Qanday ishlaydi | Qachon |
|---|---|---|
| hard | Har model 0 yoki 1 deydi, ko'pchilik yutadi | Modellar ehtimollik bermasa |
| soft | Ehtimolliklar o'rtachalanadi | ODATDA YAXSHIROQ — ishonch darajasi hisobga olinadi |
`voting="soft"` uchun hamma model `predict_proba` bera olishi kerak
SVC tabiiy ravishda ehtimollik bermaydi (21-bob). Shuning uchun yuqorida SVC(probability=True) yozdim — va bu o'qitishni ~5 barobar sekinlashtiradi.
Agar modellardan biri predict_proba ni qo'llab-quvvatlamasa, voting="soft" xato beradi.
Stacking: meta-model
Voting da birlashtirish qoidasi qotirilgan (o'rtacha olish). Stacking da esa uni model o'rganadi.
G'oya: baza modellarning bashoratlarini yangi xususiyat qilib, ustiga yana bitta model qo'yamiz.
diagramma(
    {
        "Xom ma'lumot\nX": (0, 1.6, 2.6, 1.1, "manba"),
        "LogisticRegression": (3.4, 0, 3, 0.95, "qayta"),
        "RandomForest": (3.4, 1.15, 3, 0.95, "qayta"),
        "SVC": (3.4, 2.3, 3, 0.95, "qayta"),
        "KNN": (3.4, 3.45, 3, 0.95, "qayta"),
        "Bashoratlar\n(yangi xususiyatlar)": (7.2, 1.15, 3, 1.3, "saqlash"),
        "META-MODEL\n(LogisticRegression)": (11, 1.15, 3, 1.3, "xizmat"),
    },
    [("Xom ma'lumot\nX", "LogisticRegression"), ("Xom ma'lumot\nX", "RandomForest"),
     ("Xom ma'lumot\nX", "SVC"), ("Xom ma'lumot\nX", "KNN"),
     ("LogisticRegression", "Bashoratlar\n(yangi xususiyatlar)"),
     ("RandomForest", "Bashoratlar\n(yangi xususiyatlar)"),
     ("SVC", "Bashoratlar\n(yangi xususiyatlar)"),
     ("KNN", "Bashoratlar\n(yangi xususiyatlar)"),
     ("Bashoratlar\n(yangi xususiyatlar)", "META-MODEL\n(LogisticRegression)")],
    nom="stacking.png",
    izoh="Stacking: baza modellarning bashoratlari meta-model uchun xususiyat bo'lib xizmat qiladi.",
)
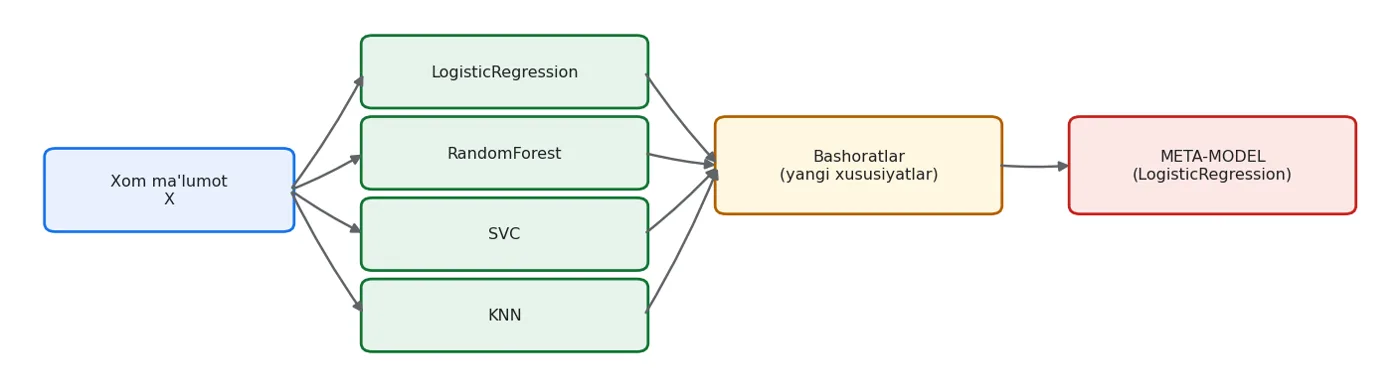
Stacking: baza modellarning bashoratlari meta-model uchun xususiyat bo'lib xizmat qiladi.
stack = StackingClassifier(
    estimators=[(n, quvur(m)) for n, m in bazalar.items()],
    final_estimator=LogisticRegression(max_iter=3000),
    cv=5,
)
b_stack = cross_val_score(stack, X, y, cv=5, scoring="f1")
print(f"{'usul':<30} {'CV F1':>9} {'±':>8}")
print("-" * 50)
print(f"{'Eng yaxshi yakka model':<30} {eng_yaxshi_baza[1].mean():>9.4f} {eng_yaxshi_baza[1].std():>8.4f}")
print(f"{'Voting (soft)':<30} {cross_val_score(soft, X, y, cv=5, scoring='f1').mean():>9.4f}")
print(f"{'Stacking':<30} {b_stack.mean():>9.4f} {b_stack.std():>8.4f}")
usul                               CV F1        ±
--------------------------------------------------
Eng yaxshi yakka model            0.7299   0.0054
Voting (soft)                     0.7321
Stacking                          0.7290   0.0105
OOF qoidasi — stacking ning yuragi
Stacking da bitta nozik joy bor, va u leakage ning eng chalkash shakli.
Meta-model baza modellarning bashoratlaridan o'rganadi. Lekin baza modellar qaysi ma'lumotda bashorat qilishi kerak?
show(pd.DataFrame([
    {"Yo'l": "Baza model TRAIN da bashorat qiladi", "Nima bo'ladi": "Bashoratlar juda yaxshi (model o'sha qatorlarni ko'rgan)",
     "Natija": "Meta-model aldanadi -> LEAKAGE"},
    {"Yo'l": "Out-of-fold (OOF) bashorat", "Nima bo'ladi": "Har qator uchun bashorat uni KO'RMAGAN modeldan olinadi",
     "Natija": "TO'G'RI"},
]))
print()
print("sklearn ning StackingClassifier(cv=5) buni AVTOMATIK qiladi.")
print("Qo'lda yozsangiz — cross_val_predict ishlatish shart.")
sklearn ning StackingClassifier(cv=5) buni AVTOMATIK qiladi.
Qo'lda yozsangiz — cross_val_predict ishlatish shart.
| Yo'l | Nima bo'ladi | Natija |
|---|---|---|
| Baza model TRAIN da bashorat qiladi | Bashoratlar juda yaxshi (model o'sha qatorlarni ko'rgan) | Meta-model aldanadi -> LEAKAGE |
| Out-of-fold (OOF) bashorat | Har qator uchun bashorat uni KO'RMAGAN modeldan olinadi | TO'G'RI |
# NOTO'G'RI yo'lni ko'rsataman — qo'lda, leakage bilan
X_tr, X_te, y_tr, y_te = train_test_split(X, y, test_size=0.3, random_state=42, stratify=y)
from sklearn.metrics import f1_score

# yomon: baza modellar TRAIN da bashorat qiladi
yomon_xus_tr, yomon_xus_te = [], []
for nom, m in bazalar.items():
    q = quvur(m).fit(X_tr, y_tr)
    yomon_xus_tr.append(q.predict_proba(X_tr)[:, 1])
    yomon_xus_te.append(q.predict_proba(X_te)[:, 1])
meta_yomon = LogisticRegression(max_iter=3000).fit(np.column_stack(yomon_xus_tr), y_tr)
f1_yomon = f1_score(y_te, meta_yomon.predict(np.column_stack(yomon_xus_te)))

# yaxshi: OOF bashorat
from sklearn.model_selection import cross_val_predict
yaxshi_xus_tr, yaxshi_xus_te = [], []
for nom, m in bazalar.items():
    oof = cross_val_predict(quvur(m), X_tr, y_tr, cv=5, method="predict_proba")[:, 1]
    yaxshi_xus_tr.append(oof)
    yaxshi_xus_te.append(quvur(m).fit(X_tr, y_tr).predict_proba(X_te)[:, 1])
meta_yaxshi = LogisticRegression(max_iter=3000).fit(np.column_stack(yaxshi_xus_tr), y_tr)
f1_yaxshi = f1_score(y_te, meta_yaxshi.predict(np.column_stack(yaxshi_xus_te)))

print(f"Meta-model TRAIN bashoratlarida o'qitildi (leakage): test F1 = {f1_yomon:.4f}")
print(f"Meta-model OOF bashoratlarida o'qitildi (to'g'ri)  : test F1 = {f1_yaxshi:.4f}")
print(f"sklearn StackingClassifier (OOF avtomatik)         : test F1 = {f1_score(y_te, stack.fit(X_tr, y_tr).predict(X_te)):.4f}")
Meta-model TRAIN bashoratlarida o'qitildi (leakage): test F1 = 0.7466
Meta-model OOF bashoratlarida o'qitildi (to'g'ri)  : test F1 = 0.7798
sklearn StackingClassifier (OOF avtomatik)         : test F1 = 0.7798
Natijalarga diqqat bilan qarang — ular kutilgandan boshqacha.
Leakage bilan o'qitilgan meta-model test da 0.7466 berdi, to'g'ri OOF versiyasi esa 0.7798. Ya'ni leakage natijani oshirmadi, pasaytirdi.
Bu — leakage ning ikkinchi, kamroq ma'lum shakli. 5-bobdagi misollarda leakage CV ballini sun'iy ko'taradi va siz aldanasiz. Bu yerda esa boshqa narsa bo'ldi:
baza modellar train qatorlarini yodlagan, shuning uchun ularning train bashoratlari deyarli mukammal. Meta-model shu mukammal bashoratlarga ishonishni o'rgandi. Keyin test da baza modellarning bashoratlari oddiy sifatda chiqdi — va meta-model ularga ortiqcha ishonib adashdi.
Ya'ni leakage bu yerda modelning o'zini buzdi. Ikkala holatda ham xulosa bir xil: OOF majburiy.
Leakage har doim ballni oshirmaydi
Talabalar leakage ni "natija yaxshi ko'rinadi, lekin yolg'on" deb eslab qoladi. Yuqoridagi o'lchov ko'rsatadi: ba'zan leakage natijani yomonlashtiradi ham.
Shuning uchun leakage ni "ball g'alati yuqori bo'lsa" degan belgidan emas, tuzilmadan aniqlash kerak: "bu bashorat qilish paytida menda bo'ladimi?" va "bu model shu qatorni ko'rganmi?"
Meta-model vaznlariga qarang — u sizga nima aytadi
Meta-model LogisticRegression bo'lsa, uning koeffitsiyentlari har bir baza modelga qancha "ishonch" berilganini ko'rsatadi.
meta = stack.fit(X, y).final_estimator_
vaznlar = pd.DataFrame({
    "baza model": list(bazalar.keys()),
    "meta-model vazni": meta.coef_[0].round(3),
    "yakka CV F1": [round(ballar[n].mean(), 4) for n in bazalar],
}).sort_values("meta-model vazni", key=abs, ascending=False)
show(vaznlar)
| baza model | meta-model vazni | yakka CV F1 |
|---|---|---|
| LogisticRegression | 2.137 | 0.727 |
| RandomForest | 1.08 | 0.7 |
| KNN | 0.486 | 0.7 |
| GaussianNB | 0.421 | 0.73 |
| SVC | 0.352 | 0.726 |
Jadvalni o'qing: meta-model qaysi modelga ko'p ishonadi? U har doim eng yaxshi yakka modelga emas — ba'zan boshqalardan farqli modelga ko'proq vazn beradi, chunki u yangi ma'lumot qo'shadi.
Blending: soddaroq, lekin qimmatroq
# blending: alohida hold-out to'plamida meta-model o'qitiladi
X_b_tr, X_blend, y_b_tr, y_blend = train_test_split(X_tr, y_tr, test_size=0.3,
                                                    random_state=42, stratify=y_tr)
bl_tr, bl_te = [], []
for nom, m in bazalar.items():
    q = quvur(m).fit(X_b_tr, y_b_tr)
    bl_tr.append(q.predict_proba(X_blend)[:, 1])
    bl_te.append(q.predict_proba(X_te)[:, 1])
meta_bl = LogisticRegression(max_iter=3000).fit(np.column_stack(bl_tr), y_blend)
print(f"Blending test F1  : {f1_score(y_te, meta_bl.predict(np.column_stack(bl_te))):.4f}")
print(f"Stacking test F1  : {f1_yaxshi:.4f}")
print()
print(f"Blending da meta-model faqat {len(y_blend)} qatorda o'qitildi")
print(f"Stacking da esa      {len(y_tr)} qatorda (OOF orqali)")
Blending test F1  : 0.7717
Stacking test F1  : 0.7798

Blending da meta-model faqat 252 qatorda o'qitildi
Stacking da esa      840 qatorda (OOF orqali)
Blending ni tushunish osonroq, lekin u ma'lumot sarflaydi: hold-out qismi baza modellarni o'qitishda ishlatilmaydi.
Narx va foyda
import time
print(f"{'usul':<26} {'CV F1':>9} {'o`qitish vaqti':>16} {'modellar soni':>15}")
print("-" * 70)
for nom, m, n_model in [
    ("Yakka LogisticRegression", quvur(LogisticRegression(max_iter=3000)), 1),
    (f"Yakka {eng_yaxshi_baza[0]}", quvur(bazalar[eng_yaxshi_baza[0]]), 1),
    ("Voting (soft)", soft, 5),
    ("Stacking", stack, 5 * 5 + 1),
]:
    t0 = time.perf_counter()
    b = cross_val_score(m, X, y, cv=5, scoring="f1")
    dt = time.perf_counter() - t0
    print(f"{nom:<26} {b.mean():>9.4f} {dt:>15.1f}s {n_model:>15}")
usul                           CV F1   o`qitish vaqti   modellar soni
----------------------------------------------------------------------
Yakka LogisticRegression      0.7273             0.0s               1
Yakka GaussianNB              0.7299             0.0s               1
Voting (soft)                 0.7321             1.3s               5
Stacking                      0.7290             6.8s              26
Ensemble ni ishlab chiqarishga chiqarish qimmat
Stacking da serverda oltita model turadi va har so'rov uchun hammasi ishga tushadi. Kechikish 5-6 barobar oshadi (29-bob, MLOps kitobi).
Shuning uchun amalda qoida shunday:
- Kaggle musobaqasi -> stacking ishlatiladi, chunki 0.001 ham muhim
- Ishlab chiqarish -> odatda yakka model, chunki qo'llab-quvvatlash va kechikish muhimroq
Agar ensemble foydasi tarqalish ichida bo'lsa, yakka modelni oling. 9-bob qoidasi bu yerda ham amal qiladi.
Yakuniy taqqoslash
hammasi = []
for nom in bazalar:
    hammasi.append({"model": f"yakka: {nom}", "CV F1": round(ballar[nom].mean(), 4),
                    "±": round(ballar[nom].std(), 4)})
for nom, m in [("Voting (hard)", hard), ("Voting (soft)", soft), ("Stacking", stack)]:
    b = cross_val_score(m, X, y, cv=5, scoring="f1")
    hammasi.append({"model": f"ensemble: {nom}", "CV F1": round(b.mean(), 4), "±": round(b.std(), 4)})
tab = pd.DataFrame(hammasi).sort_values("CV F1", ascending=False)
show(tab)
print()
eng = tab.iloc[0]
tarq = tab["±"].max()
yaqin = tab[tab["CV F1"] > eng["CV F1"] - tarq]
print(f"Eng baland: {eng['model']} ({eng['CV F1']})")
print(f"Tarqalish ichida: {len(yaqin)} / {len(tab)} model")
Eng baland: ensemble: Voting (soft) (0.7321)
Tarqalish ichida: 6 / 8 model
| model | CV F1 | ± |
|---|---|---|
| ensemble: Voting (soft) | 0.732 | 0.01 |
| ensemble: Voting (hard) | 0.731 | 0.016 |
| yakka: GaussianNB | 0.73 | 0.005 |
| ensemble: Stacking | 0.729 | 0.011 |
| yakka: LogisticRegression | 0.727 | 0.012 |
| yakka: SVC | 0.726 | 0.013 |
| yakka: KNN | 0.7 | 0.018 |
| yakka: RandomForest | 0.7 | 0.014 |
Bugun nima o'rgandik
show(pd.DataFrame([
    {"Tushuncha": "Voting", "Bitta jumla": "Ovoz yoki o'rtacha; soft odatda yaxshiroq"},
    {"Tushuncha": "Stacking", "Bitta jumla": "Meta-model baza bashoratlaridan o'rganadi"},
    {"Tushuncha": "Blending", "Bitta jumla": "Stacking, lekin alohida hold-out da — ma'lumot sarflaydi"},
    {"Tushuncha": "OOF qoidasi", "Bitta jumla": "Meta-model train bashoratlarida o'qitilsa — LEAKAGE"},
    {"Tushuncha": "Farqlilik sharti", "Bitta jumla": "Bashoratlar korrelyatsiyasi past bo'lsa foyda ko'p"},
    {"Tushuncha": "Meta vaznlari", "Bitta jumla": "Qaysi modelga ishonilgani ko'rinadi"},
    {"Tushuncha": "Narxi", "Bitta jumla": "Serverda N ta model — kechikish N barobar"},
]))
| Tushuncha | Bitta jumla |
|---|---|
| Voting | Ovoz yoki o'rtacha; soft odatda yaxshiroq |
| Stacking | Meta-model baza bashoratlaridan o'rganadi |
| Blending | Stacking, lekin alohida hold-out da — ma'lumot sarflaydi |
| OOF qoidasi | Meta-model train bashoratlarida o'qitilsa — LEAKAGE |
| Farqlilik sharti | Bashoratlar korrelyatsiyasi past bo'lsa foyda ko'p |
| Meta vaznlari | Qaysi modelga ishonilgani ko'rinadi |
| Narxi | Serverda N ta model — kechikish N barobar |
Keyingi bobda: model qaror qabul qildi. Nega shunday qildi?
Bu bobni bepul o'qidingiz.
Kitob o'rgatadi, lekin sizning kodingiz nega ishlamaganini ayta olmaydi. Kursda uy vazifangiz tekshiriladi.