Support Vector Machine (SVM)
Sahna: eng keng ko'cha
Ikki sinfni ajratadigan chiziq chizish kerak. Lekin cheksiz ko'p chiziq bu ishni bajaradi — qaysi birini tanlaysiz?
Logistic regression (15-bob) bitta javob beradi, daraxt (17-bob) boshqa javob beradi. SVM esa aniq mezon qo'yadi:
Ikki sinf orasidagi eng KENG ko'chani topaman, va chiziqni o'sha ko'chaning o'rtasidan o'tkazaman.
Ko'chaning kengligi — margin. Uning chetiga tegib turgan nuqtalar — support vektorlar. Modelning nomi shundan.
Margin nima va nega muhim
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
from sklearn.svm import SVC, LinearSVC
from sklearn.datasets import make_blobs

X_d, y_d = make_blobs(n_samples=60, centers=2, cluster_std=1.1, random_state=7)

svm = SVC(kernel="linear", C=1000).fit(X_d, y_d)   # C katta = qattiq margin
w, b0 = svm.coef_[0], svm.intercept_[0]

rasm, ax = plt.subplots(figsize=(9, 5.5))
ax.scatter(X_d[:, 0], X_d[:, 1], c=y_d, cmap="coolwarm", s=45, edgecolors="k", linewidths=.5)
xx = np.linspace(X_d[:, 0].min() - 1, X_d[:, 0].max() + 1, 100)
yy = -(w[0] * xx + b0) / w[1]
chet = 1 / np.linalg.norm(w)
ax.plot(xx, yy, "k-", lw=2, label="qaror chizig'i")
ax.plot(xx, yy + chet * np.sqrt(1 + (w[0]/w[1])**2), "k--", lw=1, label="margin cheti")
ax.plot(xx, yy - chet * np.sqrt(1 + (w[0]/w[1])**2), "k--", lw=1)
ax.scatter(svm.support_vectors_[:, 0], svm.support_vectors_[:, 1],
           s=260, facecolors="none", edgecolors="green", linewidths=2.2,
           label=f"support vektorlar ({len(svm.support_vectors_)} ta)")
ax.legend(fontsize=9); ax.set_title("SVM: eng keng ko'cha", fontweight="bold")
ax.grid(alpha=.3)
fig("svm_margin.png", caption="Qora chiziq — qaror chegarasi. Shtrix chiziqlar — margin chetlari. Yashil doiralar — support vektorlar.")

print(f"Jami nuqta        : {len(X_d)}")
print(f"Support vektorlar : {len(svm.support_vectors_)}")
print(f"Margin kengligi   : {2/np.linalg.norm(w):.4f}")
Jami nuqta        : 60
Support vektorlar : 3
Margin kengligi   : 3.9591
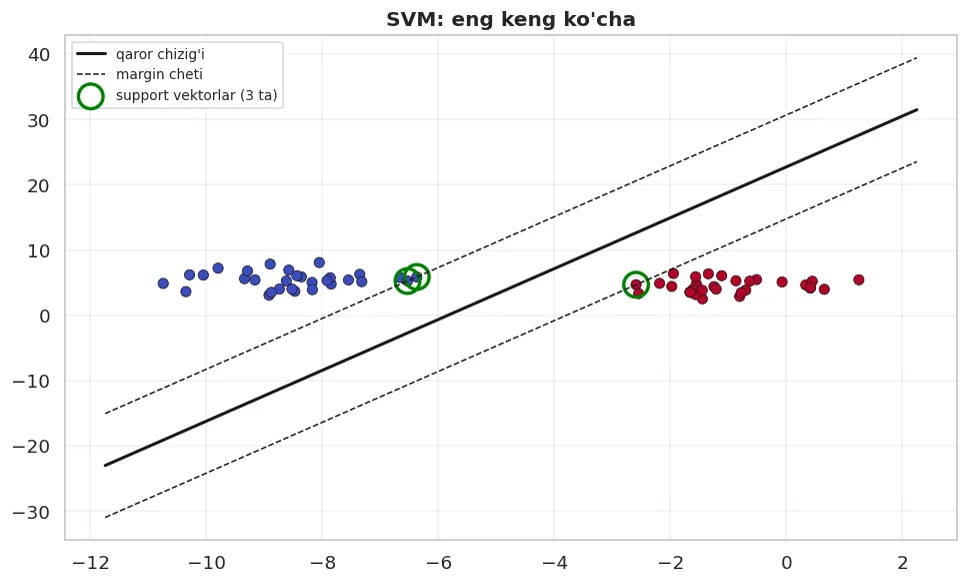
Qora chiziq — qaror chegarasi. Shtrix chiziqlar — margin chetlari. Yashil doiralar — support vektorlar.
Diqqat qiling: 60 nuqtadan faqat bir nechtasi modelni aniqlaydi. Qolgan nuqtalarni o'chirib tashlasangiz, chiziq o'zgarmaydi.
# isbot: support vektorlardan boshqasini olib tashlaymiz
sv_idx = svm.support_
svm2 = SVC(kernel="linear", C=1000).fit(X_d[sv_idx], y_d[sv_idx])
print(f"Butun ma'lumotda  : w = {svm.coef_[0].round(4)}, b = {svm.intercept_[0]:.4f}")
print(f"Faqat SV larda    : w = {svm2.coef_[0].round(4)}, b = {svm2.intercept_[0]:.4f}")
print(f"Bir xilmi         : {bool(np.allclose(svm.coef_, svm2.coef_, atol=1e-3))}")
Butun ma'lumotda  : w = [ 0.4893 -0.1257], b = 2.8536
Faqat SV larda    : w = [ 0.4892 -0.126 ], b = 2.8549
Bir xilmi         : True
Nega bu nazariy jihatdan chiroyli
Eng keng margin — eng ishonchli chegara. Agar yangi nuqta bir oz siljigan bo'lsa ham, keng ko'cha uni to'g'ri tomonda ushlab qoladi.
Shuning uchun SVM kichik ma'lumotda yaxshi umumlashtiradi: u ma'lumotning hamma nuqtasiga emas, faqat chegaradagi nuqtalarga tayanadi.
C parametri: qattiq va yumshoq margin
Haqiqiy ma'lumotda sinflar toza ajralmaydi. Shunda SVM ba'zi nuqtalarning ko'chaga kirishiga ruxsat beradi — lekin jarima bilan.
C — o'sha jarimaning kuchi.
from sklearn.model_selection import train_test_split, cross_val_score
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler

df = pd.read_csv(DATA / "uy_ijara.csv")
son = ["xonalar", "maydon_m2", "qavat", "qavatlar_soni", "metro_km", "mebel"]
X, y = df[son], df["ijaraga_berildi_30k"]
X_tr, X_te, y_tr, y_te = train_test_split(X, y, test_size=0.3, random_state=42, stratify=y)

print(f"{'C':>8} {'margin':>10} {'SV soni':>9} {'CV F1':>9} {'izoh'}")
print("-" * 54)
for C in [0.01, 0.1, 1, 10, 100]:
    q = Pipeline([("sc", StandardScaler()), ("m", SVC(kernel="linear", C=C))]).fit(X_tr, y_tr)
    b = cross_val_score(Pipeline([("sc", StandardScaler()), ("m", SVC(kernel="linear", C=C))]),
                        X, y, cv=5, scoring="f1")
    m = q.named_steps["m"]
    izoh = "yumshoq margin" if C <= 0.1 else ("qattiq margin" if C >= 100 else "")
    print(f"{C:>8} {'keng' if C <= 0.1 else 'tor':>10} {m.n_support_.sum():>9} {b.mean():>9.4f} {izoh}")
       C     margin   SV soni     CV F1 izoh
------------------------------------------------------
    0.01       keng       625    0.7242 yumshoq margin
     0.1       keng       590    0.7247 yumshoq margin
       1        tor       583    0.7233
      10        tor       583    0.7239
     100        tor       584    0.7239 qattiq margin
show(pd.DataFrame([
    {"C": "kichik (0.01-0.1)", "Margin": "KENG", "Xatoga munosabat": "Ruxsat beradi",
     "Natija": "Soddaroq model, ko'p support vektor", "Xavf": "Underfitting"},
    {"C": "katta (100+)", "Margin": "TOR", "Xatoga munosabat": "Qattiq jazolaydi",
     "Natija": "Murakkab chegara, kam support vektor", "Xavf": "Overfitting"},
]))
| C | Margin | Xatoga munosabat | Natija | Xavf |
|---|---|---|---|---|
| kichik (0.01-0.1) | KENG | Ruxsat beradi | Soddaroq model, ko'p support vektor | Underfitting |
| katta (100+) | TOR | Qattiq jazolaydi | Murakkab chegara, kam support vektor | Overfitting |
`C` — 16-bobdagi `C` bilan BIR XIL mantiq
16-bobda aytganmiz: LogisticRegression(C=...) da C = 1/alpha.
SVM da ham xuddi shunday: C katta = regularizatsiya KUCHSIZ.
Ya'ni Ridge(alpha=100) va SVC(C=0.01) ikkisi ham "kuchli jarima" degani. Chalkashtirmaslik uchun eslab qoling: alpha jarimani oshiradi, C jarimani kamaytiradi.
Kernel trick: SVM ning super kuchi
Hozirgacha kernel="linear" ishlatdik. Lekin SVM ning asosiy kuchi boshqa joyda.
15-bobdagi halqa ma'lumotini eslaysizmi? Chiziqli model 0.5350 berdi.
r = np.random.default_rng(42)
n = 600
burchak = r.uniform(0, 2 * np.pi, n)
radius = np.where(r.random(n) < 0.5, r.normal(1, .25, n), r.normal(3, .3, n))
Xh = np.c_[radius * np.cos(burchak), radius * np.sin(burchak)]
yh = (radius > 2).astype(int)

from sklearn.linear_model import LogisticRegression
from sklearn.tree import DecisionTreeClassifier

print(f"{'model':<34} {'CV accuracy':>13} {'±':>8}")
print("-" * 58)
for nom, m in [
    ("LogisticRegression (15-bob)", LogisticRegression()),
    ("DecisionTree (17-bob)", DecisionTreeClassifier(max_depth=6, random_state=42)),
    ("SVM kernel='linear'", SVC(kernel="linear")),
    ("SVM kernel='rbf'", SVC(kernel="rbf")),
]:
    b = cross_val_score(Pipeline([("sc", StandardScaler()), ("m", m)]), Xh, yh, cv=5)
    print(f"{nom:<34} {b.mean():>13.4f} {b.std():>8.4f}")
model                                CV accuracy        ±
----------------------------------------------------------
LogisticRegression (15-bob)               0.5350   0.0220
DecisionTree (17-bob)                     0.9883   0.0085
SVM kernel='linear'                       0.6400   0.0266
SVM kernel='rbf'                          1.0000   0.0000
kernel="rbf" halqani deyarli mukammal ajratdi — bitta parametr o'zgartirib.
Qanday? Kernel ma'lumotni yuqori o'lchovga ko'chiradi, u yerda sinflar chiziqli ajraladi, keyin natijani qaytaradi. Va buni haqiqatan ko'chirmasdan qiladi — faqat skalyar ko'paytmalarni boshqacha hisoblaydi. Shuning uchun "trick" deb ataladi.
show(pd.DataFrame([
    {"Kernel": "linear", "Qachon": "Ustunlar ko'p, ma'lumot matnli (TF-IDF)",
     "Parametrlar": "C", "Tezlik": "Tez"},
    {"Kernel": "rbf", "Qachon": "SUKUT TANLOV — murakkab chegara kerak bo'lsa",
     "Parametrlar": "C, gamma", "Tezlik": "Sekinroq"},
    {"Kernel": "poly", "Qachon": "Polinom bog'lanish ma'lum bo'lsa",
     "Parametrlar": "C, degree, gamma", "Tezlik": "Sekin"},
    {"Kernel": "sigmoid", "Qachon": "Kamdan-kam ishlatiladi",
     "Parametrlar": "C, gamma", "Tezlik": "Sekin"},
]))
| Kernel | Qachon | Parametrlar | Tezlik |
|---|---|---|---|
| linear | Ustunlar ko'p, ma'lumot matnli (TF-IDF) | C | Tez |
| rbf | SUKUT TANLOV — murakkab chegara kerak bo'lsa | C, gamma | Sekinroq |
| poly | Polinom bog'lanish ma'lum bo'lsa | C, degree, gamma | Sekin |
| sigmoid | Kamdan-kam ishlatiladi | C, gamma | Sekin |
gamma: rbf kernel ning radiusi
print(f"{'gamma':>10} {'CV accuracy':>13} {'izoh'}")
print("-" * 48)
for g in [0.001, 0.01, 0.1, 1, 10, 100]:
    b = cross_val_score(Pipeline([("sc", StandardScaler()), ("m", SVC(kernel="rbf", gamma=g))]),
                        Xh, yh, cv=5)
    izoh = "juda silliq (underfit)" if g <= 0.001 else ("har nuqta o'z oroli (overfit)" if g >= 100 else "")
    print(f"{g:>10} {b.mean():>13.4f} {izoh}")
print()
print("'scale' (sukut) — ma'lumot dispersiyasiga qarab avtomatik tanlanadi:")
b = cross_val_score(Pipeline([("sc", StandardScaler()), ("m", SVC(kernel='rbf', gamma='scale'))]), Xh, yh, cv=5)
print(f"  gamma='scale'  CV accuracy = {b.mean():.4f}")
     gamma   CV accuracy izoh
------------------------------------------------
     0.001        0.5033 juda silliq (underfit)
      0.01        0.5383
       0.1        1.0000
         1        1.0000
        10        0.9967
       100        0.9767 har nuqta o'z oroli (overfit)

'scale' (sukut) — ma'lumot dispersiyasiga qarab avtomatik tanlanadi:
  gamma='scale'  CV accuracy = 1.0000
gamma har bir support vektorning "ta'sir radiusi"ni belgilaydi:
- kichik gamma — katta radius, silliq chegara
- katta gamma — kichik radius, har nuqta o'z atrofini himoya qiladi (overfitting)
`C` va `gamma` ni BIRGA sozlash kerak
Ular bir-biriga bog'liq: katta C + katta gamma = kafolatlangan overfitting.
Shuning uchun SVM uchun GridSearchCV da ikkisini birga qidiriladi (23-bob):
{"m__C": [0.1, 1, 10, 100], "m__gamma": [0.001, 0.01, 0.1, 1]}
Bu 16 kombinatsiya — SVM ning sozlash narxi shunda.
Scaling SVM uchun hayotiy
print("SVM — scaling bilan va busiz:")
for nom, m in [("scaling YO'Q", SVC()),
               ("scaling BOR", Pipeline([("sc", StandardScaler()), ("m", SVC())]))]:
    b = cross_val_score(m, X, y, cv=5, scoring="f1")
    print(f"  {nom:14s} CV F1 = {b.mean():.4f} ±{b.std():.4f}")
SVM — scaling bilan va busiz:
  scaling YO'Q   CV F1 = 0.7263 ±0.0056
  scaling BOR    CV F1 = 0.7308 ±0.0135
Sabab KNN bilan bir xil (20-bob): SVM masofaga tayanadi, shuning uchun katta shkalali ustun hammasini bosib ketadi.
Tezlik: SVM ning asosiy cheklovi
import time
from sklearn.datasets import make_classification

print(f"{'qatorlar':>10} {'SVC (rbf)':>12} {'LinearSVC':>12} {'LogisticReg':>13}")
print("-" * 52)
for n_q in [500, 2000, 8000]:
    Xb, yb = make_classification(n_samples=n_q, n_features=20, n_informative=10, random_state=42)
    satr = [f"{n_q:>10}"]
    for m in [SVC(kernel="rbf"), LinearSVC(dual="auto", max_iter=5000), LogisticRegression(max_iter=2000)]:
        t0 = time.perf_counter()
        Pipeline([("sc", StandardScaler()), ("m", m)]).fit(Xb, yb)
        satr.append(f"{(time.perf_counter()-t0)*1000:>11.0f}ms")
    print(" ".join(satr))
  qatorlar    SVC (rbf)    LinearSVC   LogisticReg
----------------------------------------------------
       500           3ms           1ms           3ms
      2000          22ms           2ms           2ms
      8000         259ms           8ms          11ms
Jadvalga qarang: qatorlar ko'paygan sari SVC ning vaqti tez o'sadi.
Sabab: kernel SVM ning murakkabligi
show(pd.DataFrame([
    {"Qatorlar": "< 10 000", "Tanlov": "SVC(kernel='rbf')", "Izoh": "Kernel ning kuchidan foydalanish mumkin"},
    {"Qatorlar": "10 000 - 100 000", "Tanlov": "LinearSVC yoki SGDClassifier", "Izoh": "Kernel juda qimmat"},
    {"Qatorlar": "> 100 000", "Tanlov": "LogisticRegression / LightGBM", "Izoh": "SVM umuman mos emas"},
]))
| Qatorlar | Tanlov | Izoh |
|---|---|---|
| < 10 000 | SVC(kernel='rbf') | Kernel ning kuchidan foydalanish mumkin |
| 10 000 - 100 000 | LinearSVC yoki SGDClassifier | Kernel juda qimmat |
| > 100 000 | LogisticRegression / LightGBM | SVM umuman mos emas |
SVM 2010-yillarda qirol edi — bugun emas
Chuqur o'rganishdan oldin SVM eng kuchli model hisoblangan. Bugun esa tabular ma'lumotda boosting (19-bob) uni deyarli har doim yengadi, va u tezroq ishlaydi.
SVM hali ham mos keladigan joylar:
- Kichik ma'lumot (yuzlab qator) — kam parametr, yaxshi umumlashtirish
- Ustunlar qatorlardan ko'p (m > n) — masalan genetika, matn
- Matn tasnifi TF-IDF bilan — LinearSVC hali ham kuchli baza
Yangi loyihada esa birinchi tanlov sifatida boosting yoki logistic regression dan boshlaysiz.
Probability: SVM ehtimollik bermaydi
svc = Pipeline([("sc", StandardScaler()), ("m", SVC())]).fit(X_tr, y_tr)
try:
    svc.predict_proba(X_te[:3])
except AttributeError as e:
    print("SVC().predict_proba() ->", type(e).__name__)
    print(f"  {str(e)[:70]}")
print()
svc_p = Pipeline([("sc", StandardScaler()), ("m", SVC(probability=True, random_state=42))]).fit(X_tr, y_tr)
print("probability=True bilan:")
print(f"  {svc_p.predict_proba(X_te[:3])[:, 1].round(4)}")
print()
print("decision_function — SVM ning TABIIY chiqishi (chegaradan masofa):")
print(f"  {svc.decision_function(X_te[:3]).round(4)}")
SVC().predict_proba() -> AttributeError
  This 'Pipeline' has no attribute 'predict_proba'

probability=True bilan:
  [0.2973 0.771  0.7154]

decision_function — SVM ning TABIIY chiqishi (chegaradan masofa):
  [-0.9156  1.2765  0.9675]
`probability=True` qimmatga tushadi
SVM tabiiy ravishda ehtimollik bermaydi — u faqat chegaradan masofani beradi.
probability=True qo'ysangiz, sklearn ichida 5-fold cross-validation o'tkazib Platt kalibrlashni o'rgatadi. Ya'ni o'qitish vaqti ~5 barobar oshadi.
8-bobdagi threshold surish uchun esa decision_function() yetarli — u ham tartiblangan ball beradi.
Variantlar
show(pd.DataFrame([
    {"Klass": "SVC", "Vazifa": "Classification", "Kernel": "Bor", "Qachon": "n < 10 000"},
    {"Klass": "LinearSVC", "Vazifa": "Classification", "Kernel": "Yo'q (faqat chiziqli)", "Qachon": "Katta n, matn"},
    {"Klass": "SVR", "Vazifa": "Regression", "Kernel": "Bor", "Qachon": "Kichik regression"},
    {"Klass": "LinearSVR", "Vazifa": "Regression", "Kernel": "Yo'q", "Qachon": "Katta regression"},
    {"Klass": "OneClassSVM", "Vazifa": "Anomaliya aniqlash", "Kernel": "Bor", "Qachon": "Faqat 'normal' ma'lumot bo'lsa"},
]))
| Klass | Vazifa | Kernel | Qachon |
|---|---|---|---|
| SVC | Classification | Bor | n < 10 000 |
| LinearSVC | Classification | Yo'q (faqat chiziqli) | Katta n, matn |
| SVR | Regression | Bor | Kichik regression |
| LinearSVR | Regression | Yo'q | Katta regression |
| OneClassSVM | Anomaliya aniqlash | Bor | Faqat 'normal' ma'lumot bo'lsa |
4-qism yakuni: hamma algoritm bir jadvalda
from sklearn.ensemble import RandomForestClassifier
from sklearn.neighbors import KNeighborsClassifier
from sklearn.naive_bayes import GaussianNB
from xgboost import XGBClassifier

print(f"{'model':<28} {'CV F1':>9} {'±':>8} {'scaling':>9}")
print("-" * 60)
natijalar = []
for nom, m, sc_kerak in [
    ("LogisticRegression (15)", LogisticRegression(max_iter=2000), True),
    ("DecisionTree (17)", DecisionTreeClassifier(max_depth=6, min_samples_leaf=20, random_state=42), False),
    ("RandomForest (18)", RandomForestClassifier(n_estimators=200, random_state=42), False),
    ("XGBoost (19)", XGBClassifier(n_estimators=200, verbosity=0, random_state=42), False),
    ("KNN (20)", KNeighborsClassifier(n_neighbors=15), True),
    ("GaussianNB (20)", GaussianNB(), False),
    ("SVM rbf (21)", SVC(), True),
]:
    quvur = Pipeline([("sc", StandardScaler()), ("m", m)]) if sc_kerak else m
    b = cross_val_score(quvur, X, y, cv=5, scoring="f1")
    natijalar.append((nom, b.mean(), b.std()))
    print(f"{nom:<28} {b.mean():>9.4f} {b.std():>8.4f} {'ha' if sc_kerak else 'yo`q':>9}")

print()
eng = max(natijalar, key=lambda x: x[1])
tarqalish = max(n[2] for n in natijalar)
yaqin = [n[0] for n in natijalar if eng[1] - n[1] < tarqalish]
print(f"Eng baland     : {eng[0]} ({eng[1]:.4f})")
print(f"Tarqalish ichida: {len(yaqin)} ta model -> {', '.join(yaqin)}")
model                            CV F1        ±   scaling
------------------------------------------------------------
LogisticRegression (15)         0.7210   0.0111        ha
DecisionTree (17)               0.6715   0.0246      yo`q
RandomForest (18)               0.6824   0.0185      yo`q
XGBoost (19)                    0.6715   0.0292      yo`q
KNN (20)                        0.7064   0.0191        ha
GaussianNB (20)                 0.7291   0.0080      yo`q
SVM rbf (21)                    0.7308   0.0135        ha

Eng baland     : SVM rbf (21) (0.7308)
Tarqalish ichida: 4 ta model -> LogisticRegression (15), KNN (20), GaussianNB (20), SVM rbf (21)
Oxirgi qatorga diqqat qiling. 9-bob qoidasi bo'yicha, tarqalish ichidagi modellar orasida farq ishonchli emas.
Bizning ma'lumot kichik (1200 qator) va oson. Shuning uchun murakkab modellar oddiylaridan ustunlik qilmaydi — bu amaliyotda juda ko'p uchraydigan holat.
Bugun nima o'rgandik
show(pd.DataFrame([
    {"Tushuncha": "Margin", "Bitta jumla": "Ikki sinf orasidagi eng keng ko'cha"},
    {"Tushuncha": "Support vektorlar", "Bitta jumla": "Faqat chegaradagi nuqtalar modelni aniqlaydi"},
    {"Tushuncha": "C", "Bitta jumla": "Katta C = tor margin = kuchsiz regularizatsiya"},
    {"Tushuncha": "Kernel trick", "Bitta jumla": "Yuqori o'lchovga ko'chirmasdan chiziqsiz chegara"},
    {"Tushuncha": "gamma", "Bitta jumla": "Support vektorning ta'sir radiusi; C bilan birga sozlanadi"},
    {"Tushuncha": "Scaling", "Bitta jumla": "SHART — masofaga tayanadi"},
    {"Tushuncha": "Tezlik", "Bitta jumla": "O(n^2)-O(n^3) — 10 000 qatordan keyin mos emas"},
    {"Tushuncha": "Ehtimollik", "Bitta jumla": "Tabiiy ravishda yo'q; probability=True 5x qimmat"},
]))
| Tushuncha | Bitta jumla |
|---|---|
| Margin | Ikki sinf orasidagi eng keng ko'cha |
| Support vektorlar | Faqat chegaradagi nuqtalar modelni aniqlaydi |
| C | Katta C = tor margin = kuchsiz regularizatsiya |
| Kernel trick | Yuqori o'lchovga ko'chirmasdan chiziqsiz chegara |
| gamma | Support vektorning ta'sir radiusi; C bilan birga sozlanadi |
| Scaling | SHART — masofaga tayanadi |
| Tezlik | O(n^2)-O(n^3) — 10 000 qatordan keyin mos emas |
| Ehtimollik | Tabiiy ravishda yo'q; probability=True 5x qimmat |
Shu bilan 4-qism tugadi. Siz sakkizta algoritmni ko'rdingiz va ularning har birining qachon mos kelishini bilasiz.
Eng muhim xulosa esa boshqa: sizning ma'lumotingizda ularning ko'pi bir xil natija beradi. Shuning uchun algoritm tanlash — ishning kichik qismi. Asosiy ish ma'lumotda (1-qism), baholashda (2-qism) va xato tahlilida (10-bob).
Bu bobni bepul o'qidingiz.
Kitob o'rgatadi, lekin sizning kodingiz nega ishlamaganini ayta olmaydi. Kursda uy vazifangiz tekshiriladi.