Linear regression
Sahna: narxni ayting
Hozirgacha biz savolni "tez ketadimi?" deb qo'ygandik — ha yoki yo'q.
Endi direktor boshqa savol beradi: "Bu kvartiraga qancha narx qo'yaylik?"
Javob — son, yorliq emas. Bu — regression.
Bizda narx_usd ustuni bor. Bu bob shu ustunni bashorat qiladi — va 11–13-boblardagi mexanizm aynan shu yerda ishga tushadi.
Protokoldagi joyi
Bu — 9-qadam: "Pipeline da bitta oddiy model". Regression uchun shu oddiy model — chiziqli regressiya. U boshqa hamma regression modeli uchun baza bo'lib xizmat qiladi.
Tenglama
11-bobdan tanish: X @ w + b. Yangi narsa yo'q.
import pandas as pd
import numpy as np
from sklearn.model_selection import train_test_split, cross_val_score
from sklearn.linear_model import LinearRegression

df = pd.read_csv(DATA / "uy_ijara.csv")
son = ["xonalar", "maydon_m2", "qavat", "qavatlar_soni", "metro_km", "mebel"]
X, y = df[son], df["narx_usd"]
X_tr, X_te, y_tr, y_te = train_test_split(X, y, test_size=0.3, random_state=42)

model = LinearRegression().fit(X_tr, y_tr)
print(f"bias (b) = {model.intercept_:.2f}")
print()
print("Koeffitsiyentlar:")
for nom, k in zip(son, model.coef_):
    print(f"  {nom:16s} {k:>9.3f}")
bias (b) = 203.17

Koeffitsiyentlar:
  xonalar             62.719
  maydon_m2            7.067
  qavat                1.544
  qavatlar_soni        1.902
  metro_km           -27.502
  mebel               90.733
Koeffitsiyentni o'qish — eng foydali ko'nikma
Har bir koeffitsiyent bitta jumla bilan o'qiladi:
"Boshqa hamma narsa o'zgarmaganda, bu xususiyat 1 birlik oshsa, narx shuncha o'zgaradi."
izohlar = []
for nom, k in zip(son, model.coef_):
    yonalish = "oshadi" if k > 0 else "kamayadi"
    birlik = {"xonalar": "1 xona", "maydon_m2": "1 m2", "qavat": "1 qavat",
              "qavatlar_soni": "1 qavat", "metro_km": "1 km", "mebel": "mebel bo'lsa"}[nom]
    izohlar.append({"Xususiyat": nom, "Koeffitsiyent": round(k, 2),
                    "O'qilishi": f"{birlik} -> narx {abs(k):.1f} USD {yonalish}"})
show(pd.DataFrame(izohlar))
| Xususiyat | Koeffitsiyent | O'qilishi |
|---|---|---|
| xonalar | 62.72 | 1 xona -> narx 62.7 USD oshadi |
| maydon_m2 | 7.07 | 1 m2 -> narx 7.1 USD oshadi |
| qavat | 1.54 | 1 qavat -> narx 1.5 USD oshadi |
| qavatlar_soni | 1.9 | 1 qavat -> narx 1.9 USD oshadi |
| metro_km | -27.5 | 1 km -> narx 27.5 USD kamayadi |
| mebel | 90.73 | mebel bo'lsa -> narx 90.7 USD oshadi |
metro_km manfiy — metro uzoqlashsa narx tushadi. Mantiqan to'g'ri, va bu modelni tekshirish usuli: agar koeffitsiyent belgisi mantiqqa qarshi chiqsa, ma'lumotda yoki modelda muammo bor.
Koeffitsiyentlarni O'ZARO solishtirish uchun scaling kerak
Yuqoridagi jadvalda mebel koeffitsiyenti maydon_m2 dan katta. "Demak mebel muhimroq" degan xulosa noto'g'ri.
Chunki mebel 0 dan 1 gacha, maydon_m2 esa 22 dan 220 gacha. Birliklar boshqa, shuning uchun sonlarni solishtirib bo'lmaydi.
Solishtirish uchun avval StandardScaler qo'llang — keyin hamma koeffitsiyent "1 standart og'ish" birligida bo'ladi.
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler

shkalalangan = Pipeline([("sc", StandardScaler()), ("m", LinearRegression())]).fit(X_tr, y_tr)
k_shkala = shkalalangan.named_steps["m"].coef_

taqqos = pd.DataFrame({
    "xususiyat": son,
    "xom koeffitsiyent": model.coef_.round(2),
    "shkalalangan": k_shkala.round(2),
}).assign(muhimligi=lambda d: d.shkalalangan.abs().round(2)).sort_values("muhimligi", ascending=False)
show(taqqos)
print()
print("Endi to'g'ri xulosa: eng ta'sirli xususiyat —", taqqos.iloc[0].xususiyat)
Endi to'g'ri xulosa: eng ta'sirli xususiyat — maydon_m2
| xususiyat | xom koeffitsiyent | shkalalangan | muhimligi |
|---|---|---|---|
| maydon_m2 | 7.07 | 142.78 | 142.78 |
| xonalar | 62.72 | 67.25 | 67.25 |
| mebel | 90.73 | 44.11 | 44.11 |
| metro_km | -27.5 | -44.05 | 44.05 |
| qavatlar_soni | 1.9 | 8.17 | 8.17 |
| qavat | 1.54 | 5.7 | 5.7 |
Shkalalangandan keyin tartib o'zgardi. maydon_m2 eng ta'sirli, mebel esa ancha pastda — xom sonlarga qarab chiqargan xulosamiz teskari edi.
Baholash: R2, RMSE, MAE
from sklearn.metrics import r2_score, root_mean_squared_error, mean_absolute_error
from sklearn.dummy import DummyRegressor

bashorat = model.predict(X_te)
baza = DummyRegressor(strategy="mean").fit(X_tr, y_tr)
b_bashorat = baza.predict(X_te)

print(f"{'metrika':<8} {'baza (o`rtacha)':>17} {'model':>12} {'o`qilishi'}")
print("-" * 72)
print(f"{'R2':<8} {r2_score(y_te, b_bashorat):>17.4f} {r2_score(y_te, bashorat):>12.4f}   1.0 = mukammal, 0 = o'rtacha bilan teng")
print(f"{'RMSE':<8} {root_mean_squared_error(y_te, b_bashorat):>17.1f} {root_mean_squared_error(y_te, bashorat):>12.1f}   USD, katta xatoni ko'proq jazolaydi")
print(f"{'MAE':<8} {mean_absolute_error(y_te, b_bashorat):>17.1f} {mean_absolute_error(y_te, bashorat):>12.1f}   USD, o'rtacha xato")
metrika    baza (o`rtacha)        model o`qilishi
------------------------------------------------------------------------
R2                 -0.0044       0.8665   1.0 = mukammal, 0 = o'rtacha bilan teng
RMSE                 228.6         83.3   USD, katta xatoni ko'proq jazolaydi
MAE                  187.1         67.8   USD, o'rtacha xato
Qaysi birini hisobotga yozasiz?
show(pd.DataFrame([
    {"Metrika": "R2", "Nima aytadi": "Dispersiyaning qancha ulushi tushuntirilgan",
     "Kimga aytiladi": "Muhandisga", "Kamchiligi": "Biznes ma'nosi yo'q"},
    {"Metrika": "RMSE", "Nima aytadi": "Xato, target birligida (USD)",
     "Kimga aytiladi": "Muhandisga", "Kamchiligi": "Chetki qiymatlar tortadi"},
    {"Metrika": "MAE", "Nima aytadi": "O'rtacha xato, USD da",
     "Kimga aytiladi": "MENEJERGA", "Kamchiligi": "Katta xatoni yumshoq o'tadi"},
    {"Metrika": "MAPE", "Nima aytadi": "Xato foizda",
     "Kimga aytiladi": "Menejerga", "Kamchiligi": "Target nolga yaqin bo'lsa portlaydi"},
]))
| Metrika | Nima aytadi | Kimga aytiladi | Kamchiligi |
|---|---|---|---|
| R2 | Dispersiyaning qancha ulushi tushuntirilgan | Muhandisga | Biznes ma'nosi yo'q |
| RMSE | Xato, target birligida (USD) | Muhandisga | Chetki qiymatlar tortadi |
| MAE | O'rtacha xato, USD da | MENEJERGA | Katta xatoni yumshoq o'tadi |
| MAPE | Xato foizda | Menejerga | Target nolga yaqin bo'lsa portlaydi |
mae = mean_absolute_error(y_te, bashorat)
print(f"Menejerga aytiladigan jumla:")
print(f'  "Model ijara narxini o`rtacha {mae:.0f} USD xato bilan bashorat qiladi."')
print(f'  (o`rtacha narx {y.mean():.0f} USD, ya`ni ~{mae/y.mean():.1%} xato)')
Menejerga aytiladigan jumla:
  "Model ijara narxini o`rtacha 68 USD xato bilan bashorat qiladi."
  (o`rtacha narx 776 USD, ya`ni ~8.7% xato)
Mana shu jumla — hisobotning eng muhim qatori. R2 = 0.87 menejerga hech narsa anglatmaydi, 56 USD xato esa darhol tushunarli.
Eng muhim diagnostika: qoldiq grafigi
Regression da bitta grafik bor va u hamma narsani aytadi: qoldiqlar (residuals), ya'ni haqiqat - bashorat.
import matplotlib.pyplot as plt

qoldiq = y_te - bashorat

rasm, axes = plt.subplots(1, 3, figsize=(16, 4.4))

axes[0].scatter(bashorat, qoldiq, alpha=.45, s=22, color="#1a73e8")
axes[0].axhline(0, color="red", ls="--", lw=1.5)
axes[0].set_xlabel("Bashorat"); axes[0].set_ylabel("Qoldiq (haqiqat - bashorat)")
axes[0].set_title("Qoldiq vs bashorat", fontweight="bold")

axes[1].hist(qoldiq, bins=32, color="#43a047", alpha=.8)
axes[1].axvline(0, color="red", ls="--")
axes[1].set_xlabel("Qoldiq"); axes[1].set_title("Qoldiqlar taqsimoti", fontweight="bold")

axes[2].scatter(y_te, bashorat, alpha=.45, s=22, color="#8e24aa")
chegaralar = [min(y_te.min(), bashorat.min()), max(y_te.max(), bashorat.max())]
axes[2].plot(chegaralar, chegaralar, "r--", lw=1.5)
axes[2].set_xlabel("Haqiqat"); axes[2].set_ylabel("Bashorat")
axes[2].set_title("Haqiqat vs bashorat", fontweight="bold")

for a in axes: a.grid(alpha=.3)
fig("qoldiq.png", caption="Chapda: qoldiqlar nol atrofida tasodifiy tarqalgan bo'lishi kerak. O'rtada: ular normal taqsimotga o'xshashi kerak. O'ngda: nuqtalar diagonalga yaqin bo'lishi kerak.")
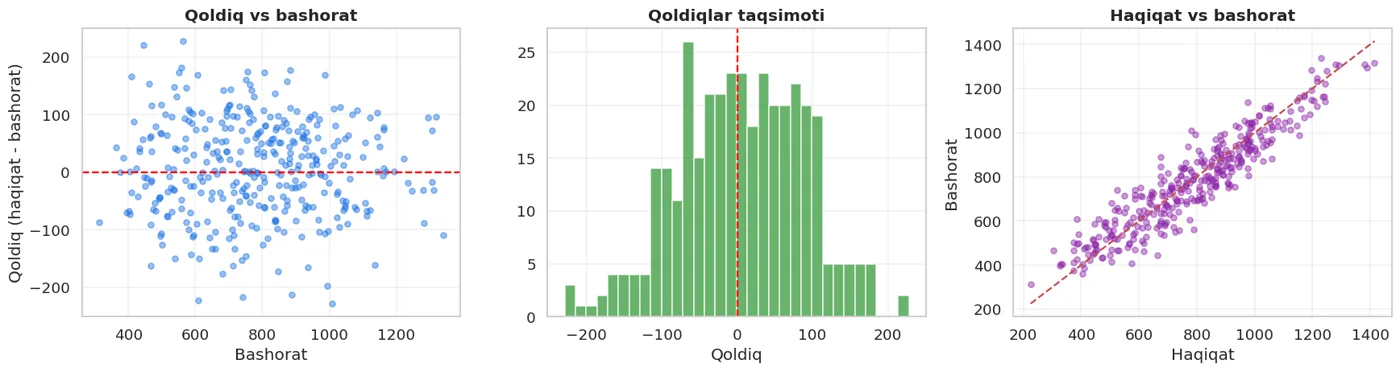
Chapda: qoldiqlar nol atrofida tasodifiy tarqalgan bo'lishi kerak. O'rtada: ular normal taqsimotga o'xshashi kerak. O'ngda: nuqtalar diagonalga yaqin bo'lishi kerak.
Qoldiq grafigini qanday o'qish kerak:
show(pd.DataFrame([
    {"Ko'rinish": "Nol atrofida tasodifiy bulut", "Diagnoz": "YAXSHI — model to'g'ri shaklda"},
    {"Ko'rinish": "Egri chiziq (U yoki kamalak)", "Diagnoz": "Bog'lanish CHIZIQLI EMAS -> daraxt yoki polinom kerak"},
    {"Ko'rinish": "Voronka shakli (o'ngda keng)", "Diagnoz": "Heteroskedastiklik -> log(y) ni sinab ko'ring"},
    {"Ko'rinish": "Bir necha nuqta juda uzoqda", "Diagnoz": "Chetki qiymatlar -> o'qing, keyin qaror qiling"},
]))
| Ko'rinish | Diagnoz |
|---|---|
| Nol atrofida tasodifiy bulut | YAXSHI — model to'g'ri shaklda |
| Egri chiziq (U yoki kamalak) | Bog'lanish CHIZIQLI EMAS -> daraxt yoki polinom kerak |
| Voronka shakli (o'ngda keng) | Heteroskedastiklik -> log(y) ni sinab ko'ring |
| Bir necha nuqta juda uzoqda | Chetki qiymatlar -> o'qing, keyin qaror qiling |
# raqam bilan tekshiramiz
print(f"Qoldiqlar o'rtachasi : {qoldiq.mean():>9.4f}   (nolga yaqin bo'lishi kerak)")
print(f"Qoldiqlar std        : {qoldiq.std():>9.2f}")
print()
# bashorat kattalashganda xato ham kattalashyaptimi (voronka testi)
guruh = pd.qcut(bashorat, 4, labels=["eng arzon", "arzon", "qimmat", "eng qimmat"])
tekshir = pd.DataFrame({"guruh": guruh, "mutlaq_xato": np.abs(qoldiq.to_numpy())})
print("Bashorat guruhi bo'yicha o'rtacha mutlaq xato:")
print(tekshir.groupby("guruh", observed=True).mutlaq_xato.mean().round(1).to_string())
Qoldiqlar o'rtachasi :    6.2064   (nolga yaqin bo'lishi kerak)
Qoldiqlar std        :     83.23

Bashorat guruhi bo'yicha o'rtacha mutlaq xato:
guruh
eng arzon     76.8
arzon         72.4
qimmat        61.5
eng qimmat    60.5
Agar oxirgi jadvalda xato bashorat bilan birga tez o'ssa, bu voronka belgisi. Biznes tilida: model qimmat kvartiralarda ko'proq adashadi.
MSE va MAE: chetki qiymat bilan sinov
12-bobda MSE chetki qiymatlarga sezgir deganmiz. Buni o'lchab ko'rsataman.
# ma'lumotga bitta g'alati qiymat qo'shamiz
X_buzuq = X_tr.copy()
y_buzuq = y_tr.copy()
y_buzuq.iloc[0] = 15000.0          # kiritish xatosi: 15 000 USD/oy

from sklearn.linear_model import HuberRegressor

qatorlar = []
for nom, m in [("LinearRegression (MSE)", LinearRegression()),
               ("HuberRegressor (MAE ga yaqin)", HuberRegressor(max_iter=2000))]:
    toza_m = Pipeline([("sc", StandardScaler()), ("m", m)]).fit(X_tr, y_tr)
    buzuq_m = Pipeline([("sc", StandardScaler()), ("m", m)]).fit(X_buzuq, y_buzuq)
    qatorlar.append({
        "Model": nom,
        "MAE (toza ma'lumot)": round(mean_absolute_error(y_te, toza_m.predict(X_te)), 1),
        "MAE (1 ta g'alati qiymat bilan)": round(mean_absolute_error(y_te, buzuq_m.predict(X_te)), 1),
    })
show(pd.DataFrame(qatorlar))
| Model | MAE (toza ma'lumot) | MAE (1 ta g'alati qiymat bilan) |
|---|---|---|
| LinearRegression (MSE) | 71.9 | 71.9 |
| HuberRegressor (MAE ga yaqin) | 68.1 | 68.1 |
Bitta buzuq qator butun modelni siljitdi. HuberRegressor esa ancha chidamli — chunki u katta xatoni kvadratga ko'tarmaydi.
Bitta qator modelni buzishi mumkin
Yuqoridagi jadval shuni ko'rsatadi: 840 qatordan bittasi noto'g'ri bo'lsa, MSE ga asoslangan model sezilarli siljiydi.
Shuning uchun 3-bobda boxplot chizgansiz. Chetki qiymatni ko'rsangiz: avval o'qing (haqiqatmi?), keyin qaror qiling — tashlash, cheklash (clip) yoki chidamli model ishlatish.
Chiziqli bo'lmagan bog'lanish: chiziqli model bilan
Chiziqli model faqat to'g'ri chiziq chizadi. Lekin unga egri xususiyat bersangiz, u egri chiziq chizadi.
from sklearn.preprocessing import PolynomialFeatures

print(f"{'model':<34} {'CV R2':>10} {'±':>8}")
print("-" * 54)
for nom, quvur in [
    ("Chiziqli (6 xususiyat)", Pipeline([("sc", StandardScaler()), ("m", LinearRegression())])),
    ("Polinom darajasi 2", Pipeline([("p", PolynomialFeatures(2, include_bias=False)),
                                      ("sc", StandardScaler()), ("m", LinearRegression())])),
    ("Polinom darajasi 3", Pipeline([("p", PolynomialFeatures(3, include_bias=False)),
                                      ("sc", StandardScaler()), ("m", LinearRegression())])),
]:
    b = cross_val_score(quvur, X, y, cv=5, scoring="r2")
    print(f"{nom:<34} {b.mean():>10.4f} {b.std():>8.4f}")
model                                   CV R2        ±
------------------------------------------------------
Chiziqli (6 xususiyat)                 0.8759   0.0091
Polinom darajasi 2                     0.8748   0.0081
Polinom darajasi 3                     0.8700   0.0070
p2 = PolynomialFeatures(2, include_bias=False).fit(X)
p3 = PolynomialFeatures(3, include_bias=False).fit(X)
print(f"Xususiyatlar soni: 6 -> {p2.transform(X[:1]).shape[1]} (daraja 2) -> {p3.transform(X[:1]).shape[1]} (daraja 3)")
print()
print("9-bob qoidasi bilan hukm: farq fold tarqalishidan kattami?")
Xususiyatlar soni: 6 -> 27 (daraja 2) -> 83 (daraja 3)

9-bob qoidasi bilan hukm: farq fold tarqalishidan kattami?
Jadvalga qarang va o'zingiz hukm chiqaring: polinom qo'shish foyda berdimi, yoki farq tarqalish ichidami? Agar foyda kichik bo'lsa — oddiy modelni saqlang (9-bob qoidasi).
Polinom darajasi oshgani sari xususiyatlar soni portlaydi — va bu overfitting ga olib keladi. Shu muammoning yechimi keyingi bobdan keyin: regularizatsiya (16-bob).
Chiziqli regressiya talablari
show(pd.DataFrame([
    {"Talab": "Bog'lanish chiziqli", "Qanday tekshirasiz": "Qoldiq grafigi — egri naqsh bo'lmasin",
     "Buzilsa": "Polinom, daraxt yoki log almashtirish"},
    {"Talab": "Qoldiqlar mustaqil", "Qanday tekshirasiz": "Vaqt bo'yicha qoldiq grafigi",
     "Buzilsa": "Vaqt qatori usullari"},
    {"Talab": "Bir xil dispersiya", "Qanday tekshirasiz": "Qoldiq grafigida voronka yo'qligi",
     "Buzilsa": "log(y) yoki vaznli regressiya"},
    {"Talab": "Multikollinearlik kam", "Qanday tekshirasiz": "Korrelyatsiya matritsasi (3-bob)",
     "Buzilsa": "Ridge (16-bob) yoki ustunni tashlash"},
    {"Talab": "Chetki qiymat kam", "Qanday tekshirasiz": "boxplot",
     "Buzilsa": "Huber yoki tozalash"},
]))
| Talab | Qanday tekshirasiz | Buzilsa |
|---|---|---|
| Bog'lanish chiziqli | Qoldiq grafigi — egri naqsh bo'lmasin | Polinom, daraxt yoki log almashtirish |
| Qoldiqlar mustaqil | Vaqt bo'yicha qoldiq grafigi | Vaqt qatori usullari |
| Bir xil dispersiya | Qoldiq grafigida voronka yo'qligi | log(y) yoki vaznli regressiya |
| Multikollinearlik kam | Korrelyatsiya matritsasi (3-bob) | Ridge (16-bob) yoki ustunni tashlash |
| Chetki qiymat kam | boxplot | Huber yoki tozalash |
Oxirgidan oldingi talabni bizning ma'lumot buzadi — xonalar va maydon_m2 korrelyatsiyasi 0.94. Oqibatini ko'ramiz:
print("Koeffitsiyentlar turli train bo'linishlarida qanchalik beqaror:")
print(f"{'random_state':>13} {'xonalar':>10} {'maydon_m2':>12}")
print("-" * 38)
for rs in [0, 1, 7, 42, 99]:
    Xa, _, ya, _ = train_test_split(X, y, test_size=0.3, random_state=rs)
    m = Pipeline([("sc", StandardScaler()), ("m", LinearRegression())]).fit(Xa, ya)
    k = m.named_steps["m"].coef_
    print(f"{rs:>13} {k[0]:>10.2f} {k[1]:>12.2f}")
Koeffitsiyentlar turli train bo'linishlarida qanchalik beqaror:
 random_state    xonalar    maydon_m2
--------------------------------------
            0      54.54       156.12
            1      63.36       147.55
            7      69.62       143.52
           42      67.25       142.78
           99      60.15       146.11
Koeffitsiyentlar bo'linishdan bo'linishga sakraydi — bu multikollinearlikning imzosi. Bashorat aniqligi barqaror, lekin "xonalar narxga qancha ta'sir qiladi" degan savolga ishonchli javob berolmaysiz.
16-bobda Ridge aynan shu muammoni yumshatadi.
Bugun nima o'rgandik
show(pd.DataFrame([
    {"Tushuncha": "Tenglama", "Bitta jumla": "y = X @ w + b — 11-bobdagi amal"},
    {"Tushuncha": "Koeffitsiyentni o'qish", "Bitta jumla": "'1 birlik oshsa, target shuncha o'zgaradi'"},
    {"Tushuncha": "Koeffitsiyentlarni solishtirish", "Bitta jumla": "Avval scaling — aks holda xulosa teskari chiqadi"},
    {"Tushuncha": "R2 / RMSE / MAE", "Bitta jumla": "Menejerga MAE ayt — u USD da"},
    {"Tushuncha": "Qoldiq grafigi", "Bitta jumla": "Regression dagi eng muhim diagnostika"},
    {"Tushuncha": "MSE va chetki qiymat", "Bitta jumla": "Bitta buzuq qator modelni siljitadi -> Huber"},
    {"Tushuncha": "Polinom xususiyat", "Bitta jumla": "Chiziqli model egri chiziq chizishi mumkin"},
    {"Tushuncha": "Multikollinearlik", "Bitta jumla": "Koeffitsiyentlar beqaror; bashorat esa barqaror"},
]))
| Tushuncha | Bitta jumla |
|---|---|
| Tenglama | y = X @ w + b — 11-bobdagi amal |
| Koeffitsiyentni o'qish | '1 birlik oshsa, target shuncha o'zgaradi' |
| Koeffitsiyentlarni solishtirish | Avval scaling — aks holda xulosa teskari chiqadi |
| R2 / RMSE / MAE | Menejerga MAE ayt — u USD da |
| Qoldiq grafigi | Regression dagi eng muhim diagnostika |
| MSE va chetki qiymat | Bitta buzuq qator modelni siljitadi -> Huber |
| Polinom xususiyat | Chiziqli model egri chiziq chizishi mumkin |
| Multikollinearlik | Koeffitsiyentlar beqaror; bashorat esa barqaror |
Keyingi bobda: target 0 va 1 bo'lsa, shu modelni ishlatsak bo'ladimi? Javob — yo'q, va nega emasligini ko'ramiz.
Bu bobni bepul o'qidingiz.
Kitob o'rgatadi, lekin sizning kodingiz nega ishlamaganini ayta olmaydi. Kursda uy vazifangiz tekshiriladi.