Xato tahlili: natija yomon bo'lsa nima qilish
Sahna: raqam bor, keyin nima?
Bu — talabalarni eng ko'p to'xtatadigan joy. Va aksariyat kitoblarda bu bob yo'q.
Model qurildi. F1 = 0.79. Endi?
Talaba odatda uchta narsadan birini qiladi:
- Boshqa algoritm sinaydi (XGBoost, keyin SVM, keyin neyron tarmoq)
GridSearchCVni ishga tushiradi va kutadi- Google da "how to improve model accuracy" deb qidiradi
Uchtasi ham taxmin. Uchtasi ham vaqtni yeydi.
To'g'ri harakat boshqa: model xato qilgan qatorlarni ochib o'qiysiz. Ma'lumotning o'zi sizga nima qilish kerakligini aytadi.
Bu — protokolning 11 va 12-qadami.
Modelni quramiz
import pandas as pd
import numpy as np
from sklearn.model_selection import train_test_split
from sklearn.pipeline import Pipeline
from sklearn.compose import ColumnTransformer
from sklearn.preprocessing import StandardScaler, OneHotEncoder
from sklearn.impute import SimpleImputer
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import f1_score, accuracy_score

df = pd.read_csv(DATA / "uy_ijara.csv")
son = ["xonalar", "maydon_m2", "qavat", "qavatlar_soni", "metro_km", "mebel", "qurilgan_yil"]
X, y = df[son + ["tuman"]], df["ijaraga_berildi_30k"]
X_tr, X_te, y_tr, y_te = train_test_split(X, y, test_size=0.3, random_state=42, stratify=y)

quvur = Pipeline([
    ("tayyorla", ColumnTransformer([
        ("son", Pipeline([("toldir", SimpleImputer(strategy="median")),
                          ("shkala", StandardScaler())]), son),
        ("matn", OneHotEncoder(handle_unknown="ignore"), ["tuman"]),
    ])),
    ("model", LogisticRegression(max_iter=2000)),
]).fit(X_tr, y_tr)

bashorat = quvur.predict(X_te)
ehtimol = quvur.predict_proba(X_te)[:, 1]
print(f"Accuracy: {accuracy_score(y_te, bashorat):.4f}")
print(f"F1      : {f1_score(y_te, bashorat):.4f}")
print()
print("Endi: BU RAQAMLARGA EMAS, XATOLARGA qaraymiz.")
Accuracy: 0.7778
F1      : 0.7938

Endi: BU RAQAMLARGA EMAS, XATOLARGA qaraymiz.
1-qadam. Xato qilgan qatorlarni ko'zingiz bilan o'qing
tahlil = X_te.copy()
tahlil["haqiqat"] = y_te
tahlil["bashorat"] = bashorat
tahlil["ishonch"] = ehtimol.round(3)
tahlil["xato"] = (tahlil.haqiqat != tahlil.bashorat).astype(int)

print(f"Jami xato: {tahlil.xato.sum()} / {len(tahlil)} ({tahlil.xato.mean():.1%})")
print()
print("Model ENG ISHONCH bilan adashgan 6 qator:")
eng = tahlil[tahlil.xato == 1].assign(
    xatolik=lambda d: (d.ishonch - d.haqiqat).abs()).nlargest(6, "xatolik")
show(eng[["tuman", "xonalar", "maydon_m2", "metro_km", "mebel", "haqiqat", "bashorat", "ishonch"]])
Jami xato: 80 / 360 (22.2%)

Model ENG ISHONCH bilan adashgan 6 qator:
| tuman | xonalar | maydon_m2 | metro_km | mebel | haqiqat | bashorat | ishonch |
|---|---|---|---|---|---|---|---|
| Shayxontohur | 1 | 29 | 2.78 | 0 | 0 | 1 | 0.855 |
| Sergeli | 2 | 34.7 | 4.45 | 1 | 0 | 1 | 0.85 |
| Chilonzor | 4 | 84.5 | 1.59 | 1 | 1 | 0 | 0.186 |
| Bektemir | 1 | 25.8 | 1.89 | 0 | 0 | 1 | 0.808 |
| Yakkasaroy | 4 | 75 | 1.62 | 1 | 1 | 0 | 0.205 |
| Yunusobod | 1 | 42.1 | 5.58 | 0 | 0 | 1 | 0.772 |
Bu jadvalni o'qing, tez o'tmang. Har qatorga qarab o'zingizdan so'rang: "men bu kvartira haqida nima deyman?"
Agar siz ham adashsangiz — demak ma'lumotda yetarli ma'lumot yo'q (yangi ustun kerak). Agar siz to'g'ri topsangiz — demak model buni ko'rishi uchun yangi ko'rinish kerak.
2-qadam. Xatolarni guruhlarga bo'lib sanang
Ko'z bilan o'qish — birinchi qadam. Keyin raqam bilan tekshiramiz: xatolar bir joyda to'planganmi?
def kesib_kor(ustun, nomi=None):
    g = tahlil.groupby(ustun, observed=True).agg(jami=("xato", "size"), xato=("xato", "sum"))
    g["xato_ulushi"] = (g.xato / g.jami).round(3)
    g = g[g.jami >= 10].sort_values("xato_ulushi", ascending=False)
    print(f"--- {nomi or ustun} bo'yicha ---")
    print(g.to_string())
    print()

kesib_kor("tuman")
kesib_kor("xonalar")
--- tuman bo'yicha ---
                jami  xato  xato_ulushi
tuman
Shayxontohur      38    12        0.316
Mirzo Ulug'bek    49    13        0.265
Olmazor           46    11        0.239
Yakkasaroy        27     6        0.222
Yunusobod         59    13        0.220
Bektemir          27     5        0.185
Chilonzor         67    12        0.179
Sergeli           47     8        0.170

--- xonalar bo'yicha ---
         jami  xato  xato_ulushi
xonalar
2         134    45        0.336
3          97    25        0.258
4          52     5        0.096
1          62     5        0.081
5          15     0        0.000
Mana shu — xato tahlilining yuragi. Umumiy xato ulushi bir xil, lekin guruhlar bo'yicha u teng taqsimlanmagan.
Raqamli ustunlarni ham guruhlaymiz — ularni oldin bo'laklarga bo'lamiz.
tahlil["maydon_guruh"] = pd.cut(tahlil.maydon_m2, bins=[0, 40, 60, 80, 300],
                                labels=["<40", "40-60", "60-80", "80+"])
tahlil["metro_guruh"] = pd.cut(tahlil.metro_km, bins=[0, 1, 2.5, 5, 20],
                               labels=["<1km", "1-2.5km", "2.5-5km", "5km+"])
kesib_kor("maydon_guruh", "Maydon")
kesib_kor("metro_guruh", "Metroga masofa")
--- Maydon bo'yicha ---
              jami  xato  xato_ulushi
maydon_guruh
40-60          149    50        0.336
60-80           91    19        0.209
<40             73     9        0.123
80+             47     2        0.043

--- Metroga masofa bo'yicha ---
             jami  xato  xato_ulushi
metro_guruh
5km+           31     8        0.258
2.5-5km       173    43        0.249
1-2.5km       103    23        0.223
<1km           53     6        0.113
3-qadam. Ikki xil xatoni alohida ko'ring
FP va FN — ikki xil kasallik. Ularni birga tahlil qilish — ikki kasalni bir dori bilan davolash.
fp = tahlil[(tahlil.haqiqat == 0) & (tahlil.bashorat == 1)]
fn = tahlil[(tahlil.haqiqat == 1) & (tahlil.bashorat == 0)]

print(f"FP (yo'qni bor dedi): {len(fp)} ta")
print(f"FN (borni yo'q dedi): {len(fn)} ta")
print()
qatorlar = []
for u in ["maydon_m2", "metro_km", "xonalar", "mebel", "qavat"]:
    qatorlar.append({"Ustun": u,
                     "FP o'rtacha": round(fp[u].mean(), 2),
                     "FN o'rtacha": round(fn[u].mean(), 2),
                     "To'g'ri o'rtacha": round(tahlil[tahlil.xato == 0][u].mean(), 2)})
show(pd.DataFrame(qatorlar))
FP (yo'qni bor dedi): 52 ta
FN (borni yo'q dedi): 28 ta
| Ustun | FP o'rtacha | FN o'rtacha | To'g'ri o'rtacha |
|---|---|---|---|
| maydon_m2 | 47.89 | 65.61 | 57.67 |
| metro_km | 3.04 | 2.99 | 2.75 |
| xonalar | 2.08 | 2.93 | 2.55 |
| mebel | 0.54 | 0.68 | 0.62 |
| qavat | 5.21 | 4.75 | 5.38 |
Jadvalni ustunlar bo'yicha o'qing. Agar FP va FN o'rtachalari bir-biridan farq qilsa, o'sha ustun xato turini tushuntiradi.
4-qadam. Ishonch taqsimoti: model qayerda shubhada
import matplotlib.pyplot as plt

rasm, axes = plt.subplots(1, 2, figsize=(13, 4.5))

axes[0].hist([tahlil[tahlil.haqiqat == 0].ishonch, tahlil[tahlil.haqiqat == 1].ishonch],
             bins=20, label=["haqiqatda sekin", "haqiqatda tez"], color=["#c5221f", "#137333"],
             alpha=.75, stacked=False)
axes[0].axvline(0.5, color="k", ls="--", label="chegara 0.5")
axes[0].set_xlabel("Model ishonchi"); axes[0].set_ylabel("Qatorlar soni")
axes[0].set_title("Ishonch taqsimoti"); axes[0].legend(); axes[0].grid(alpha=.3)

guruh = pd.cut(tahlil.ishonch, bins=np.arange(0, 1.01, 0.1))
xato_ulush = tahlil.groupby(guruh, observed=True).xato.mean()
axes[1].bar(range(len(xato_ulush)), xato_ulush.values, color="#1a73e8", alpha=.8)
axes[1].set_xticks(range(len(xato_ulush)))
axes[1].set_xticklabels([f"{i/10:.1f}" for i in range(len(xato_ulush))], rotation=45)
axes[1].set_xlabel("Ishonch oralig'i"); axes[1].set_ylabel("Xato ulushi")
axes[1].set_title("Qaysi ishonchda ko'p adashadi"); axes[1].grid(alpha=.3, axis="y")

fig("xato_tahlili.png", caption="Chapda: ikki sinf ishonch bo'yicha qanchalik ajralgan. O'ngda: xato qaysi ishonch oralig'ida to'plangan.")
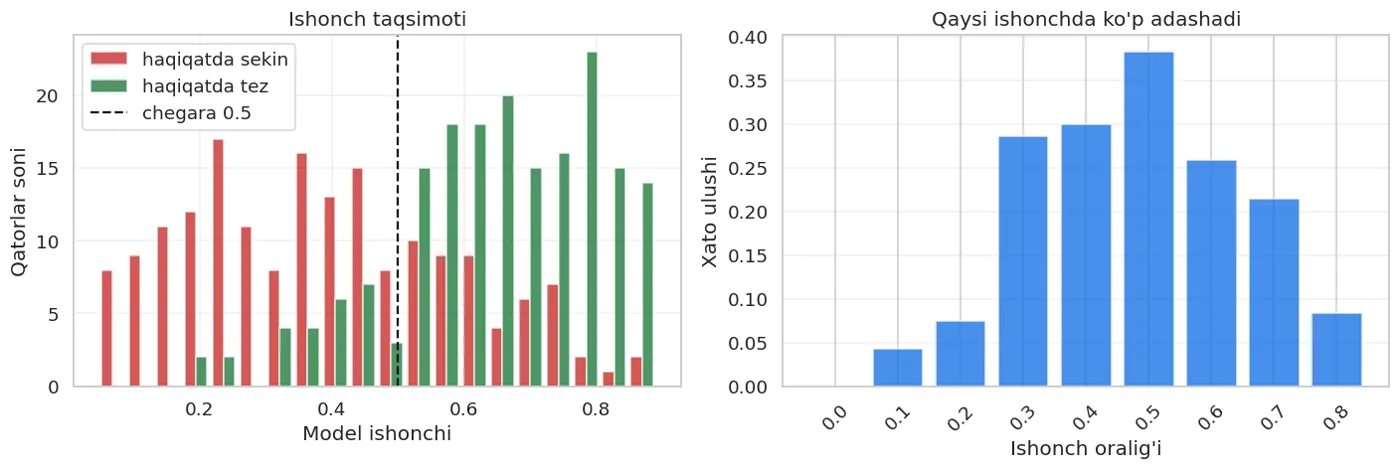
Chapda: ikki sinf ishonch bo'yicha qanchalik ajralgan. O'ngda: xato qaysi ishonch oralig'ida to'plangan.
O'ngdagi grafik muhim: xatolar 0.5 atrofida to'planadi. Bu normal — model shubhada bo'lgan joyda adashadi.
Lekin agar xatolar 0.9 atrofida ham ko'p bo'lsa — bu jiddiy signal. Model ishonch bilan adashayotgan bo'lsa, demak ma'lumotda yo noto'g'ri yorliq bor, yo muhim ustun yo'q.
5-qadam. Ko'proq ma'lumot kerakmi? O'lchab bilib olamiz
Bu savolga taxmin bilan javob berish mumkin emas. O'lchash kerak — learning curve.
from sklearn.model_selection import learning_curve

hajmlar, train_ball, val_ball = learning_curve(
    quvur, X, y, train_sizes=np.linspace(0.15, 1.0, 8), cv=5,
    scoring="f1", shuffle=True, random_state=42)

jadval = pd.DataFrame({
    "train hajmi": hajmlar,
    "train F1": train_ball.mean(axis=1).round(4),
    "val F1": val_ball.mean(axis=1).round(4),
    "farq (GAP)": (train_ball.mean(axis=1) - val_ball.mean(axis=1)).round(4),
})
show(jadval)
| train hajmi | train F1 | val F1 | farq (GAP) |
|---|---|---|---|
| 144 | 0.741 | 0.695 | 0.046 |
| 260 | 0.74 | 0.718 | 0.021 |
| 377 | 0.743 | 0.72 | 0.024 |
| 493 | 0.748 | 0.731 | 0.017 |
| 610 | 0.745 | 0.732 | 0.013 |
| 726 | 0.732 | 0.731 | 0.001 |
| 843 | 0.731 | 0.73 | 0.001 |
| 960 | 0.728 | 0.727 | 0 |
rasm2, ax = plt.subplots(figsize=(9, 5))
ax.plot(hajmlar, train_ball.mean(axis=1), "b-o", lw=2, label="Train F1")
ax.plot(hajmlar, val_ball.mean(axis=1), "r-o", lw=2, label="Validation F1")
ax.fill_between(hajmlar, train_ball.mean(axis=1), val_ball.mean(axis=1), alpha=.15, color="red")
ax.set_xlabel("Train qatorlari soni"); ax.set_ylabel("F1")
ax.set_title("Learning curve — ko'proq ma'lumot yordam beradimi?")
ax.legend(); ax.grid(alpha=.3)
fig("learning_curve.png", caption="Ikki chiziq yaqinlashib tekislangan bo'lsa, ko'proq ma'lumot yordam bermaydi.")
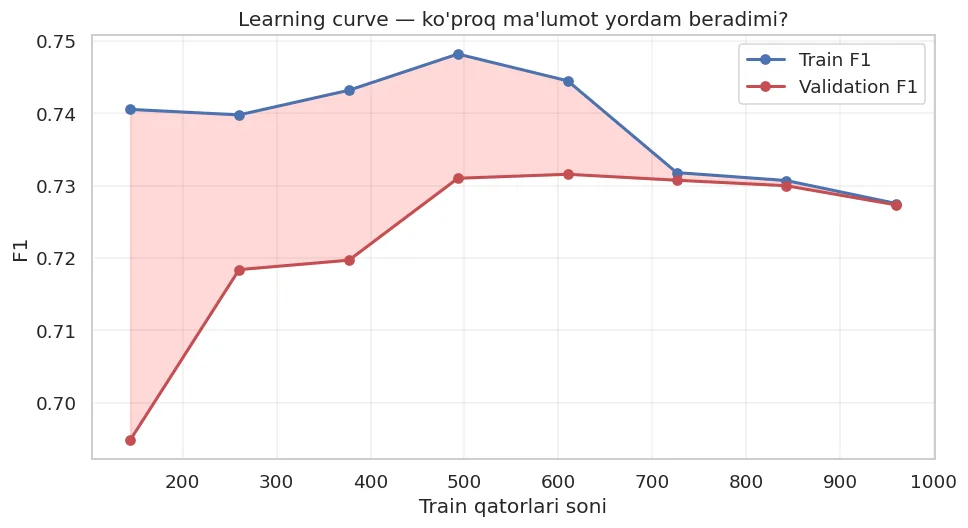
Ikki chiziq yaqinlashib tekislangan bo'lsa, ko'proq ma'lumot yordam bermaydi.
Grafikni o'qish qoidasi:
show(pd.DataFrame([
    {"Ko'rinish": "Ikki chiziq YAQIN va ikkisi ham PAST", "Diagnoz": "Underfitting (high bias)",
     "Harakat": "Kuchliroq model, ko'proq xususiyat. Ko'proq MA'LUMOT YORDAM BERMAYDI"},
    {"Ko'rinish": "Train BALAND, validation PAST, oraliq KATTA", "Diagnoz": "Overfitting (high variance)",
     "Harakat": "Ko'proq ma'lumot, regularizatsiya, soddaroq model"},
    {"Ko'rinish": "Validation hali O'SIB boryapti", "Diagnoz": "Ma'lumot kam",
     "Harakat": "Ko'proq ma'lumot yig'ish FOYDALI"},
    {"Ko'rinish": "Validation TEKISLANGAN", "Diagnoz": "Ma'lumot yetarli",
     "Harakat": "Yangi ustun yoki boshqa model kerak"},
]))
| Ko'rinish | Diagnoz | Harakat |
|---|---|---|
| Ikki chiziq YAQIN va ikkisi ham PAST | Underfitting (high bias) | Kuchliroq model, ko'proq xususiyat. Ko'proq MA'LUMOT YORDAM BERMAYDI |
| Train BALAND, validation PAST, oraliq KATTA | Overfitting (high variance) | Ko'proq ma'lumot, regularizatsiya, soddaroq model |
| Validation hali O'SIB boryapti | Ma'lumot kam | Ko'proq ma'lumot yig'ish FOYDALI |
| Validation TEKISLANGAN | Ma'lumot yetarli | Yangi ustun yoki boshqa model kerak |
oxirgi_gap = train_ball.mean(axis=1)[-1] - val_ball.mean(axis=1)[-1]
oxirgi_ikki = val_ball.mean(axis=1)[-1] - val_ball.mean(axis=1)[-3]
print(f"Oxirgi nuqtada GAP            : {oxirgi_gap:.4f}")
print(f"Validation oxirgi o'sishi     : {oxirgi_ikki:+.4f}")
print()
if oxirgi_gap > 0.08:
    print("DIAGNOZ: overfitting belgisi -> ko'proq ma'lumot yoki regularizatsiya")
elif oxirgi_ikki > 0.01:
    print("DIAGNOZ: validation hali o'syapti -> ko'proq ma'lumot FOYDALI")
else:
    print("DIAGNOZ: ma'lumot yetarli, chiziqlar yaqin -> YANGI USTUN yoki boshqa model kerak")
Oxirgi nuqtada GAP            : 0.0002
Validation oxirgi o'sishi     : -0.0034

DIAGNOZ: ma'lumot yetarli, chiziqlar yaqin -> YANGI USTUN yoki boshqa model kerak
6-qadam. Qaror va bitta o'zgarish
Endi sizda dalil bor. Jadval bo'yicha bitta harakat tanlaysiz.
show(pd.DataFrame([
    {"Dalil": "Xatolar bitta guruhda to'plangan", "Harakat": "O'sha guruh uchun yangi ustun yoki alohida model"},
    {"Dalil": "FP va FN o'rtachalari farq qiladi", "Harakat": "Threshold ni surish (8-bob)"},
    {"Dalil": "Model ishonch bilan adashadi", "Harakat": "Yorliqlarni tekshirish, muhim ustunni qo'shish"},
    {"Dalil": "Learning curve: validation o'syapti", "Harakat": "Ko'proq ma'lumot yig'ish"},
    {"Dalil": "Learning curve: GAP katta", "Harakat": "Regularizatsiya yoki soddaroq model"},
    {"Dalil": "Learning curve: ikkisi ham past va tekis", "Harakat": "Kuchliroq model (daraxt, boosting)"},
    {"Dalil": "Dalil yo'q, hammasi normal", "Harakat": "Tugating. Model yetarli (39-bob)"},
]))
| Dalil | Harakat |
|---|---|
| Xatolar bitta guruhda to'plangan | O'sha guruh uchun yangi ustun yoki alohida model |
| FP va FN o'rtachalari farq qiladi | Threshold ni surish (8-bob) |
| Model ishonch bilan adashadi | Yorliqlarni tekshirish, muhim ustunni qo'shish |
| Learning curve: validation o'syapti | Ko'proq ma'lumot yig'ish |
| Learning curve: GAP katta | Regularizatsiya yoki soddaroq model |
| Learning curve: ikkisi ham past va tekis | Kuchliroq model (daraxt, boosting) |
| Dalil yo'q, hammasi normal | Tugating. Model yetarli (39-bob) |
Bizning holatda dalil nimani ko'rsatadi? Learning curve bo'yicha diagnoz chiqarildi. Keling, aynan shu harakatni sinab ko'ramiz — chiziqli model yetarli emasligini tekshiramiz.
from sklearn.ensemble import RandomForestClassifier
from sklearn.model_selection import cross_val_score

def quvur_bilan(model):
    return Pipeline([
        ("tayyorla", ColumnTransformer([
            ("son", Pipeline([("toldir", SimpleImputer(strategy="median")),
                              ("shkala", StandardScaler())]), son),
            ("matn", OneHotEncoder(handle_unknown="ignore"), ["tuman"]),
        ])),
        ("model", model),
    ])

lr = cross_val_score(quvur_bilan(LogisticRegression(max_iter=2000)), X, y, cv=5, scoring="f1")
rf = cross_val_score(quvur_bilan(RandomForestClassifier(n_estimators=200, random_state=42)),
                     X, y, cv=5, scoring="f1")
print(f"Logistic Regression: {lr.mean():.4f} ±{lr.std():.4f}")
print(f"Random Forest      : {rf.mean():.4f} ±{rf.std():.4f}")
print(f"Farq               : {rf.mean() - lr.mean():+.4f}  (tarqalish ±{max(lr.std(), rf.std()):.4f})")
print()
print("Hukm:", "Random Forest ishonchli yaxshiroq" if rf.mean() - lr.mean() > max(lr.std(), rf.std())
      else "Farq tarqalish ichida — oddiyroq modelni saqlang")
Logistic Regression: 0.7273 ±0.0118
Random Forest      : 0.6998 ±0.0138
Farq               : -0.0275  (tarqalish ±0.0138)

Hukm: Farq tarqalish ichida — oddiyroq modelni saqlang
Bir vaqtda BITTA o'zgarish
Agar siz yangi ustun qo'shib, model ham o'zgartirib, threshold ni ham surib yuborsangiz va natija yaxshilansa — qaysi biri yordam berganini bilmaysiz.
Keyingi safar o'sha "yaxshi retsept" ni boshqa loyihada qo'llaysiz va u ishlamaydi. Chunki siz nimaning ishlaganini hech qachon bilmagansiz.
Bitta o'zgarish -> o'lchash -> yozib qo'yish -> keyingisi.
Xato tahlili daftari
Har bir aylanishni yozib boring. Bu daftar — sizning eng qimmatli hujjatingiz.
daftar = """
+----------------------------------------------------------------------+
|  XATO TAHLILI DAFTARI                                                |
+----------------------------------------------------------------------+
|  Sana        :                                                       |
|  Model       :                                                       |
|  Metrika     : F1 = ______  (CV: ______ +- ______)                   |
|  Baza        : ______                                                |
+----------------------------------------------------------------------+
|  1. Xatolar qaysi guruhda to'plangan?                                |
|     ................................................................ |
|  2. FP va FN farqi nimada?                                           |
|     ................................................................ |
|  3. Model ishonch bilan adashadimi? (0.9+ da xato bormi)             |
|     ................................................................ |
|  4. Learning curve diagnozi?                                         |
|     [ ] underfitting  [ ] overfitting  [ ] ma'lumot kam  [ ] yetarli |
+----------------------------------------------------------------------+
|  QAROR (faqat BITTASI):                                              |
|     [ ] yangi xususiyat: ...........................................  |
|     [ ] boshqa model: ..............................................  |
|     [ ] ko'proq ma'lumot                                             |
|     [ ] threshold surish: ..........................................  |
|     [ ] tugatish                                                     |
+----------------------------------------------------------------------+
|  Natija: ______  (oldingi: ______)   Farq: ______                    |
|  Gipotezam to'g'ri chiqdimi?  [ ] ha   [ ] YO'Q <- eng qimmatli      |
+----------------------------------------------------------------------+
"""
print(daftar)
+----------------------------------------------------------------------+
|  XATO TAHLILI DAFTARI                                                |
+----------------------------------------------------------------------+
|  Sana        :                                                       |
|  Model       :                                                       |
|  Metrika     : F1 = ______  (CV: ______ +- ______)                   |
|  Baza        : ______                                                |
+----------------------------------------------------------------------+
|  1. Xatolar qaysi guruhda to'plangan?                                |
|     ................................................................ |
|  2. FP va FN farqi nimada?                                           |
|     ................................................................ |
|  3. Model ishonch bilan adashadimi? (0.9+ da xato bormi)             |
|     ................................................................ |
|  4. Learning curve diagnozi?                                         |
|     [ ] underfitting  [ ] overfitting  [ ] ma'lumot kam  [ ] yetarli |
+----------------------------------------------------------------------+
|  QAROR (faqat BITTASI):                                              |
|     [ ] yangi xususiyat: ...........................................  |
|     [ ] boshqa model: ..............................................  |
|     [ ] ko'proq ma'lumot                                             |
|     [ ] threshold surish: ..........................................  |
|     [ ] tugatish                                                     |
+----------------------------------------------------------------------+
|  Natija: ______  (oldingi: ______)   Farq: ______                    |
|  Gipotezam to'g'ri chiqdimi?  [ ] ha   [ ] YO'Q <- eng qimmatli      |
+----------------------------------------------------------------------+
Oxirgi qatorga alohida e'tibor bering. Rad etilgan gipoteza — eng qimmatli yozuv. U sizga ma'lumotingiz haqida taxminlaringiz noto'g'ri ekanini aytadi, va shu bilimni hech qanday kitob bermaydi.
Bugun nima o'rgandik
show(pd.DataFrame([
    {"Qadam": "1. Xatolarni o'qi", "Vosita": "nlargest(ishonch) — ko'zingiz bilan"},
    {"Qadam": "2. Guruhlab sana", "Vosita": "groupby(ustun).xato.mean()"},
    {"Qadam": "3. FP va FN ni ajrat", "Vosita": "Ikki xil xato, ikki xil sabab"},
    {"Qadam": "4. Ishonch taqsimoti", "Vosita": "Model qayerda shubhada, qayerda ishonch bilan adashadi"},
    {"Qadam": "5. Learning curve", "Vosita": "Ko'proq ma'lumot kerakmi — TAXMIN emas, O'LCHOV"},
    {"Qadam": "6. BITTA o'zgarish", "Vosita": "Dalilga asoslangan qaror, keyin 9-qadamga qaytish"},
]))
| Qadam | Vosita |
|---|---|
| 1. Xatolarni o'qi | nlargest(ishonch) — ko'zingiz bilan |
| 2. Guruhlab sana | groupby(ustun).xato.mean() |
| 3. FP va FN ni ajrat | Ikki xil xato, ikki xil sabab |
| 4. Ishonch taqsimoti | Model qayerda shubhada, qayerda ishonch bilan adashadi |
| 5. Learning curve | Ko'proq ma'lumot kerakmi — TAXMIN emas, O'LCHOV |
| 6. BITTA o'zgarish | Dalilga asoslangan qaror, keyin 9-qadamga qaytish |
Shu bilan 2-qism tugadi. Siz endi: ma'lumotni bo'lasiz, bazani bilasiz, metrikani tanlaysiz, chegarani surasiz, CV bilan ishonchli baho olasiz va xato tahlili bilan keyingi qadamni topasiz.
Endi 42–44-boblardagi uchta mashqda shuni o'zingiz qilasiz.
Bu bobni bepul o'qidingiz.
Kitob o'rgatadi, lekin sizning kodingiz nega ishlamaganini ayta olmaydi. Kursda uy vazifangiz tekshiriladi.