Cross-validation
Sahna: 42 va 7
Talabangiz model qurdi, accuracy = 0.81 oldi. Siz aytasiz: "random_state ni 7 ga o'zgartirib ko'r."
U o'zgartiradi. 0.76.
Talaba hayron: "Modelni o'zgartirmadim. Nega raqam boshqa?"
Chunki u model haqida emas, bo'linish haqida o'lchagan edi. Bu bob shuni tuzatadi.
Muammoni ko'rsataman
import pandas as pd
import numpy as np
from sklearn.model_selection import train_test_split
from sklearn.pipeline import Pipeline
from sklearn.compose import ColumnTransformer
from sklearn.preprocessing import StandardScaler, OneHotEncoder
from sklearn.impute import SimpleImputer
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score

df = pd.read_csv(DATA / "uy_ijara.csv")
son = ["xonalar", "maydon_m2", "qavat", "qavatlar_soni", "metro_km", "mebel", "qurilgan_yil"]
X, y = df[son + ["tuman"]], df["ijaraga_berildi_30k"]

def quvur_qur():
    return Pipeline([
        ("tayyorla", ColumnTransformer([
            ("son", Pipeline([("toldir", SimpleImputer(strategy="median")),
                              ("shkala", StandardScaler())]), son),
            ("matn", OneHotEncoder(handle_unknown="ignore"), ["tuman"]),
        ])),
        ("model", LogisticRegression(max_iter=2000)),
    ])

natijalar = []
for rs in [0, 1, 7, 13, 42, 99, 123, 2026]:
    X_tr, X_te, y_tr, y_te = train_test_split(X, y, test_size=0.3, random_state=rs, stratify=y)
    a = accuracy_score(y_te, quvur_qur().fit(X_tr, y_tr).predict(X_te))
    natijalar.append(a)
    print(f"  random_state={rs:<5} accuracy = {a:.4f}")

print()
print(f"Eng past : {min(natijalar):.4f}")
print(f"Eng baland: {max(natijalar):.4f}")
print(f"Tarqalish : {max(natijalar) - min(natijalar):.4f}")
  random_state=0     accuracy = 0.6944
  random_state=1     accuracy = 0.7361
  random_state=7     accuracy = 0.7083
  random_state=13    accuracy = 0.7250
  random_state=42    accuracy = 0.7778
  random_state=99    accuracy = 0.7056
  random_state=123   accuracy = 0.7056
  random_state=2026  accuracy = 0.7139

Eng past : 0.6944
Eng baland: 0.7778
Tarqalish : 0.0833
Bitta model. Bitta ma'lumot. Natijalar oralig'i bor.
Agar siz random_state=42 ni tanlab, "modelim 0.78 beradi" deb hisobotga yozsangiz — bu yolg'on emas, lekin to'liq emas. Boshqa bo'linishda boshqa raqam chiqadi.
Yechim: hamma qatorni bir marta test qilish
Cross-validation g'oyasi oddiy. Ma'lumotni k qismga bo'lamiz. Keyin k marta o'qitamiz: har safar bitta qism test, qolgani train.
Natijada har bir qator aynan bir marta test bo'ladi.
diagramma(
    {
        "1-fold:  TEST | train | train | train | train": (0, 0, 7, 0.9, "xizmat"),
        "2-fold:  train | TEST | train | train | train": (0, 1.2, 7, 0.9, "qayta"),
        "3-fold:  train | train | TEST | train | train": (0, 2.4, 7, 0.9, "qayta"),
        "4-fold:  train | train | train | TEST | train": (0, 3.6, 7, 0.9, "qayta"),
        "5-fold:  train | train | train | train | TEST": (0, 4.8, 7, 0.9, "qayta"),
        "5 ta baho -> o'rtacha ± tarqalish": (1.5, 6.2, 4, 0.9, "saqlash"),
    },
    [("1-fold:  TEST | train | train | train | train", "5 ta baho -> o'rtacha ± tarqalish"),
     ("5-fold:  train | train | train | train | TEST", "5 ta baho -> o'rtacha ± tarqalish")],
    nom="cv.png",
    izoh="5-fold cross-validation: model 5 marta o'qitiladi, har qator bir marta test bo'ladi.",
)
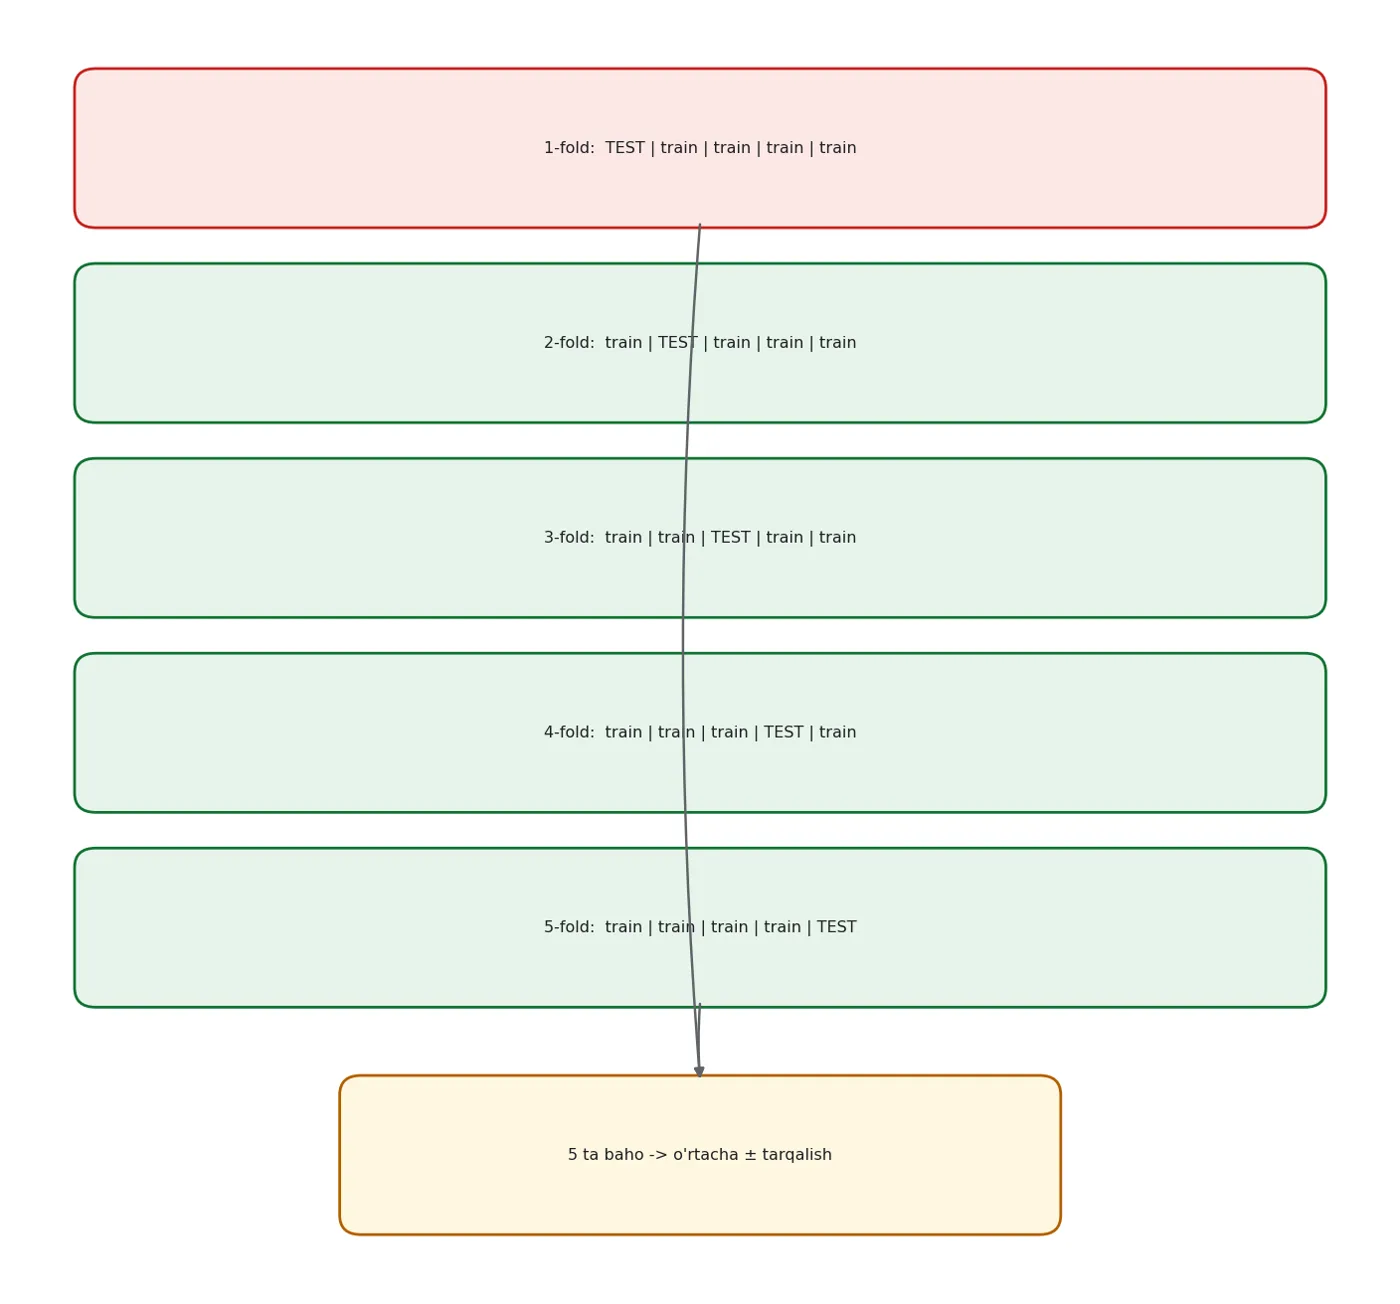
5-fold cross-validation: model 5 marta o'qitiladi, har qator bir marta test bo'ladi.
from sklearn.model_selection import cross_val_score

ballar = cross_val_score(quvur_qur(), X, y, cv=5, scoring="accuracy")
print("Har bir fold:", ballar.round(4).tolist())
print()
print(f"O'rtacha  : {ballar.mean():.4f}")
print(f"Tarqalish : ±{ballar.std():.4f}")
print()
print(f"Hisobotga shunday yoziladi: {ballar.mean():.3f} ± {ballar.std():.3f}")
Har bir fold: [0.7292, 0.7042, 0.7, 0.7042, 0.7458]

O'rtacha  : 0.7167
Tarqalish : ±0.0179

Hisobotga shunday yoziladi: 0.717 ± 0.018
Mana to'g'ri javob: bitta son emas, son va uning tarqalishi.
Hisobotda har doim ikkita son
accuracy = 0.78 — to'liq emas.
accuracy = 0.781 ± 0.019 (5-fold CV) — to'liq.
Ikkinchi son birinchisidan kam emas. U sizga "bu raqamga qanchalik ishonaman" degan savolga javob beradi.
StratifiedKFold — classification da sukut bo'yicha
cross_val_score classification uchun avtomatik StratifiedKFold ishlatadi — ya'ni har fold da sinf nisbati saqlanadi. Buni ko'rsatamiz.
from sklearn.model_selection import KFold, StratifiedKFold

print("Har fold dagi 'ha' ulushi:")
print(f"{'fold':>5} {'KFold':>9} {'StratifiedKFold':>17}")
print("-" * 34)
kf = list(KFold(n_splits=5, shuffle=True, random_state=42).split(X, y))
sk = list(StratifiedKFold(n_splits=5, shuffle=True, random_state=42).split(X, y))
for i in range(5):
    print(f"{i+1:>5} {y.iloc[kf[i][1]].mean():>8.1%} {y.iloc[sk[i][1]].mean():>16.1%}")
print()
print(f"Haqiqiy nisbat: {y.mean():.1%}")
Har fold dagi 'ha' ulushi:
 fold     KFold   StratifiedKFold
----------------------------------
    1    49.2%            50.4%
    2    53.3%            50.4%
    3    47.9%            50.8%
    4    53.8%            50.8%
    5    49.2%            50.8%

Haqiqiy nisbat: 50.7%
Bizning ma'lumotimiz katta va teng, shuning uchun farq kichik. Lekin nomutanosib yoki kichik ma'lumotda KFold ba'zi fold ga bitta ham pozitiv namuna qoldirmasligi mumkin — va o'sha fold da recall hisoblanmaydi.
Pipeline CV ichida: nega majburiy
Bu — eng muhim amaliy nuqta. CV har fold da tozalashni qaytadan bajarishi kerak. Aks holda leakage qaytadi.
from sklearn.preprocessing import StandardScaler as SS

# NOTO'G'RI: avval butun ma'lumotni tozalab, keyin CV
toldir = SimpleImputer(strategy="median").fit(X[son])
shkala = SS().fit(toldir.transform(X[son]))
X_oldin = pd.DataFrame(shkala.transform(toldir.transform(X[son])), columns=son, index=X.index)
yomon = cross_val_score(LogisticRegression(max_iter=2000), X_oldin, y, cv=5)

# TO'G'RI: tozalash Pipeline ichida, har fold da qaytadan
yaxshi = cross_val_score(quvur_qur(), X, y, cv=5)

print(f"NOTO'G'RI (oldin tozalab, keyin CV): {yomon.mean():.4f} ±{yomon.std():.4f}")
print(f"TO'G'RI   (Pipeline CV ichida)     : {yaxshi.mean():.4f} ±{yaxshi.std():.4f}")
print(f"Farq                               : {yomon.mean() - yaxshi.mean():+.4f}")
NOTO'G'RI (oldin tozalab, keyin CV): 0.7108 ±0.0155
TO'G'RI   (Pipeline CV ichida)     : 0.7167 ±0.0179
Farq                               : -0.0058
Farq yana kichik — chunki StandardScaler kam narsani "ko'radi". Lekin SelectKBest yoki target encoding bo'lsa, farq katta bo'ladi va siz aldanasiz.
Model obyektini CV ga bermang, Pipeline bering
cross_val_score(model, X_tozalangan, y) — leakage.
cross_val_score(pipeline, X_xom, y) — to'g'ri.
Bu farqni eslab qolish uchun: CV ga xom ma'lumot beriladi. Tozalash uning ichida bo'ladi.
Bitta son yetarli emas: cross_validate
cross_val_score bitta metrika beradi. Amalda bir nechtasi kerak.
from sklearn.model_selection import cross_validate

natija = cross_validate(quvur_qur(), X, y, cv=5,
                        scoring=["accuracy", "precision", "recall", "f1", "roc_auc"],
                        return_train_score=True)
qatorlar = []
for m in ["accuracy", "precision", "recall", "f1", "roc_auc"]:
    te = natija[f"test_{m}"]
    tr = natija[f"train_{m}"]
    qatorlar.append({"Metrika": m,
                     "Test o'rtacha": round(te.mean(), 4), "Test ±": round(te.std(), 4),
                     "Train o'rtacha": round(tr.mean(), 4),
                     "Train - Test": round(tr.mean() - te.mean(), 4)})
show(pd.DataFrame(qatorlar))
| Metrika | Test o'rtacha | Test ± | Train o'rtacha | Train - Test |
|---|---|---|---|---|
| accuracy | 0.717 | 0.018 | 0.717 | -0 |
| precision | 0.712 | 0.028 | 0.709 | -0.003 |
| recall | 0.745 | 0.017 | 0.747 | 0.002 |
| f1 | 0.727 | 0.012 | 0.728 | 0 |
| roc_auc | 0.783 | 0.022 | 0.793 | 0.01 |
Oxirgi ustun — overfitting o'lchovi. Train va test orasidagi farq katta bo'lsa, model yodlagan.
Bizda farq kichik — demak model yodlamagan, u haqiqatan umumlashtirgan. (Bias-variance 11-bobda.)
Ikki modelni taqqoslash: eng ko'p xato qilinadigan joy
Endi eng muhim amaliy savol: ikki modelni qanday taqqoslaymiz?
from sklearn.ensemble import RandomForestClassifier

def quvur_bilan(model):
    return Pipeline([
        ("tayyorla", ColumnTransformer([
            ("son", Pipeline([("toldir", SimpleImputer(strategy="median")),
                              ("shkala", StandardScaler())]), son),
            ("matn", OneHotEncoder(handle_unknown="ignore"), ["tuman"]),
        ])),
        ("model", model),
    ])

lr = cross_val_score(quvur_bilan(LogisticRegression(max_iter=2000)), X, y, cv=5)
rf = cross_val_score(quvur_bilan(RandomForestClassifier(n_estimators=200, random_state=42)), X, y, cv=5)

print("Logistic Regression:", lr.round(4).tolist())
print(f"  o'rtacha {lr.mean():.4f} ±{lr.std():.4f}")
print()
print("Random Forest      :", rf.round(4).tolist())
print(f"  o'rtacha {rf.mean():.4f} ±{rf.std():.4f}")
print()
print(f"O'rtachalar farqi  : {abs(rf.mean() - lr.mean()):.4f}")
print(f"Eng katta tarqalish: ±{max(lr.std(), rf.std()):.4f}")
print()
yetakchi = "Random Forest" if rf.mean() > lr.mean() else "Logistic Regression"
ishonch = "farq tarqalishdan KATTA" if abs(rf.mean()-lr.mean()) > max(lr.std(), rf.std()) else "farq tarqalish ICHIDA"
print(f"Yetakchi: {yetakchi}  |  {ishonch}")
Logistic Regression: [0.7292, 0.7042, 0.7, 0.7042, 0.7458]
  o'rtacha 0.7167 ±0.0179

Random Forest      : [0.7042, 0.6917, 0.6792, 0.6875, 0.725]
  o'rtacha 0.6975 ±0.0159

O'rtachalar farqi  : 0.0192
Eng katta tarqalish: ±0.0179

Yetakchi: Logistic Regression  |  farq tarqalishdan KATTA
Hukm chiqarish qoidasi:
show(pd.DataFrame([
    {"Holat": "Farq > 2 x tarqalish", "Xulosa": "Farq ishonchli — kattasini tanla"},
    {"Holat": "Farq ~ tarqalish", "Xulosa": "Shubhali — fold diapazonlarini solishtir"},
    {"Holat": "Farq < tarqalish", "Xulosa": "Farq YO'Q — oddiy/tez modelni tanla"},
]))
| Holat | Xulosa |
|---|---|
| Farq > 2 x tarqalish | Farq ishonchli — kattasini tanla |
| Farq ~ tarqalish | Shubhali — fold diapazonlarini solishtir |
| Farq < tarqalish | Farq YO'Q — oddiy/tez modelni tanla |
Oxirgi qator eng muhimi. Agar farq tarqalishdan kichik bo'lsa, siz oddiyroq modelni tanlaysiz — u tezroq ishlaydi, tushunarli va kam buziladi.
Fold diapazonlarini ham ko'ring, faqat o'rtachani emas
41-bobda men titanic da shu xatoga tushdim. O'rtachalar farqi 0.0303, tarqalish ±0.0248 edi — farq kattaroq ko'rindi. Lekin fold larni yonma-yon qo'ysam, diapazonlar ustma-ust tushardi: yomon modelning eng yaxshi fold i yaxshi modelning eng yomon fold idan baland edi.
Shuning uchun: min(a) > max(b) bo'lsa — ishonchli. Aks holda ehtiyot bo'ling.
Nechta fold?
print(f"{'cv':>4} {'o`rtacha':>10} {'tarqalish':>11} {'vaqt (nisbiy)':>14}")
print("-" * 42)
import time
for k in [3, 5, 10]:
    t0 = time.perf_counter()
    b = cross_val_score(quvur_qur(), X, y, cv=k)
    dt = time.perf_counter() - t0
    print(f"{k:>4} {b.mean():>10.4f} {b.std():>10.4f} {dt:>13.2f}s")
  cv   o`rtacha   tarqalish  vaqt (nisbiy)
------------------------------------------
   3     0.7175     0.0054          0.02s
   5     0.7167     0.0179          0.03s
  10     0.7175     0.0478          0.07s
Amaliy tanlov:
- cv=5 — sukut bo'yicha. Ko'p hollarda yetarli.
- cv=10 — kichik ma'lumot (< 1000 qator) yoki aniqroq baho kerak bo'lsa.
- cv=3 — ma'lumot juda katta yoki model sekin bo'lsa.
Vaqtli ma'lumot: TimeSeriesSplit
Oddiy CV fold larni aralashtiradi — ya'ni model kelajakda o'rganib o'tmishni bashorat qiladi. Vaqtli ma'lumotda bu taqiqlanadi.
from sklearn.model_selection import TimeSeriesSplit

tss = TimeSeriesSplit(n_splits=4)
soxta = np.arange(20)
print("TimeSeriesSplit — train har doim test dan OLDIN:")
for i, (tr_i, te_i) in enumerate(tss.split(soxta), 1):
    print(f"  {i}-fold: train={tr_i.min()}..{tr_i.max()}   test={te_i.min()}..{te_i.max()}")
TimeSeriesSplit — train har doim test dan OLDIN:
  1-fold: train=0..3   test=4..7
  2-fold: train=0..7   test=8..11
  3-fold: train=0..11   test=12..15
  4-fold: train=0..15   test=16..19
E'tibor bering: train to'plami o'sib boradi va test har doim undan keyin keladi. Bu — haqiqiy hayotdagi holat: siz bugungi ma'lumotda o'qitib, ertangi kunni bashorat qilasiz.
Bugun nima o'rgandik
show(pd.DataFrame([
    {"Tushuncha": "Bitta split yetarli emas", "Bitta jumla": "random_state o'zgarsa raqam o'zgaradi"},
    {"Tushuncha": "cross_val_score", "Bitta jumla": "k marta o'qitadi, har qator bir marta test bo'ladi"},
    {"Tushuncha": "O'rtacha ± tarqalish", "Bitta jumla": "Hisobotda ikkita son, bittasi emas"},
    {"Tushuncha": "StratifiedKFold", "Bitta jumla": "Classification da avtomatik — sinf nisbati saqlanadi"},
    {"Tushuncha": "Pipeline CV ichida", "Bitta jumla": "CV ga XOM ma'lumot beriladi, tozalangan emas"},
    {"Tushuncha": "cross_validate", "Bitta jumla": "Bir nechta metrika + train/test farqi (overfitting)"},
    {"Tushuncha": "Taqqoslash qoidasi", "Bitta jumla": "Farq tarqalishdan kichik bo'lsa — farq yo'q"},
    {"Tushuncha": "TimeSeriesSplit", "Bitta jumla": "Vaqt bo'lsa aralashtirmaslik"},
]))
| Tushuncha | Bitta jumla |
|---|---|
| Bitta split yetarli emas | random_state o'zgarsa raqam o'zgaradi |
| cross_val_score | k marta o'qitadi, har qator bir marta test bo'ladi |
| O'rtacha ± tarqalish | Hisobotda ikkita son, bittasi emas |
| StratifiedKFold | Classification da avtomatik — sinf nisbati saqlanadi |
| Pipeline CV ichida | CV ga XOM ma'lumot beriladi, tozalangan emas |
| cross_validate | Bir nechta metrika + train/test farqi (overfitting) |
| Taqqoslash qoidasi | Farq tarqalishdan kichik bo'lsa — farq yo'q |
| TimeSeriesSplit | Vaqt bo'lsa aralashtirmaslik |
Keyingi bobda eng muhim savol: raqam bor, endi nima qilaman?
Bu bobni bepul o'qidingiz.
Kitob o'rgatadi, lekin sizning kodingiz nega ishlamaganini ayta olmaydi. Kursda uy vazifangiz tekshiriladi.