Logistic regression
Sahna: 0 va 1 ni chiziqli model bilan bashorat qilsak
Bizda ikki target bor. 14-bobda narx_usd ni bashorat qildik — chiziqli regressiya bilan, muvaffaqiyatli.
Endi ijaraga_berildi_30k ga qaytamiz. U 0 yoki 1. Savol tabiiy: o'sha modelni ishlatsak bo'ladimi?
Sinab ko'ramiz. Bu — eng tez o'rganiladigan dars.
import pandas as pd
import numpy as np
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LinearRegression

df = pd.read_csv(DATA / "uy_ijara.csv")
son = ["xonalar", "maydon_m2", "qavat", "qavatlar_soni", "metro_km", "mebel"]
X, y = df[son], df["ijaraga_berildi_30k"]
X_tr, X_te, y_tr, y_te = train_test_split(X, y, test_size=0.3, random_state=42, stratify=y)

chiziqli = LinearRegression().fit(X_tr, y_tr)
b = chiziqli.predict(X_te)

print(f"Target faqat 0 yoki 1: {sorted(y.unique().tolist())}")
print()
print(f"Chiziqli model bashoratlari:")
print(f"  eng kichik : {b.min():.4f}")
print(f"  eng katta  : {b.max():.4f}")
print()
print(f"0 dan KICHIK bashoratlar: {int((b < 0).sum())} ta")
print(f"1 dan KATTA bashoratlar : {int((b > 1).sum())} ta")
Target faqat 0 yoki 1: [0, 1]

Chiziqli model bashoratlari:
  eng kichik : -0.1000
  eng katta  : 0.9031

0 dan KICHIK bashoratlar: 7 ta
1 dan KATTA bashoratlar : 0 ta
Mana muammo. Bizning ma'lumotda model -0.1000 gacha tushdi — 7 ta kvartira uchun manfiy bashorat berdi.
"Bu kvartira minus 10 foiz ehtimol bilan ijaraga beriladi" — bu jumla ma'nosiz.
Bu yerda yuqori chegara buzilmadi (eng katta bashorat 0.9031). Lekin bu omad: ma'lumot boshqacha bo'lsa yoki xususiyat qo'shilsa, model 1 dan ham oshib ketadi. Chiziqli funksiyani hech narsa to'xtatib turmaydi.
Chiziqli regressiya ehtimollik bermaydi
Ko'p talaba LinearRegression ni 0/1 target ga qo'llaydi va natijani "ehtimollik" deb o'qiydi. Bu xato: chiziqli funksiya cheksizlikka ketadi, ehtimollik esa 0 va 1 orasida qolishi shart.
Bizga chiqishni majburan [0, 1] ga siqadigan narsa kerak.
Sigmoid: har qanday sonni [0, 1] ga siqadi
import matplotlib.pyplot as plt

def sigmoid(z):
    return 1 / (1 + np.exp(-z))

print(f"{'z':>8} {'sigmoid(z)':>12}   izoh")
print("-" * 46)
for z in [-6, -2, -1, 0, 1, 2, 6]:
    s = sigmoid(z)
    izoh = "0 ga yopishadi" if s < 0.05 else ("1 ga yopishadi" if s > 0.95 else
           ("AYNAN o'rtada" if z == 0 else "o'rta zona"))
    print(f"{z:>8} {s:>12.6f}   {izoh}")
       z   sigmoid(z)   izoh
----------------------------------------------
      -6     0.002473   0 ga yopishadi
      -2     0.119203   o'rta zona
      -1     0.268941   o'rta zona
       0     0.500000   AYNAN o'rtada
       1     0.731059   o'rta zona
       2     0.880797   o'rta zona
       6     0.997527   1 ga yopishadi
z = np.linspace(-8, 8, 300)
rasm, axes = plt.subplots(1, 2, figsize=(13.5, 4.6))

axes[0].plot(z, sigmoid(z), "b-", lw=2.5)
axes[0].axhline(0.5, color="gray", ls=":", lw=1)
axes[0].axvline(0, color="gray", ls=":", lw=1)
axes[0].axhline(0, color="red", ls="--", lw=1, alpha=.6)
axes[0].axhline(1, color="red", ls="--", lw=1, alpha=.6)
axes[0].set_xlabel("z = x @ w + b"); axes[0].set_ylabel("sigmoid(z) = ehtimollik")
axes[0].set_title("Sigmoid — 0 va 1 orasida QOLADI", fontweight="bold")
axes[0].grid(alpha=.3)

axes[1].scatter(X_te.maydon_m2, y_te, alpha=.3, s=25, label="haqiqat (0/1)", color="#5f6368")
tartib = np.argsort(X_te.maydon_m2.to_numpy())
axes[1].plot(X_te.maydon_m2.to_numpy()[tartib], b[tartib], "r-", lw=2, label="chiziqli (chegaradan chiqadi)")
from sklearn.pipeline import Pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.linear_model import LogisticRegression
log_bir = Pipeline([("sc", StandardScaler()), ("m", LogisticRegression())]).fit(X_tr[["maydon_m2"]], y_tr)
e_bir = log_bir.predict_proba(X_te[["maydon_m2"]])[:, 1]
axes[1].plot(X_te.maydon_m2.to_numpy()[tartib], e_bir[tartib], "g-", lw=2.5, label="logistic (0-1 ichida)")
axes[1].axhline(0, color="k", ls=":", lw=.8); axes[1].axhline(1, color="k", ls=":", lw=.8)
axes[1].set_xlabel("maydon_m2"); axes[1].set_ylabel("ehtimollik")
axes[1].set_title("Ikki model yonma-yon", fontweight="bold")
axes[1].legend(fontsize=8.5); axes[1].grid(alpha=.3)
fig("sigmoid.png", caption="Chapda sigmoid funksiyasi. O'ngda: qizil chiziq 0 dan pastga va 1 dan yuqoriga chiqadi, yashil chiziq esa chegarada qoladi.")
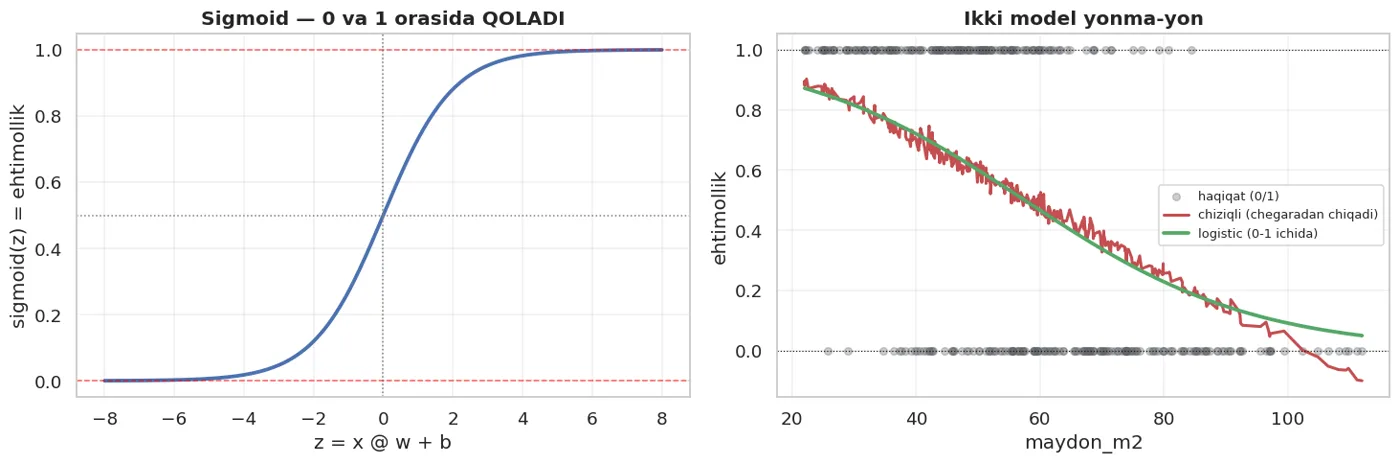
Chapda sigmoid funksiyasi. O'ngda: qizil chiziq 0 dan pastga va 1 dan yuqoriga chiqadi, yashil chiziq esa chegarada qoladi.
Logistic regression = chiziqli model + sigmoid:
Ya'ni 11-bobdagi x @ w + b o'zgarmadi — ustiga bitta funksiya qo'shildi.
Nega MSE emas, log loss
Model ehtimollik beradi. Xatoni qanday o'lchaymiz? MSE ni ishlatsak bo'lmaydimi?
def log_loss_bitta(p, y):
    p = np.clip(p, 1e-15, 1 - 1e-15)
    return -(y * np.log(p) + (1 - y) * np.log(1 - p))

print("Haqiqat y=1 bo'lganda, model turli ehtimollik bersa:")
print(f"{'bashorat p':>12} {'MSE jarima':>13} {'log loss jarima':>18}")
print("-" * 46)
for p in [0.9, 0.7, 0.5, 0.3, 0.1, 0.01]:
    print(f"{p:>12} {(p - 1)**2:>13.4f} {log_loss_bitta(p, 1):>18.4f}")
Haqiqat y=1 bo'lganda, model turli ehtimollik bersa:
  bashorat p    MSE jarima    log loss jarima
----------------------------------------------
         0.9        0.0100             0.1054
         0.7        0.0900             0.3567
         0.5        0.2500             0.6931
         0.3        0.4900             1.2040
         0.1        0.8100             2.3026
        0.01        0.9801             4.6052
Mana farq. Model p = 0.01 dedi, lekin haqiqat 1 edi — ya'ni juda ishonch bilan butunlay adashdi.
- MSE jarimasi:
0.98— kichik - Log loss jarimasi:
4.6— katta
Log loss ishonchli xatoni ancha qattiq jazolaydi. Va model shuning uchun ehtimollikni to'g'ri kalibrlashni o'rganadi.
Ikkinchi sabab: MSE bilan kosa buziladi
Log loss ning yana bir afzalligi bor. Sigmoid + MSE birlashsa, cost funksiya qavariq bo'lmaydi — ya'ni unda bir nechta chuqurlik paydo bo'ladi va gradient descent mahalliy chuqurlikka tushib qolishi mumkin (12-bob).
Sigmoid + log loss esa qavariq kosa beradi — bitta global minimum. Shuning uchun u tanlangan: faqat jarima uchun emas, optimizatsiya ishonchli bo'lishi uchun ham.
Koeffitsiyentlar: log-odds va odds ratio
Chiziqli regressiyada koeffitsiyent o'qilishi oson edi: "1 birlik oshsa, narx shuncha o'zgaradi".
Logistic da u boshqacha. Koeffitsiyent log-odds o'zgarishini beradi.
quvur = Pipeline([("sc", StandardScaler()), ("m", LogisticRegression(max_iter=2000))]).fit(X_tr, y_tr)
k = quvur.named_steps["m"].coef_[0]

jadval = pd.DataFrame({
    "xususiyat": son,
    "koeffitsiyent (log-odds)": k.round(4),
    "odds ratio (e^k)": np.exp(k).round(4),
}).assign(talqin=lambda d: [
    f"1 std oshsa, odds {abs(v-1)*100:.1f}% {'oshadi' if v > 1 else 'kamayadi'}"
    for v in d["odds ratio (e^k)"]
])
show(jadval.sort_values("koeffitsiyent (log-odds)", key=abs, ascending=False))
| xususiyat | koeffitsiyent (log-odds) | odds ratio (e^k) | talqin |
|---|---|---|---|
| maydon_m2 | -0.945 | 0.389 | 1 std oshsa, odds 61.1% kamayadi |
| xonalar | -0.175 | 0.84 | 1 std oshsa, odds 16.0% kamayadi |
| qavat | 0.086 | 1.09 | 1 std oshsa, odds 9.0% oshadi |
| metro_km | 0.041 | 1.042 | 1 std oshsa, odds 4.2% oshadi |
| qavatlar_soni | -0.028 | 0.972 | 1 std oshsa, odds 2.8% kamayadi |
| mebel | -0.021 | 0.979 | 1 std oshsa, odds 2.1% kamayadi |
Odds (imkoniyat nisbati) — bu p / (1-p). Agar ehtimollik 0.75 bo'lsa, odds = 3 ("uchga bir").
exp(koeffitsiyent) — odds ning ko'paytuvchisi. 1 dan katta bo'lsa imkoniyat oshadi, kichik bo'lsa kamayadi.
print("Odds va ehtimollik orasidagi aloqa:")
print(f"{'ehtimollik':>12} {'odds':>10} {'log-odds':>11}")
print("-" * 36)
for p in [0.1, 0.25, 0.5, 0.75, 0.9]:
    odds = p / (1 - p)
    print(f"{p:>12} {odds:>10.3f} {np.log(odds):>11.3f}")
print()
print("p = 0.5 da odds = 1 va log-odds = 0 -> sigmoid ning markazi")
Odds va ehtimollik orasidagi aloqa:
  ehtimollik       odds    log-odds
------------------------------------
         0.1      0.111      -2.197
        0.25      0.333      -1.099
         0.5      1.000       0.000
        0.75      3.000       1.099
         0.9      9.000       2.197

p = 0.5 da odds = 1 va log-odds = 0 -> sigmoid ning markazi
Logistic da koeffitsiyent ehtimollikni CHIZIQLI o'zgartirmaydi
"Koeffitsiyent 0.3, demak ehtimollik 30% oshadi" — noto'g'ri.
Ehtimollikka ta'siri boshlang'ich nuqtaga bog'liq. p = 0.5 dan boshlasa katta siljiydi, p = 0.95 dan boshlasa deyarli siljimaydi — chunki sigmoid u yerda yassi.
Shuning uchun odds ratio ishlatiladi: u har qanday nuqtada bir xil ko'paytuvchi.
Multiclass: uchta sinf bo'lsa
42-bobdagi mashqda penguins bilan ishlagansiz. Logistic regression uchta sinfni ham eplaydi — ikki yo'l bilan.
from sklearn.impute import SimpleImputer
from sklearn.compose import ColumnTransformer
from sklearn.preprocessing import OneHotEncoder
from sklearn.model_selection import cross_val_score

pg = pd.read_csv(DATA / "penguins.csv")
pson = ["bill_length_mm", "bill_depth_mm", "flipper_length_mm", "body_mass_g"]
pmatn = ["island", "sex"]
Xp, yp = pg[pson + pmatn], pg["species"]

def p_quvur(**kw):
    return Pipeline([
        ("t", ColumnTransformer([
            ("son", Pipeline([("i", SimpleImputer(strategy="median")), ("sc", StandardScaler())]), pson),
            ("matn", Pipeline([("i", SimpleImputer(strategy="most_frequent")),
                               ("o", OneHotEncoder(handle_unknown="ignore"))]), pmatn),
        ])),
        ("m", LogisticRegression(max_iter=3000, **kw)),
    ])

for nom, kw in [("multinomial (softmax)", {}), ("one-vs-rest", {"multi_class": "ovr"})]:
    try:
        bb = cross_val_score(p_quvur(**kw), Xp, yp, cv=5, scoring="f1_macro")
        print(f"  {nom:24s} macro F1 = {bb.mean():.4f} ±{bb.std():.4f}")
    except Exception as e:
        print(f"  {nom:24s} {type(e).__name__}")
  multinomial (softmax)    macro F1 = 0.9939 ±0.0076
  one-vs-rest              macro F1 = 0.9939 ±0.0076
mp = p_quvur().fit(Xp, yp)
print("Sinflar:", mp.named_steps["m"].classes_.tolist())
print("Koeffitsiyentlar shakli:", mp.named_steps["m"].coef_.shape,
      "-> har SINF uchun alohida koeffitsiyent to'plami")
print()
e = mp.predict_proba(Xp.head(4))
print("Birinchi 4 pingvin uchun ehtimolliklar (har qator yig'indisi = 1):")
print(pd.DataFrame(e.round(4), columns=mp.named_steps["m"].classes_).to_string(index=False))
print()
print("Yig'indilar:", e.sum(axis=1).round(6).tolist())
Sinflar: ['Adelie', 'Chinstrap', 'Gentoo']
Koeffitsiyentlar shakli: (3, 9) -> har SINF uchun alohida koeffitsiyent to'plami

Birinchi 4 pingvin uchun ehtimolliklar (har qator yig'indisi = 1):
 Adelie  Chinstrap  Gentoo
 0.9995     0.0004  0.0001
 0.9911     0.0066  0.0023
 0.9742     0.0234  0.0024
 0.8871     0.0505  0.0625

Yig'indilar: [1.0, 1.0, 1.0, 1.0]
Softmax har sinfga ehtimollik beradi va ularning yig'indisi aynan 1 bo'ladi. sklearn hozirgi versiyalarida sukut bo'yicha shuni ishlatadi.
Threshold — 8-bobga qaytish
Logistic regression ehtimollik beradi. predict() esa 0.5 chegarasini qo'llaydi. 8-bobda shu chegarani surganmiz.
from sklearn.metrics import precision_score, recall_score, f1_score, accuracy_score

ehtimol = quvur.predict_proba(X_te)[:, 1]
print(f"{'chegara':>9} {'precision':>11} {'recall':>8} {'F1':>7}")
print("-" * 38)
for t in [0.3, 0.5, 0.7]:
    bb = (ehtimol >= t).astype(int)
    print(f"{t:>9} {precision_score(y_te, bb, zero_division=0):>11.4f} "
          f"{recall_score(y_te, bb, zero_division=0):>8.4f} {f1_score(y_te, bb, zero_division=0):>7.4f}")
print()
print("Shuning uchun logistic regression amalda qulay: u ehtimollik beradi,")
print("va siz chegarani biznes talabiga qarab tanlaysiz (8-bob).")
  chegara   precision   recall      F1
--------------------------------------
      0.3      0.6146   0.9725  0.7532
      0.5      0.7626   0.8297  0.7947
      0.7      0.8554   0.3901  0.5358

Shuning uchun logistic regression amalda qulay: u ehtimollik beradi,
va siz chegarani biznes talabiga qarab tanlaysiz (8-bob).
Qachon logistic regression tanlanadi
show(pd.DataFrame([
    {"Afzalligi": "Ehtimollik beradi", "Nega muhim": "Chegarani surish mumkin (8-bob)"},
    {"Afzalligi": "Tushuntiriladi", "Nega muhim": "Odds ratio — bank, tibbiyot talab qiladi"},
    {"Afzalligi": "Tez va arzon", "Nega muhim": "Millionlab qator bilan ham ishlaydi"},
    {"Afzalligi": "Kam overfitting", "Nega muhim": "Oddiy model, kam parametr"},
    {"Kamchiligi": "Faqat CHIZIQLI chegara", "Nega muhim": "Murakkab naqshni ko'rmaydi -> daraxt (17-bob)"},
    {"Kamchiligi": "Scaling kerak", "Nega muhim": "Gradient va regularizatsiya uchun"},
    {"Kamchiligi": "Xususiyatlarni o'zi yaratmaydi", "Nega muhim": "Qo'lda feature engineering kerak (22-bob)"},
]))
| Afzalligi | Nega muhim | Kamchiligi |
|---|---|---|
| Ehtimollik beradi | Chegarani surish mumkin (8-bob) | NaN |
| Tushuntiriladi | Odds ratio — bank, tibbiyot talab qiladi | NaN |
| Tez va arzon | Millionlab qator bilan ham ishlaydi | NaN |
| Kam overfitting | Oddiy model, kam parametr | NaN |
| NaN | Murakkab naqshni ko'rmaydi -> daraxt (17-bob) | Faqat CHIZIQLI chegara |
| NaN | Gradient va regularizatsiya uchun | Scaling kerak |
| NaN | Qo'lda feature engineering kerak (22-bob) | Xususiyatlarni o'zi yaratmaydi |
Chiziqli chegara cheklovini ko'rib ketaylik — bu 17-bobga ko'prik:
from sklearn.tree import DecisionTreeClassifier

# sun'iy "halqa" naqshi: chiziqli chegara bilan ajratib bo'lmaydi
r = np.random.default_rng(42)
n = 600
burchak = r.uniform(0, 2 * np.pi, n)
radius = np.where(r.random(n) < 0.5, r.normal(1, .25, n), r.normal(3, .3, n))
Xh = np.c_[radius * np.cos(burchak), radius * np.sin(burchak)]
yh = (radius > 2).astype(int)

for nom, m in [("Logistic Regression", LogisticRegression()),
               ("Decision Tree", DecisionTreeClassifier(max_depth=6, random_state=42))]:
    bb = cross_val_score(Pipeline([("sc", StandardScaler()), ("m", m)]), Xh, yh, cv=5)
    print(f"  {nom:22s} accuracy = {bb.mean():.4f} ±{bb.std():.4f}")
print()
print("Halqa shaklidagi ma'lumotda chiziqli chegara ishlamaydi.")
print("17-bobda daraxt shunday naqshni qanday ushlashini ko'ramiz.")
  Logistic Regression    accuracy = 0.5350 ±0.0220
  Decision Tree          accuracy = 0.9883 ±0.0085

Halqa shaklidagi ma'lumotda chiziqli chegara ishlamaydi.
17-bobda daraxt shunday naqshni qanday ushlashini ko'ramiz.
Bugun nima o'rgandik
show(pd.DataFrame([
    {"Tushuncha": "Muammo", "Bitta jumla": "Chiziqli model 0-1 dan chiqib ketadi"},
    {"Tushuncha": "Sigmoid", "Bitta jumla": "Har qanday sonni [0,1] ga siqadi"},
    {"Tushuncha": "Model", "Bitta jumla": "sigmoid(x @ w + b) — 11-bobdagi amal + bitta funksiya"},
    {"Tushuncha": "Log loss", "Bitta jumla": "Ishonchli xatoni qattiq jazolaydi; kosani qavariq qiladi"},
    {"Tushuncha": "Koeffitsiyent", "Bitta jumla": "log-odds; exp(k) = odds ko'paytuvchisi"},
    {"Tushuncha": "Multiclass", "Bitta jumla": "Softmax — har sinfga ehtimollik, yig'indi = 1"},
    {"Tushuncha": "Cheklovi", "Bitta jumla": "Faqat chiziqli chegara — halqani ajratmaydi"},
]))
| Tushuncha | Bitta jumla |
|---|---|
| Muammo | Chiziqli model 0-1 dan chiqib ketadi |
| Sigmoid | Har qanday sonni [0,1] ga siqadi |
| Model | sigmoid(x @ w + b) — 11-bobdagi amal + bitta funksiya |
| Log loss | Ishonchli xatoni qattiq jazolaydi; kosani qavariq qiladi |
| Koeffitsiyent | log-odds; exp(k) = odds ko'paytuvchisi |
| Multiclass | Softmax — har sinfga ehtimollik, yig'indi = 1 |
| Cheklovi | Faqat chiziqli chegara — halqani ajratmaydi |
Keyingi bobda: 14-bobda koeffitsiyentlar bo'linishdan bo'linishga sakragan edi. Shuni tuzatamiz.
Bu bobni bepul o'qidingiz.
Kitob o'rgatadi, lekin sizning kodingiz nega ishlamaganini ayta olmaydi. Kursda uy vazifangiz tekshiriladi.