Loss va tayinlash: model qanday o'rganadi
Bu bobning kodi: kod/06_loss_tayinlash.py — kitob papkasidan ishga tushiring: python kod/06_loss_tayinlash.py
O'qitish ikki savoldan iborat
5-bobda o'qitilgan model 8 400 katakdan 5 ta box ni qanday chiqarishini ko'rdik. O'qitishda esa teskari savol turadi: rasmda odam qo'lda belgilagan haqiqiy obyektlar bor (ground truth, qisqacha GT). Model qanchalik xato qildi va vaznlarni qaysi tomonga o'zgartirish kerak?
Buning uchun ikki savolga javob kerak:
- Tayinlash (assignment). 8 400 katakdan qaysilari qaysi obyekt uchun javobgar? Qolganlari "fon" — ular hech narsa topmasligi kerak.
- Loss. Bashorat haqiqatdan qanchalik uzoq? Uchta son: sinf xatosi, box xatosi, DFL xatosi.
Bu bobda ikkalasini ultralytics kodidan (ultralytics/utils/tal.py va ultralytics/utils/loss.py) qo'lda qayta yozamiz va natijani kutubxonaning o'zi hisoblagan loss bilan solishtiramiz.
Misol: COCO dagi bitta rasm
2-bobda yuklab olingan COCO val dan bitta rasm va uning label fayli. Label formati 1-bobdagi: sinf markaz_x markaz_y kenglik balandlik, 0..1 oralig'ida.
import math
import cv2
import numpy as np
import pandas as pd
import torch
import torch.nn.functional as F
import matplotlib.pyplot as plt
from ultralytics import YOLO
from ultralytics.cfg import get_cfg
from ultralytics.data.augment import LetterBox
from ultralytics.utils import DEFAULT_CFG, LOGGER
from ultralytics.utils.loss import E2ELoss, v8DetectionLoss
from ultralytics.utils.tal import TaskAlignedAssigner

LOGGER.setLevel("ERROR")

nom = "000000031093"
asl = cv2.imread(f"datasets/coco/images/val2017/{nom}.jpg")
h0, w0 = asl.shape[:2]
label = np.loadtxt(f"datasets/coco/labels/val2017/{nom}.txt", ndmin=2)
print(open(f"datasets/coco/labels/val2017/{nom}.txt").read().strip())

lb = LetterBox((640, 640), auto=False)(image=asl)                  # o'qitishdagi kabi to'liq kvadrat 640x640
g = min(640 / h0, 640 / w0)
px, py = (640 - w0 * g) / 2, (640 - h0 * g) / 2
x = torch.from_numpy(lb[:, :, ::-1].copy()).permute(2, 0, 1)[None].float() / 255

# GT: normallashgan xywh (asl rasm) -> letterbox pikselidagi xyxy
xc, yc = label[:, 1] * w0 * g + px, label[:, 2] * h0 * g + py
bw, bh = label[:, 3] * w0 * g, label[:, 4] * h0 * g
gt_box = torch.tensor(np.stack([xc - bw / 2, yc - bh / 2, xc + bw / 2, yc + bh / 2], 1), dtype=torch.float32)
gt_sinf = torch.tensor(label[:, 0]).long()

model = YOLO("weights/yolo11n.pt")
nomlar = model.names
show(pd.DataFrame({"GT": range(len(gt_box)), "sinf": [nomlar[int(c)] for c in gt_sinf],
                   "kenglik, px": bw.round(), "balandlik, px": bh.round()}))
0 0.521188 0.476725 0.363344 0.590587
36 0.461625 0.76034 0.14575 0.0287089
0 0.88225 0.0655751 0.0465313 0.0865493
24 0.982766 0.213415 0.0285938 0.0464554
36 0.773828 0.0523357 0.037 0.0211972
0 0.802531 0.0453286 0.050875 0.0906573
| GT | sinf | kenglik, px | balandlik, px |
|---|---|---|---|
| 0 | person | 233 | 252 |
| 1 | skateboard | 93 | 12 |
| 2 | person | 30 | 37 |
| 3 | backpack | 18 | 20 |
| 4 | skateboard | 24 | 9 |
| 5 | person | 33 | 39 |
Katta skeytbordchi, uning skeytbordi (yupqa va keng), fonda ikki kichik odam, yana bitta kichik skeytbord va o'ng chetda kichkina ryukzak. Katta va kichik obyektlar aralash — tayinlashni ko'rish uchun yaxshi misol.
Tarmoqning xom chiqishi va 8 400 katakning har biri chizgan box (5-bobdagi dekodlash):
def bashorat(tarmoq):
    """Xom chiqish -> (sinf logit lari (8400, 80), DFL logit lari (8400, 64), box lar (8400, 4) xyxy piksel)."""
    with torch.no_grad():
        _, ichki = tarmoq(x)
    z = ichki["boxes"][0].T
    d = (z.view(-1, 4, 16).softmax(-1) * torch.arange(16)).sum(-1) * qadam[:, None]   # DFL -> piksel masofa
    return ichki["scores"][0].T, z, torch.cat([anc - d[:, :2], anc + d[:, 2:]], 1)

tarmoq = model.model.eval()
anc, qadam = [], []
for H, s in [(80, 8), (40, 16), (20, 32)]:                        # 640x640 kirish: uch to'r
    yy, xx = torch.meshgrid(torch.arange(H) + 0.5, torch.arange(H) + 0.5, indexing="ij")
    anc.append(torch.stack([xx.flatten(), yy.flatten()], 1) * s)  # katak markazlari, pikselda
    qadam.append(torch.full((H * H,), float(s)))
anc, qadam = torch.cat(anc), torch.cat(qadam)                    # (8400, 2), (8400,)

logit, z, p_box = bashorat(tarmoq)
ball = logit.sigmoid()
print("kataklar:", len(anc), "| sinf logit lari:", tuple(logit.shape), "| box lar:", tuple(p_box.shape))
kataklar: 8400 | sinf logit lari: (8400, 80) | box lar: (8400, 4)
CIoU: box larni solishtirishning yaxshiroq usuli
Tayinlash ham, box loss ham oddiy IoU emas, CIoU (Complete IoU) ishlatadi:
ρ — ikki box markazlari orasidagi masofa, c — ikkalasini o'rab turuvchi eng kichik box diagonali, v — shakl (eni va bo'yi nisbati) farqi. Ultralytics kodini (utils/metrics.py, bbox_iou) aynan takrorlaymiz, kichik eps qo'shimchalari bilan birga:
def ciou(a, b, eps=1e-7):
    """Complete IoU. a, b: (..., 4) xyxy."""
    w1, h1 = a[..., 2] - a[..., 0], a[..., 3] - a[..., 1] + eps
    w2, h2 = b[..., 2] - b[..., 0], b[..., 3] - b[..., 1] + eps
    kesishma = (torch.minimum(a[..., 2], b[..., 2]) - torch.maximum(a[..., 0], b[..., 0])).clamp(0) * \
               (torch.minimum(a[..., 3], b[..., 3]) - torch.maximum(a[..., 1], b[..., 1])).clamp(0)
    iou = kesishma / (w1 * h1 + w2 * h2 - kesishma + eps)
    cw = torch.maximum(a[..., 2], b[..., 2]) - torch.minimum(a[..., 0], b[..., 0])    # o'rab turuvchi box
    ch = torch.maximum(a[..., 3], b[..., 3]) - torch.minimum(a[..., 1], b[..., 1])
    c2 = cw ** 2 + ch ** 2 + eps                                                      # uning diagonali kvadrati
    rho2 = ((b[..., 0] + b[..., 2] - a[..., 0] - a[..., 2]) ** 2 + (b[..., 1] + b[..., 3] - a[..., 1] - a[..., 3]) ** 2) / 4
    v = 4 / math.pi ** 2 * (torch.atan(w2 / h2) - torch.atan(w1 / h1)) ** 2
    alfa = v / (v - iou + 1 + eps)
    return iou - rho2 / c2 - alfa * v

def iou(a, b):
    """Oddiy IoU (1-bob)."""
    kesishma = (torch.minimum(a[2], b[2]) - torch.maximum(a[0], b[0])).clamp(0) * \
               (torch.minimum(a[3], b[3]) - torch.maximum(a[1], b[1])).clamp(0)
    yuza = lambda q: (q[2] - q[0]) * (q[3] - q[1])
    return kesishma / (yuza(a) + yuza(b) - kesishma)

gt = torch.tensor([100.0, 100, 200, 200])                          # 100x100 lik GT
holatlar = {"markazi bir xil, kattaroq": [79.29, 79.29, 220.71, 220.71],
            "o'ngga siljigan":            [133.33, 100, 233.33, 200],
            "yuzi bir xil, shakli yotiq": [75, 116.67, 225, 183.33],
            "umuman tegmaydi":           [300, 100, 400, 200]}
show(pd.DataFrame([{"holat": k, "IoU": round(float(iou(gt, torch.tensor(b))), 3),
                    "CIoU": round(float(ciou(gt, torch.tensor(b))), 3)} for k, b in holatlar.items()]))
| holat | IoU | CIoU |
|---|---|---|
| markazi bir xil, kattaroq | 0.5 | 0.5 |
| o'ngga siljigan | 0.5 | 0.46 |
| yuzi bir xil, shakli yotiq | 0.5 | 0.495 |
| umuman tegmaydi | 0 | -0.4 |
Birinchi uchta holatda IoU bir xil — 0.5. CIoU esa ularni ajratadi: markazi siljigan box ko'proq, shakli boshqa box ozroq jazolanadi. To'rtinchi holat eng muhimi: box lar tegmasa, IoU nol va u "qaysi tomonga siljitish kerak" haqida hech narsa demaydi — gradient ham nol. CIoU esa manfiy va box GT ga yaqinlashgan sari o'sadi. O'qitishning boshida, tasodifiy box lar hali GT ga tegmaganda, aynan shu kerak.
Tayinlash (TAL): qaysi kataklar javobgar
YOLOv8 dan beri ultralytics Task-Aligned Assigner (TAL) ishlatadi. U to'rt qadamda ishlaydi:
- Nomzodlar. Faqat markazi GT box ichiga tushgan kataklar. Qo'shimcha qoida: GT ning biror tomoni eng kichik qadamdan (8 px) qisqa bo'lsa, o'sha tomon 16 px ga kengaytiriladi — aks holda juda mayda obyekt ichiga birorta ham katak markazi tushmasligi mumkin.
- Moslik bali. Har nomzod uchun ikki narsa o'lchanadi: s — katak GT sinfiga bergan ehtimol, u — katak chizgan box ning GT bilan CIoU si. Ular bitta songa birlashtiriladi.
- Eng yaxshi 10 tasi. Har GT uchun moslik bali bo'yicha eng yaxshi 10 ta katak javobgar deb belgilanadi.
- Nizolar. Bitta katak ikki GT ga tanlansa, u box i ko'proq mos kelgan (u kattaroq) GT ga beriladi.
Moslik bali:
β = 6 ning ma'nosi raqamlarda:
show(pd.DataFrame([{"s (sinf ehtimoli)": s, "u (box mosligi)": u, "t = s^0.5 * u^6": round(s ** 0.5 * u ** 6, 4)}
                   for s, u in [(0.9, 0.5), (0.9, 0.7), (0.3, 0.9), (0.9, 0.9)]]))
| s (sinf ehtimoli) | u (box mosligi) | t = s^0.5 * u^6 |
|---|---|---|
| 0.9 | 0.5 | 0.015 |
| 0.9 | 0.7 | 0.112 |
| 0.3 | 0.9 | 0.291 |
| 0.9 | 0.9 | 0.504 |
0.9 ishonch bilan yomon box chizgan katak (u = 0.5) ishonchi 0.3 bo'lsa ham yaxshi box chizgan katakdan (u = 0.9) ancha past baho oladi. Nomi shundan: tayinlash vazifaga moslangan — ikkala vazifada yaxshi bo'lgan kataklarni tanlaydi, box sifati esa ancha kuchliroq hisobga olinadi.
To'rt qadamni yozamiz:
def tal(ball, p_box, gt_sinf, gt_box, topk=10, alfa=0.5, beta=6.0):
    """Bitta rasm uchun TAL. Qaytaradi: musbat (M, N) 0/1, t (M, N), u (M, N), ichida (M, N)."""
    M, N = len(gt_box), len(anc)
    markaz, wh = (gt_box[:, :2] + gt_box[:, 2:]) / 2, gt_box[:, 2:] - gt_box[:, :2]
    wh = torch.where(wh < 8, torch.tensor(16.0), wh)                                  # juda qisqa tomon -> 16 px
    g = torch.cat([markaz - wh / 2, markaz + wh / 2], 1)
    ichida = torch.cat([anc[None] - g[:, None, :2], g[:, None, 2:] - anc[None]], -1).amin(-1) > 1e-9   # 1-qadam
    s = ball[:, gt_sinf].T * ichida                                                   # (M, N)
    u = torch.zeros(M, N)
    u[ichida] = ciou(gt_box[:, None].expand(M, N, 4)[ichida], p_box[None].expand(M, N, 4)[ichida]).clamp(0)
    t = s.pow(alfa) * u.pow(beta)                                                     # 2-qadam
    musbat = torch.zeros(M, N).scatter_(1, t.topk(topk, dim=1).indices, 1.0) * ichida   # 3-qadam
    nizo = musbat.sum(0) > 1                                                          # 4-qadam
    if nizo.any():
        eng_mos = torch.zeros(M, N).scatter_(0, u.argmax(0, keepdim=True), 1.0)
        musbat = torch.where(nizo[None], eng_mos, musbat)
    return musbat, t, u, ichida

musbat, t, u, ichida = tal(ball, p_box, gt_sinf, gt_box)
fg = musbat.sum(0) > 0                                               # javobgar kataklar
gt_idx = musbat.argmax(0)                                            # har katak qaysi GT ga javobgar

tayinlovchi = TaskAlignedAssigner(topk=10, num_classes=80, alpha=0.5, beta=6.0, stride=[8, 16, 32])
_, _, u_maqsad, u_fg, u_idx = tayinlovchi(ball[None], p_box[None], anc, gt_sinf.view(1, -1, 1),
                                          gt_box[None], torch.ones(1, len(gt_box), 1))
print("javobgar kataklar: bizda", int(fg.sum()), "| ultralytics da", int(u_fg.sum()))
print("farq qilgan kataklar:", int((fg != u_fg[0]).sum()),
      "| GT raqami farq qilganlar:", int((gt_idx[fg] != u_idx[0][fg]).sum()))
javobgar kataklar: bizda 50 | ultralytics da 50
farq qilgan kataklar: 0 | GT raqami farq qilganlar: 0
Har GT ga nechta katak tushdi va qaysi to'rlardan:
daraja = np.where(np.arange(8400) < 6400, "P3", np.where(np.arange(8400) < 8000, "P4", "P5"))
qatorlar = []
for k in range(len(gt_box)):
    tanlangan = daraja[torch.nonzero(musbat[k]).flatten().numpy()]
    qatorlar.append({"GT": k, "sinf": nomlar[int(gt_sinf[k])], "nomzodlar": int(ichida[k].sum()),
                     "javobgar": len(tanlangan), **{p: int((tanlangan == p).sum()) for p in ("P3", "P4", "P5")}})
show(pd.DataFrame(qatorlar))
| GT | sinf | nomzodlar | javobgar | P3 | P4 | P5 |
|---|---|---|---|---|---|---|
| 0 | person | 1 165 | 10 | 0 | 0 | 10 |
| 1 | skateboard | 27 | 10 | 8 | 0 | 2 |
| 2 | person | 19 | 10 | 7 | 3 | 0 |
| 3 | backpack | 7 | 7 | 6 | 1 | 0 |
| 4 | skateboard | 3 | 3 | 3 | 0 | 0 |
| 5 | person | 26 | 10 | 8 | 2 | 0 |
ranglar = plt.cm.tab10(np.arange(len(gt_box)))
_, axes = plt.subplots(1, 2, figsize=(13, 6.5), gridspec_kw={"width_ratios": [1, 1]})
for ax, (xlim, ylim, kattalik) in zip(axes, [((0, 640), (640, 0), 2.5), ((460, 640), (230, 95), 9)]):
    ax.imshow(lb[:, :, ::-1])
    for k, (b, r) in enumerate(zip(gt_box.tolist(), ranglar)):
        ax.add_patch(plt.Rectangle(b[:2], b[2] - b[0], b[3] - b[1], fill=False, color=r, lw=2))
        idx = torch.nonzero(musbat[k]).flatten()
        ax.scatter(anc[idx, 0], anc[idx, 1], s=qadam[idx] * kattalik, color=r, edgecolor="black", zorder=3)
    ax.set_xlim(*xlim)
    ax.set_ylim(*ylim)
    ax.axis("off")
axes[1].set_title("o'ng-yuqori burchak, kattalashtirilgan")
fig("tayinlash.png", "Rangli ramka — GT, shu rangdagi nuqtalar — unga javobgar kataklar markazi. Katta nuqta — P5, o'rtachasi — P4, kichik — P3.")
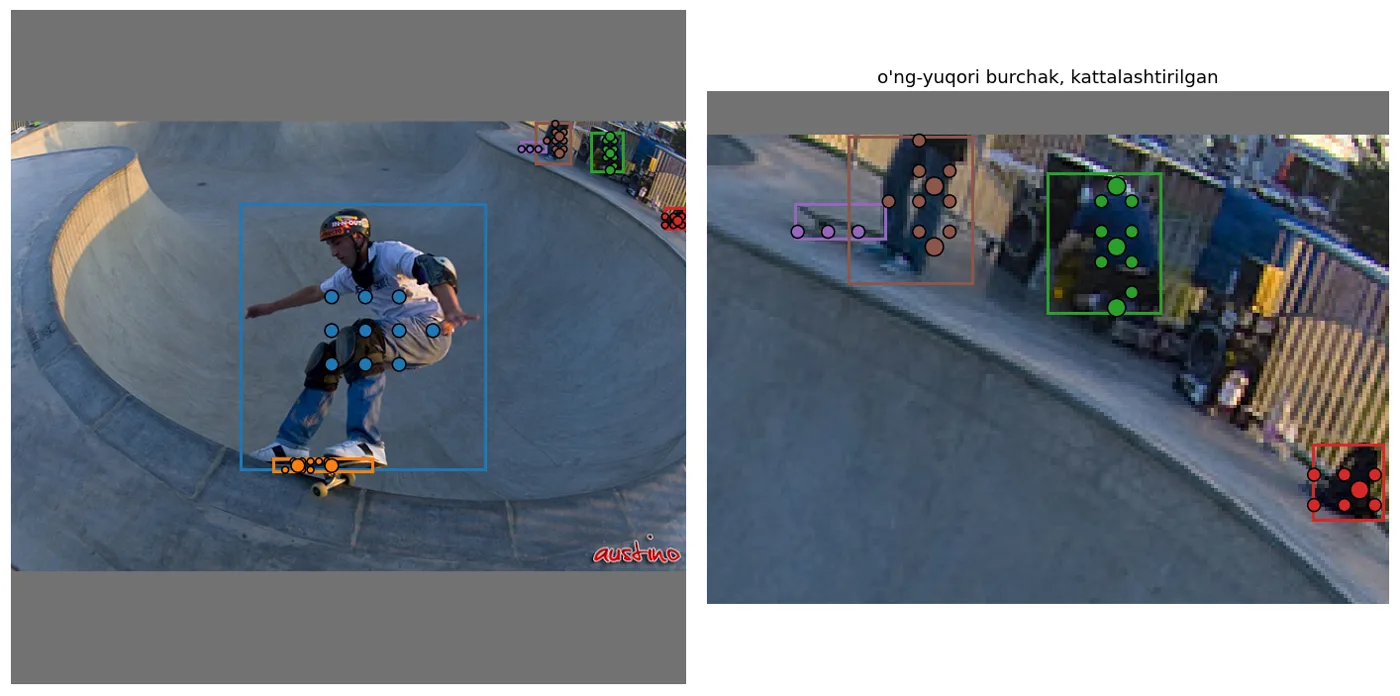
Rangli ramka — GT, shu rangdagi nuqtalar — unga javobgar kataklar markazi. Katta nuqta — P5, o'rtachasi — P4, kichik — P3.
Katta odam 165 ta nomzoddan faqat 10 tasini oladi — hammasi P5 dan va hammasi tanasining markaziy qismida: chetdagi kataklarning box lari kamroq mos. Kichik odamlar va ryukzak asosan P3 dan. Kichik skeytbord ichiga atigi 3 ta katak markazi tushgan, shuning uchun topk = 10 bo'lsa ham u 3 ta javobgar oladi. Mayda obyekt o'qitishda kamroq signal oladi — bu 1-bobdagi kichik obyekt muammosining yana bir sababi. Kulrang yo'laklar — letterbox to'ldirishi.
Maqsad ballari: 1 emas
Javobgar katak uchun sinf maqsadi (target) 1 emas. U moslik baliga qarab kichraytiriladi: GT ning eng yaxshi katagi o'z CIoU sini oladi, qolganlari esa t / t_max nisbatida kamroq. Bu yerda u_max — shu GT ga javobgar kataklar ichidagi eng katta CIoU, t_max — eng katta moslik bali:
t_mus = t * musbat
norm = (t_mus * (u * musbat).amax(1, keepdim=True) / (t_mus.amax(1, keepdim=True) + 1e-9)).amax(0)   # (8400,)
maqsad = torch.zeros(8400, 80)
maqsad[fg, gt_sinf[gt_idx[fg]]] = norm[fg]
print("ultralytics maqsadlari bilan eng katta farq:", float((maqsad - u_maqsad[0]).abs().max()))

k0 = torch.nonzero(musbat[0]).flatten()                              # katta odamning 10 ta katagi
show(pd.DataFrame({"katak": k0.numpy(), "s": ball[k0, gt_sinf[0]].numpy(), "u (CIoU)": u[0, k0].numpy(),
                   "t": t[0, k0].numpy(), "maqsad y": norm[k0].numpy()}).sort_values("t", ascending=False).round(3), 10)
ultralytics maqsadlari bilan eng katta farq: 3.5762786865234375e-07
| katak | s | u (CIoU) | t | maqsad y |
|---|---|---|---|---|
| 8 211 | 0.91 | 0.94 | 0.656 | 0.94 |
| 8 191 | 0.916 | 0.939 | 0.656 | 0.938 |
| 8 209 | 0.899 | 0.939 | 0.651 | 0.932 |
| 8 192 | 0.913 | 0.937 | 0.649 | 0.928 |
| 8 210 | 0.906 | 0.938 | 0.648 | 0.928 |
| 8 171 | 0.913 | 0.937 | 0.646 | 0.925 |
| 8 170 | 0.922 | 0.936 | 0.646 | 0.925 |
| 8 189 | 0.913 | 0.936 | 0.642 | 0.919 |
| 8 190 | 0.917 | 0.935 | 0.642 | 0.919 |
| 8 169 | 0.918 | 0.934 | 0.638 | 0.913 |
Bu nega muhim: model "odam bor" ni emas, "odam bor va mening box im shunchalik yaxshi" ni o'rganadi. Shuning uchun YOLO ning ishonch qiymati box sifati bilan bog'liq bo'ladi, va NMS eng ishonchli box ni qoldirganda, odatda eng aniq box ham shu bo'ladi.
Uchta loss
Sinf: BCE. Hamma 8 400 × 80 juftlik uchun binary cross-entropy. Fon kataklari ham qatnashadi — ularning maqsadi 0, ular "hech narsa yo'q" deyishni o'rganadi. T — hamma maqsadlar yig'indisi:
Box: CIoU. Faqat javobgar kataklar uchun, har biri o'z maqsad bali bilan tortilgan:
DFL. Haqiqiy masofa d (katak birligida) ikki bin orasida yotadi: i = ⌊d⌋ va i + 1. Loss shu ikki bin ga, d* ga yaqinligi bo'yicha tortilgan cross-entropy:
Masalan d* = 6.3 bo'lsa: 6-bin ga 0.7, 7-bin ga 0.3 og'irlik. 5-bobda ko'rgan "ikki qo'shni bin ga bo'lingan ehtimol" aynan shu loss natijasi.
Jami — uchalasi default.yaml dagi koeffitsiyentlar bilan (box: 7.5, cls: 0.5, dfl: 1.5):
Qo'lda yozamiz va ultralytics ning v8DetectionLoss klassi bilan solishtiramiz. O'qitilgan yolo11n va xuddi shu arxitekturaning o'qitilmagan (tasodifiy vaznli) nusxasi uchun:
def yoqotish(logit, z, p_box):
    """Qo'lda: TAL -> maqsadlar -> uchta loss, koeffitsiyentlar bilan."""
    musbat, t, u, _ = tal(logit.sigmoid(), p_box, gt_sinf, gt_box)
    fg, gt_idx = musbat.sum(0) > 0, musbat.argmax(0)
    t_mus = t * musbat
    norm = (t_mus * (u * musbat).amax(1, keepdim=True) / (t_mus.amax(1, keepdim=True) + 1e-9)).amax(0)
    maqsad = torch.zeros_like(logit)
    maqsad[fg, gt_sinf[gt_idx[fg]]] = norm[fg]
    T = max(float(maqsad.sum()), 1.0)
    L_cls = F.binary_cross_entropy_with_logits(logit, maqsad, reduction="sum") / T
    w, t_box = maqsad.sum(1)[fg], gt_box[gt_idx[fg]]
    L_box = ((1 - ciou(p_box[fg], t_box)) * w).sum() / T
    d_haq = (torch.cat([anc[fg] - t_box[:, :2], t_box[:, 2:] - anc[fg]], 1) / qadam[fg, None]).clamp(0, 14.99)
    i = d_haq.long()                                                 # chap bin
    log_p = F.log_softmax(z[fg].view(-1, 4, 16), -1)
    ce = -(log_p.gather(-1, i[..., None])[..., 0] * (i + 1 - d_haq) + log_p.gather(-1, (i + 1)[..., None])[..., 0] * (d_haq - i))
    L_dfl = (ce.mean(1) * w).sum() / T
    return [7.5 * float(L_box), 0.5 * float(L_cls), 1.5 * float(L_dfl)]

batch = {"batch_idx": torch.zeros(len(gt_box)), "cls": gt_sinf.float(),
         "bboxes": torch.tensor(np.stack([xc, yc, bw, bh], 1) / 640, dtype=torch.float32)}   # ultralytics formati

torch.manual_seed(0)                                                 # tasodifiy vaznlar har safar bir xil bo'lsin
qatorlar = []
for nom_, net in [("o'qitilgan", tarmoq), ("o'qitilmagan", YOLO("yolo11n.yaml").model.eval())]:
    net.args = get_cfg(DEFAULT_CFG)                                  # loss koeffitsiyentlari shu yerdan olinadi
    with torch.no_grad():
        _, ichki = net(x)
        ultra = v8DetectionLoss(net).get_assigned_targets_and_loss(ichki, batch)[2].tolist()
    biz = yoqotish(*bashorat(net))
    for tur, qiymat in [("biz", biz), ("ultralytics", ultra)]:
        qatorlar.append({"model": nom_, "hisob": tur, "7.5 x box": qiymat[0], "0.5 x cls": qiymat[1],
                         "1.5 x dfl": qiymat[2], "jami": sum(qiymat)})
show(pd.DataFrame(qatorlar).round(4))
| model | hisob | 7.5 x box | 0.5 x cls | 1.5 x dfl | jami |
|---|---|---|---|---|---|
| o'qitilgan | biz | 1.685 | 1.47 | 1.202 | 4.356 |
| o'qitilgan | ultralytics | 1.685 | 1.47 | 1.202 | 4.356 |
| o'qitilmagan | biz | 1.912 | 6.513 | 4.159 | 12.584 |
| o'qitilmagan | ultralytics | 1.912 | 6.513 | 4.159 | 12.584 |
Qo'lda hisob ultralytics bilan to'liq mos. O'qitilgan va o'qitilmagan model orasidagi katta farq sinf (6.5 → 1.5) va DFL (4.2 → 1.2) qismlarida. Box qismi esa deyarli bir xil: box loss faqat tanlangan kataklarda o'lchanadi, TAL esa tasodifiy model uchun ham o'sha paytda tasodifan eng yaxshi mos kelgan box larni tanlaydi. O'qitish — mana shu jami loss ni minglab rasmlar bo'yicha o'rtacha pasaytirish. 7-bobda buni o'zimiz qilamiz.
YOLO26: ikki bosh, ikki xil tayinlash
5-bobda YOLO26 ning ikki boshi borligini ko'rdik. Ularning farqi aynan tayinlashda. utils/loss.py dagi E2ELoss klassi:
one2manybosh —topk=10, YOLO11 dagi kabi. Har GT ga 10 tagacha katak: boy gradient, lekin ishlatishda takrorlar (NMS kerak).one2onebosh — avvaltopk=7nomzod, keyin ulardantopk2=1. Har GT ga aynan bitta katak. Bosh "bitta obyektga bitta javob" ni o'rganadi.
YOLO26 ning haqiqiy bashoratlari ustida tekshiramiz:
tarmoq26 = YOLO("weights/yolo26n.pt").model.eval()
tarmoq26.args = get_cfg(DEFAULT_CFG)
with torch.no_grad():
    _, ichki26 = tarmoq26(x)
qatorlar = []
for bosh, topk, topk2 in [("one2many", 10, None), ("one2one", 7, 1)]:
    kriteriy = v8DetectionLoss(tarmoq26, tal_topk=topk, tal_topk2=topk2)
    with torch.no_grad():
        (fg26, idx26, *_), _, _ = kriteriy.get_assigned_targets_and_loss(ichki26[bosh], batch)
    qatorlar.append({"bosh": bosh, "topk": topk, "topk2": topk2 or topk,
                     **{f"GT {k}": int((idx26[0][fg26[0]] == k).sum()) for k in range(len(gt_box))},
                     "DFL ishlatiladimi": kriteriy.use_dfl})
show(pd.DataFrame(qatorlar))
| bosh | topk | topk2 | GT 0 | GT 1 | GT 2 | GT 3 | GT 4 | GT 5 | DFL ishlatiladimi |
|---|---|---|---|---|---|---|---|---|---|
| one2many | 10 | 10 | 10 | 10 | 10 | 7 | 3 | 10 | False |
| one2one | 7 | 1 | 1 | 1 | 1 | 1 | 1 | 1 | False |
YOLO26 da reg_max = 1, DFL yo'q: loss ning uchinchi qismi DFL o'rniga masofalar farqining oddiy L1 qiymati bo'ladi (BboxLoss dagi else shoxi).
Ikkala bosh bir vaqtda o'qitiladi, lekin og'irliklari o'qitish davomida o'zgaradi. Har epoxa oxirida E2ELoss.update() chaqiriladi:
e2e = E2ELoss(tarmoq26)
print("epoxalar soni:", tarmoq26.args.epochs)
for epoxa in [0, 1, 25, 50, 75, 99]:
    o2m = e2e.decay(epoxa)
    print(f"{epoxa:3d} ta epoxadan keyin: one2many og'irligi {o2m:.3f}, one2one og'irligi {1 - o2m:.3f}")
epoxalar soni: 100
  0 ta epoxadan keyin: one2many og'irligi 0.800, one2one og'irligi 0.200
  1 ta epoxadan keyin: one2many og'irligi 0.793, one2one og'irligi 0.207
 25 ta epoxadan keyin: one2many og'irligi 0.623, one2one og'irligi 0.377
 50 ta epoxadan keyin: one2many og'irligi 0.446, one2one og'irligi 0.554
 75 ta epoxadan keyin: one2many og'irligi 0.270, one2one og'irligi 0.730
 99 ta epoxadan keyin: one2many og'irligi 0.100, one2one og'irligi 0.900
Boshida loss ning 80% i one2many dan keladi: model avval "obyekt qayerda" ni boy signal bilan tez o'rganadi. Oxiriga kelib 90% one2one ga o'tadi: endi "faqat bir marta javob ber" ni aniqlashtiradi. 2-bobda ko'rgan narxi — NMS siz rejimda 0.7–0.8 mAP yo'qotish — shu murosa natijasi.
Asosiy fikr
- O'qitish = tayinlash + loss. TAL har GT uchun markazi GT ichida bo'lgan kataklardan t = s^0.5 · u^6 bo'yicha eng yaxshi 10 tasini tanlaydi — box sifati sinf ishonchidan ancha muhimroq.
- Sinf maqsadi 1 emas, balki box sifatiga bog'liq kasr son. Shuning uchun YOLO ning ishonch qiymati "box qanchalik yaxshi" ni ham bildiradi.
- Loss = 7.5 · CIoU loss + 0.5 · BCE + 1.5 · DFL. YOLO26 da ikki bosh ikki xil tayinlanadi (10 ta va 1 ta katak), og'irlik o'qitish davomida birinchisidan ikkinchisiga o'tadi.
Mashqlar
tal()nibeta=1bilan ishga tushiring. Katta odamga tanlangan kataklar o'zgaradimi? Nega ultralytics β ni 6 qilib qo'ygan?holatlarjadvaliga o'zingiz bitta holat qo'shing: GT ichida turgan, lekin undan ancha kichik box. IoU va CIoU ni oldindan taxmin qiling, keyin tekshiring.- Ryukzak GT sini (18 × 20 px) 6 × 6 px ga kichraytiring va
tal()ni qayta ishga tushiring. Nomzodlar soni nechta bo'ladi? 16 px ga kengaytirish qoidasini olib tashlasangiz-chi?
Bu bobni bepul o'qidingiz.
Kitob o'rgatadi, lekin sizning kodingiz nega ishlamaganini ayta olmaydi. Kursda uy vazifangiz tekshiriladi.