CNN poydevori: YOLO11 ning birinchi qatlami ichidan
Bu bobning kodi: kod/03_cnn_poydevori.py — kitob papkasidan ishga tushiring: python kod/03_cnn_poydevori.py
Bu bob nimani takrorlamaydi
Konvolyutsiyaning o'zi, uni noldan yozish, im2col, padding, receptive field tushunchasi va LeNet/ResNet tarixi "Kompyuter Ko'rish" kitobining (CV_KITOBI) 2- va 4-boblarida batafsil bor. Bu yerda ularni qayta tushuntirmaymiz. Buning o'rniga YOLO11 ning haqiqiy qatlamlarini ochamiz va har bir formulani tayyor model ustida tekshiramiz:
- YOLO11 ning eng kichik g'ishti —
Convbloki: konvolyutsiya → BatchNorm → SiLU. - 640 pikselli rasm qanday qilib 20 × 20 lik to'rga aylanadi.
- BatchNorm nega ishga tushirishda "yo'qoladi" va bu qancha tezlik beradi.
- Har bir katak rasmning qancha qismini "ko'radi".
Nega to'liq bog'langan tarmoq emas
import cv2
import numpy as np
import torch
import matplotlib.pyplot as plt
from ultralytics import YOLO
from ultralytics.utils import ASSETS

model = YOLO("weights/yolo11n.pt")
tarmoq = model.model.eval()                   # ichidagi PyTorch tarmoq; predict chaqirilmagan, Conv va BN hali alohida
birinchi = tarmoq.model[0]                    # 0-qatlam
print(birinchi)

kirish = 640 * 640 * 3
print(f"\nKirish: 640 x 640 x 3 = {kirish:,} ta raqam")
print(f"To'liq bog'langan qatlam, 16 ta chiqish: {kirish * 16:,} ta vazn")
print(f"YOLO11 ning 0-qatlami (16 ta 3x3 filtr): {birinchi.conv.weight.numel():,} ta vazn")
Conv(
  (conv): Conv2d(3, 16, kernel_size=(3, 3), stride=(2, 2), padding=(1, 1), bias=False)
  (bn): BatchNorm2d(16, eps=0.001, momentum=0.03, affine=True, track_running_stats=True)
  (act): SiLU(inplace=True)
)

Kirish: 640 x 640 x 3 = 1,228,800 ta raqam
To'liq bog'langan qatlam, 16 ta chiqish: 19,660,800 ta vazn
YOLO11 ning 0-qatlami (16 ta 3x3 filtr): 432 ta vazn
Bir xil 16 ta chiqish uchun to'liq bog'langan qatlamga ~20 million vazn kerak, konvolyutsiyaga esa 432 ta. Farq ikki g'oyadan keladi: har bir filtr faqat kichik 3 × 3 oynaga qaraydi (lokal) va o'sha filtr rasmning hamma joyida qayta ishlatiladi (vaznlar umumiy). Chop etilgan tuzilishga qarang: Conv — bu uchta narsa ketma-ket: Conv2d (konvolyutsiya, bias=False), BatchNorm2d va SiLU. YOLO11 dagi deyarli hamma narsa shu g'ishtdan qurilgan.
Rasm tarmoqqa qanday kiradi
rasm = cv2.imread(str(ASSETS / "bus.jpg"))
rasm = cv2.resize(rasm, (640, 640))[:, :, ::-1].copy()            # soddalik uchun 640x640 ga cho'zamiz, BGR -> RGB
x = torch.from_numpy(rasm).permute(2, 0, 1)[None].float() / 255   # (H, W, C) -> (1, C, H, W), 0..1 oralig'i
print("tensor shakli:", tuple(x.shape), "| qiymatlar:", float(x.min()), "..", float(x.max()))
tensor shakli: (1, 3, 640, 640) | qiymatlar: 0.0 .. 1.0
PyTorch tartibi — (rasmlar soni, kanallar, balandlik, kenglik), qisqacha NCHW. OpenCV esa (balandlik, kenglik, kanallar) beradi, shuning uchun permute kerak. Piksellar 255 ga bo'linadi, chunki tarmoq 0..1 oralig'ida o'qitilgan. Haqiqiy predict rasmni cho'zmaydi: nisbatni saqlab kichraytiradi va bo'sh joyni kulrang bilan to'ldiradi (letterbox). Bu 8-bobda.
Konvolyutsiya: formula va tekshiruv
Chiqishdagi o-kanalning (i, j) nuqtasi — kirishdagi kichik oynaning filtrga ko'paytirilgan yig'indisi:
Bu yerda K — filtr o'lchami (3), S — qadam (stride, 2), P — chetga qo'shilgan nollar (padding, 1). YOLO11 ning 0-qatlami bilan tekshiramiz: formulani numpy da yozib, PyTorch natijasi bilan solishtiramiz.
from numpy.lib.stride_tricks import sliding_window_view

def conv2d_numpy(x, W, stride, pad):
    """x: (C, H, W) rasm, W: (O, C, K, K) filtrlar -> (O, H', W'). Formula bo'yicha, Python sikli yo'q."""
    x = np.pad(x, ((0, 0), (pad, pad), (pad, pad)))                         # chetlarni 0 bilan to'ldirish
    K = W.shape[-1]
    oynalar = sliding_window_view(x, (K, K), axis=(1, 2))[:, ::stride, ::stride]   # (C, H', W', K, K)
    return np.einsum("chwuv,ocuv->ohw", oynalar, W)                         # har oyna x har filtr: ko'paytirib yig'ish

W0 = birinchi.conv.weight.detach().numpy()                                  # (16, 3, 3, 3)
bizniki = conv2d_numpy(x[0].numpy(), W0, stride=2, pad=1)
with torch.no_grad():
    torchniki = birinchi.conv(x)[0].numpy()                                 # faqat konvolyutsiya: BN va SiLU siz
print("filtrlar shakli:", W0.shape, "-> (chiqish kanallari, kirish kanallari, K, K)")
print("chiqish shakli :", bizniki.shape, "| PyTorch:", torchniki.shape)
print("eng katta farq :", np.abs(bizniki - torchniki).max())
filtrlar shakli: (16, 3, 3, 3) -> (chiqish kanallari, kirish kanallari, K, K)
chiqish shakli : (16, 320, 320) | PyTorch: (16, 320, 320)
eng katta farq : 7.1525574e-07
Farq float32 yaxlitlash darajasida — formula aynan shu. sliding_window_view rasmni nusxalamasdan hamma 3 × 3 oynalarni "ko'rsatadi", einsum esa formuladagi uchta yig'indini bitta qatorda bajaradi.
640 dan 20 gacha: chiqish o'lchami
Qadam 2 bo'lsa, chiqish ikki barobar kichrayadi. Aniq formula:
640, K = 3, S = 2, P = 1 uchun: ⌊(640 + 2 − 3) / 2⌋ + 1 = ⌊319.5⌋ + 1 = 320. Endi YOLO11 ning butun tayanch qismini (backbone, 0–10-qatlamlar) o'tib chiqamiz. Har qatlamga "ilgak" (forward hook) qo'yamiz — u qatlam ishlaganda chiqish shaklini yozib oladi:
import pandas as pd

shakllar = {}
ilgaklar = [q.register_forward_hook(lambda m, i, o, k=k: shakllar.__setitem__(k, tuple(o.shape[1:])))
            for k, q in enumerate(tarmoq.model[:11])]
with torch.no_grad():
    tarmoq(x)
for h in ilgaklar:
    h.remove()                                                   # ilgaklarni olib tashlaymiz, aks holda qolib ketadi

def chiqish_olchami(I, K, S, P):
    return (I + 2 * P - K) // S + 1

qatorlar, H = [], 640
for k, q in enumerate(tarmoq.model[:11]):
    tur = type(q).__name__
    if tur == "Conv":
        K, S, P = q.conv.kernel_size[0], q.conv.stride[0], q.conv.padding[0]
        H = chiqish_olchami(H, K, S, P)
        izoh = f"K={K}, S={S}, P={P}"
    else:
        izoh = "o'lcham saqlanadi"
    qatorlar.append({"qatlam": k, "turi": tur, "izoh": izoh, "formula: H": H, "haqiqiy (C, H, W)": str(shakllar[k])})
show(pd.DataFrame(qatorlar), 11)
| qatlam | turi | izoh | formula: H | haqiqiy (C, H, W) |
|---|---|---|---|---|
| 0 | Conv | K=3, S=2, P=1 | 320 | (16, 320, 320) |
| 1 | Conv | K=3, S=2, P=1 | 160 | (32, 160, 160) |
| 2 | C3k2 | o'lcham saqlanadi | 160 | (64, 160, 160) |
| 3 | Conv | K=3, S=2, P=1 | 80 | (64, 80, 80) |
| 4 | C3k2 | o'lcham saqlanadi | 80 | (128, 80, 80) |
| 5 | Conv | K=3, S=2, P=1 | 40 | (128, 40, 40) |
| 6 | C3k2 | o'lcham saqlanadi | 40 | (128, 40, 40) |
| 7 | Conv | K=3, S=2, P=1 | 20 | (256, 20, 20) |
| 8 | C3k2 | o'lcham saqlanadi | 20 | (256, 20, 20) |
| 9 | SPPF | o'lcham saqlanadi | 20 | (256, 20, 20) |
| 10 | C2PSA | o'lcham saqlanadi | 20 | (256, 20, 20) |
Beshta Conv qatlam qadam 2 bilan: 2⁵ = 32, ya'ni 640 / 32 = 20. Oradagi bloklar (C3k2, SPPF, C2PSA) o'lchamni o'zgartirmaydi, faqat kanallar sonini o'zgartiradi va xususiyatlarni boyitadi. Ular 4-bobda. Keyingi qism (neck) backbone dan uchta chiqishni oladi: 4-qatlam (80 × 80), 6-qatlam (40 × 40) va 10-qatlam (20 × 20). 2-bobdagi 6 400 + 1 600 + 400 = 8 400 katak aynan shu uch o'lchamdagi to'rlardan keladi.
16 ta filtr va 16 ta xarita
0-qatlamning filtrlarini rasm sifatida ko'raylik. Har biri 3 × 3 × 3: uchta rang kanali uchun uchta 3 × 3 jadval.
Wn = (W0 - W0.min()) / (W0.max() - W0.min())             # 0..1 ga keltiramiz, rasm sifatida ko'rish uchun
_, axes = plt.subplots(2, 8, figsize=(9, 2.6))
for i, ax in enumerate(axes.flat):
    ax.imshow(Wn[i].transpose(1, 2, 0), interpolation="nearest")   # (3, 3, 3) -> 3x3 rangli rasm
    ax.set_title(str(i), fontsize=9)
    ax.axis("off")
fig("filtrlar.png", "0-qatlamning 16 ta filtri (3x3, RGB). Hech kim ularni qo'lda yozmagan: o'qitish davomida o'zi o'rgangan.")
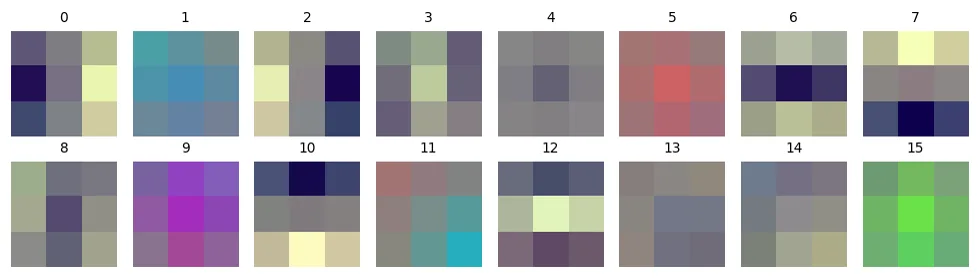
0-qatlamning 16 ta filtri (3x3, RGB). Hech kim ularni qo'lda yozmagan: o'qitish davomida o'zi o'rgangan.
Ikki xil filtr ko'rinadi. Ba'zilarida bir tomoni qorong'i, qarama-qarshi tomoni yorug' (masalan 0, 6, 7, 10) — bular chegara, ya'ni yorug'lik keskin o'zgaradigan joyni topadi. Boshqalari deyarli bir tekis rangli (5 qizil, 9 binafsha, 15 yashil) — bular rang topadi. Endi shu filtrlar bus.jpg ga qanday javob berishini ko'ramiz (konvolyutsiya → BN → SiLU, to'liq 0-qatlam):
with torch.no_grad():
    xarita = birinchi(x)[0]                                   # (16, 320, 320)
_, axes = plt.subplots(4, 4, figsize=(9, 9))
for i, ax in enumerate(axes.flat):
    ax.imshow(xarita[i].numpy(), cmap="gray")
    ax.set_title(str(i), fontsize=9)
    ax.axis("off")
fig("xaritalar.png", "Shu 16 filtrning bus.jpg dagi javobi (har biri 320x320). Oq — kuchli javob.")
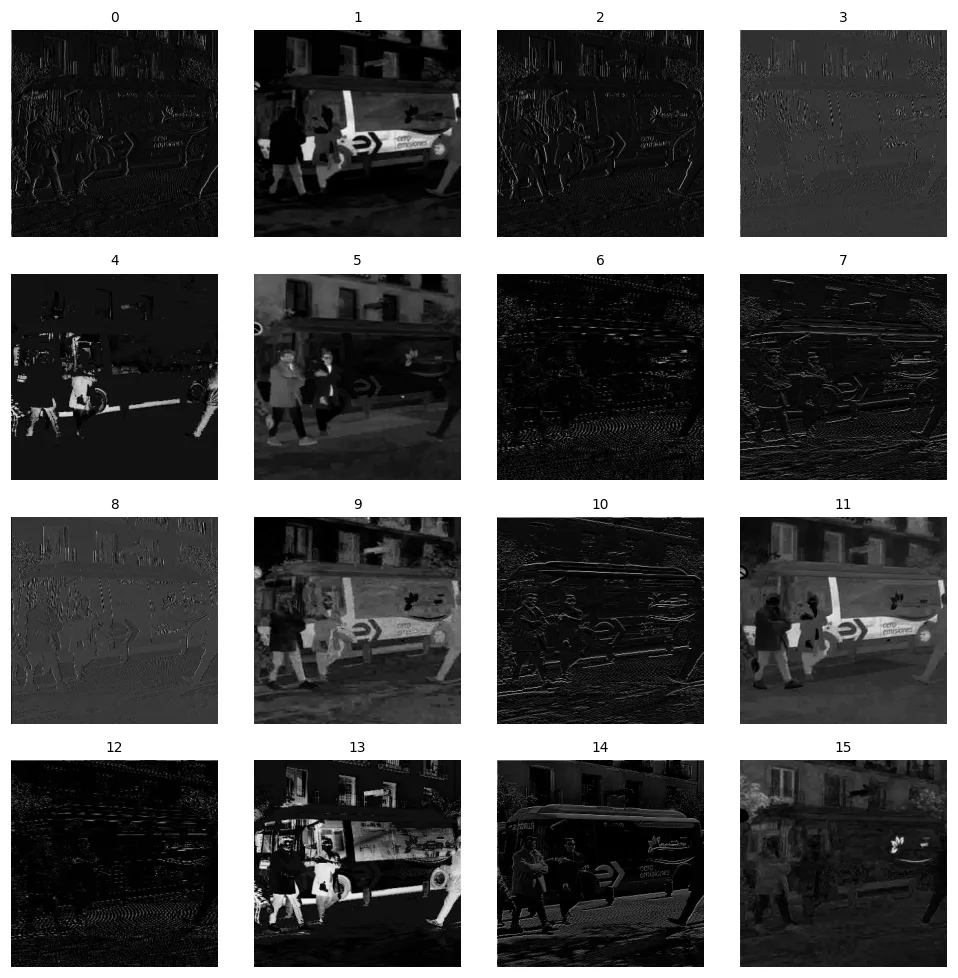
Shu 16 filtrning bus.jpg dagi javobi (har biri 320x320). Oq — kuchli javob.
Chegara filtrlari xaritalarida (0, 2, 7, 10) avtobus va odamlarning konturlari chiqqan. 1, 4 va 13-xaritalar esa oq sohalarga — avtobusdagi oq chiziqqa — kuchli javob beradi. Birinchi qatlam hali "odam" yoki "avtobus" ni bilmaydi: u faqat chegaralar va ranglarni ajratadi. Keyingi qatlamlar shu oddiy belgilarni birlashtirib, murakkabroq shakllarni taniydi.
BatchNorm: o'qitishda kerak, ishlatishda yo'qoladi
BatchNorm har bir kanalni "me'yorlaydi": o'rtachasini ayirib, standart og'ishiga bo'ladi, keyin o'rgatilgan masshtab (γ) va siljish (β) qo'shadi:
O'qitishda μ va σ² har bir batch dan hisoblanadi — bu o'qitishni barqaror va tez qiladi (sababi CV_KITOBI 4-bobida). O'qitish tugagach esa μ va σ² o'rtacha qiymatlari (running_mean, running_var) qotib qoladi. 0-qatlamdagi birinchi to'rtta kanal:
bn = birinchi.bn
print("mu      (running_mean):", bn.running_mean[:4].numpy().round(3))
print("sigma^2 (running_var) :", bn.running_var[:4].numpy().round(3))
print("gamma   (weight)      :", bn.weight[:4].detach().numpy().round(3))
print("beta    (bias)        :", bn.bias[:4].detach().numpy().round(3))
print("eps                   :", bn.eps)
mu      (running_mean): [     -0.006      -0.049      -0.008      -0.011]
sigma^2 (running_var) : [      0.016       0.031       0.018       0.001]
gamma   (weight)      : [      2.727       3.971       2.893       1.974]
beta    (bias)        : [      1.752       0.518       1.636       6.777]
eps                   : 0.001
Hamma qiymat qotgan bo'lsa, BN — oddiy chiziqli amal: har kanalni biror songa ko'paytirib, biror son qo'shish. Konvolyutsiya ham chiziqli. Ikki chiziqli amalni bitta amalga birlashtirish mumkin — filtrlarni oldindan qayta hisoblab:
YOLO11 da konvolyutsiyaning o'z bias i yo'q (b = 0), chunki BN baribir siljish qo'shadi. Qo'lda birlashtirib tekshiramiz:
with torch.no_grad():
    koef = bn.weight / torch.sqrt(bn.running_var + bn.eps)          # har kanalga bitta son
    W_birl = birinchi.conv.weight * koef[:, None, None, None]        # (16, 3, 3, 3): har filtr o'z koeffitsiyentiga
    b_birl = bn.bias - bn.running_mean * koef                        # b = 0
    ikki_qadam = bn(birinchi.conv(x))                                # konvolyutsiya, keyin BN
    bir_qadam = torch.nn.functional.conv2d(x, W_birl, b_birl, stride=2, padding=1)
print("eng katta farq:", float((ikki_qadam - bir_qadam).abs().max()))
eng katta farq: 2.002716064453125e-05
Natija bir xil, lekin bitta amal kam. Ultralytics buni butun tarmoq uchun fuse() bilan qiladi. Qancha tezlik beradi — GPU da o'lchaymiz:
import copy
import time

def olchov(net, n=200):
    """batch=1, 640x640: n marta ishga tushirishning o'rtacha vaqti, ms."""
    xg = torch.zeros(1, 3, 640, 640, device="cuda")
    with torch.no_grad():
        for _ in range(20):
            net(xg)                                              # qizdirish
        torch.cuda.synchronize()
        t0 = time.perf_counter()
        for _ in range(n):
            net(xg)
        torch.cuda.synchronize()                                 # GPU ishini tugatishini kutamiz, aks holda vaqt noto'g'ri
    return (time.perf_counter() - t0) / n * 1000

alohida = copy.deepcopy(tarmoq).cuda()
birlashgan = copy.deepcopy(tarmoq).fuse(verbose=False).cuda()   # hamma Conv+BN juftliklari birlashadi
for nom, net in [("BN alohida", alohida), ("BN birlashgan", birlashgan)]:
    bn_soni = sum(isinstance(q, torch.nn.BatchNorm2d) for q in net.modules())
    print(f"{nom:14s}: {olchov(net):.2f} ms, BatchNorm qatlamlari: {bn_soni}")

tekshir = YOLO("weights/yolo11n.pt")
tekshir.predict(ASSETS / "bus.jpg", verbose=False)
print("\npredict() dan keyin 0-qatlamda BN qoldimi:", hasattr(tekshir.model.model[0], "bn"))
BN alohida    : 5.45 ms, BatchNorm qatlamlari: 81
BN birlashgan : 4.15 ms, BatchNorm qatlamlari: 0

predict() dan keyin 0-qatlamda BN qoldimi: False
81 ta BatchNorm qatlami yo'qoldi va GPU vaqti taxminan to'rtdan bir qismga qisqardi — aniqlik o'zgarmagan holda. predict() birlashtirishni o'zi, jimgina qiladi. Buni bilish 8-bobda (ONNX, TensorRT eksport) kerak bo'ladi: eksport qilingan modelda BN umuman bo'lmaydi.
SiLU: nega ReLU emas
Conv blokining oxirida aktivatsiya turadi. YOLO11 da — SiLU:
t = np.linspace(-6, 4, 2001)
silu = t / (1 + np.exp(-t))
_, ax = plt.subplots(figsize=(6.5, 3.4))
ax.plot(t, np.maximum(t, 0), label="ReLU = max(0, x)", lw=2, ls="--")
ax.plot(t, silu, label="SiLU = x / (1 + e^-x)", lw=2.5)
ax.axhline(0, color="gray", lw=0.8)
ax.axvline(0, color="gray", lw=0.8)
ax.legend()
ax.set_ylim(-1, 4)
fig("silu.png", "SiLU manfiy tomonda nolga emas, kichik manfiy qiymatga tushadi va silliq.")
i = silu.argmin()
print(f"SiLU minimumi: x = {t[i]:.3f} da {silu[i]:.4f}")
SiLU minimumi: x = -1.280 da -0.2785
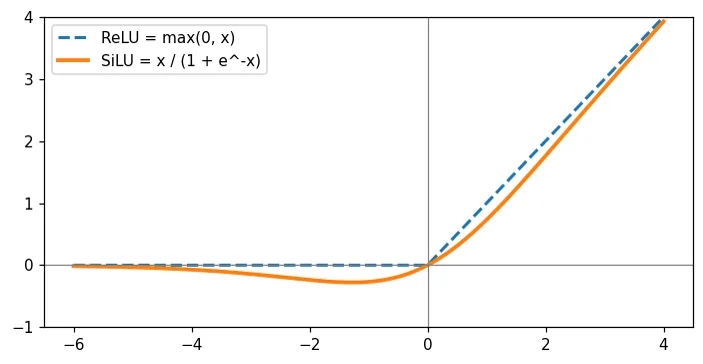
SiLU manfiy tomonda nolga emas, kichik manfiy qiymatga tushadi va silliq.
ReLU manfiy hamma narsani nolga aylantiradi: nolda turgan neyron gradient olmaydi va o'qitishda "o'lik" bo'lib qolishi mumkin. SiLU esa kichik manfiy qiymatlarni o'tkazadi va hamma joyda silliq. Real rasmda buning ahamiyati qancha?
print(f"0-qatlam chiqishida manfiy qiymatlar: {float((xarita < 0).float().mean()) * 100:.1f}%")
print(f"eng kichik qiymat: {float(xarita.min()):.4f}")
conv_bloklar = [(nom, type(q.act).__name__) for nom, q in tarmoq.named_modules() if type(q).__name__ == "Conv"]
print(f"\nYOLO11 dagi Conv bloklari: {len(conv_bloklar)}, shundan SiLU: {sum(a == 'SiLU' for _, a in conv_bloklar)}")
print("aktivatsiyasizlari (Identity):", [n for n, a in conv_bloklar if a == "Identity"])
0-qatlam chiqishida manfiy qiymatlar: 27.1%
eng kichik qiymat: -0.2785

YOLO11 dagi Conv bloklari: 75, shundan SiLU: 71
aktivatsiyasizlari (Identity): ['model.10.m.0.attn.qkv', 'model.10.m.0.attn.proj', 'model.10.m.0.attn.pe', 'model.10.m.0.ffn.1']
ReLU bo'lganda, bu qiymatlarning hammasi nol bo'lardi. Eng kichik qiymat SiLU ning nazariy minimumiga aynan teng — ya'ni 0-qatlamning ba'zi joylari aynan shu "chuqurcha" da turibdi.
Deyarli hamma Conv bloklari SiLU bilan tugaydi. Aktivatsiyasiz qolgan to'rttasi bitta joyda — 10-qatlam (C2PSA) ning attention qismida (model.10...attn, ffn). Attention da query, key va value chiziqli proyeksiyalar bo'lishi kerak: ularni SiLU dan o'tkazsak, "qaysi joy qaysi joyga qancha e'tibor beradi" hisobi buziladi. Bu blokni 4-bobda ochamiz.
Har bir katak qancha ko'radi
Receptive field — chiqishdagi bitta katak kirishdagi qaysi piksellarga bog'liq (tushunchaning o'zi CV_KITOBI 2-bobida). Qatlamdan qatlamga u shunday o'sadi:
j — "sakrash": kirishda qo'shni ikki katak orasi necha piksel. Qo'lda: 0-qatlam r = 1 + 2 · 1 = 3, j = 2; 1-qatlam r = 3 + 2 · 2 = 7. Keyingi bloklar ichida o'nlab konvolyutsiya bor, qo'lda sanash qiyin. Shuning uchun o'lchaymiz: markaziy katakning qiymatini kirish bo'yicha differensiallaymiz. Gradient noldan farqli bo'lgan piksellar — aynan shu katak "ko'radigan" joy.
def korish_maydoni(qatlam):
    """qatlam chiqishining markaziy katagi uchun kirishdagi gradient xaritasi, (640, 640)."""
    xx = x.clone().requires_grad_(True)
    saqla = {}
    h = tarmoq.model[qatlam].register_forward_hook(lambda m, i, o: saqla.__setitem__("o", o))
    tarmoq(xx)
    h.remove()
    o = saqla["o"]
    o[0, :, o.shape[2] // 2, o.shape[3] // 2].sum().backward()   # markaziy katakning hamma kanallari
    return xx.grad[0].abs().sum(0)                               # har piksel ta'siri, rang kanallari yig'ilgan

def yarim_massa_tomoni(g):
    """Gradientning 50% i to'plangan eng kichik maydon, kvadrat tomoniga aylantirilgan (px)."""
    q = np.sort(g.flatten().numpy())[::-1]
    return float(np.sqrt(np.searchsorted(np.cumsum(q), q.sum() / 2) + 1))

nomlar = {0: "", 1: "", 2: "", 3: "", 4: "P3 (qadam 8)", 6: "P4 (qadam 16)", 8: "P5 (qadam 32)", 9: "SPPF", 10: "C2PSA"}
qatorlar, xaritalar = [], {}
for k, nom in nomlar.items():
    g = korish_maydoni(k)
    ys, xs = torch.nonzero(g > 0, as_tuple=True)
    qatorlar.append({"qatlam": k, "": nom, "to'r": f"{shakllar[k][1]}x{shakllar[k][2]}",
                     "ko'rish maydoni, px": int(xs.max() - xs.min() + 1),
                     "ta'sirning 50% i, px": round(yarim_massa_tomoni(g))})
    xaritalar[k] = g
show(pd.DataFrame(qatorlar), 12)
| qatlam | to'r | ko'rish maydoni, px | ta'sirning 50% i, px | |
|---|---|---|---|---|
| 0 | 320x320 | 3 | 2 | |
| 1 | 160x160 | 7 | 4 | |
| 2 | 160x160 | 23 | 6 | |
| 3 | 80x80 | 31 | 8 | |
| 4 | P3 (qadam 8) | 80x80 | 63 | 16 |
| 6 | P4 (qadam 16) | 40x40 | 207 | 36 |
| 8 | P5 (qadam 32) | 20x20 | 495 | 78 |
| 9 | SPPF | 20x20 | 640 | 120 |
| 10 | C2PSA | 20x20 | 640 | 154 |
Ikki ustunni solishtiring. "Ko'rish maydoni" — katak nazariy jihatdan ko'radigan hamma narsa. "Ta'sirning 50% i" — ta'sirning yarmi to'plangan kvadrat tomoni: katak aslida asosan markazga qaraydi, chetlar deyarli ta'sir qilmaydi. Masalan, P5 katagi nazariy jihatdan 495 pikselni ko'radi, lekin ta'sirning yarmi markazdagi ~78 pikselli kvadratdan keladi. Buni rasmda ko'ramiz:
_, axes = plt.subplots(1, 3, figsize=(10, 3.6))
for ax, k in zip(axes, [4, 6, 8]):
    ax.imshow(rasm, alpha=0.5)
    ax.imshow(np.log1p(xaritalar[k].numpy() / float(xaritalar[k].max()) * 1000), cmap="inferno", alpha=0.6)
    ax.set_title(f"{k}-qatlam: {nomlar[k]}", fontsize=10)
    ax.axis("off")
fig("korish_maydoni.png", "Markaziy katak kirishning qaysi joyiga bog'liq (logarifmik shkala). Kichik to'r — kattaroq maydon.")
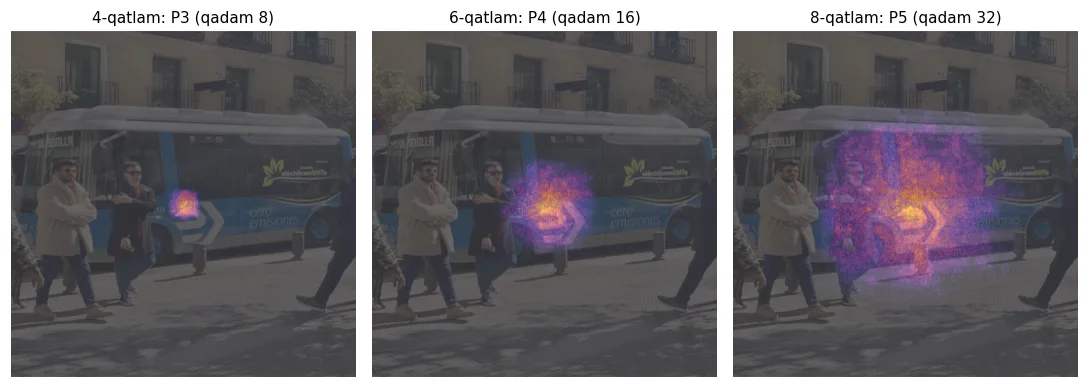
Markaziy katak kirishning qaysi joyiga bog'liq (logarifmik shkala). Kichik to'r — kattaroq maydon.
Bu raqamlar 1-bobdagi "kichik obyekt" muammosi bilan to'g'ridan-to'g'ri bog'liq:
- P3 (80 × 80 to'r) kataklari kichik maydonni ko'radi va 8 piksel qadam bilan joylashgan. Uzoqdagi 30 pikselli odam aynan shu yerda topiladi.
- P5 (20 × 20 to'r) katagi ancha katta maydonni ko'radi — avtobus kabi katta obyektlar uchun.
- SPPF dan keyin bitta katak butun rasmni ko'radi. SPPF ketma-ket uchta max-pooling qiladi va bu maydonni birdan kengaytiradi. 4-bobda SPPF va C2PSA ichini ochamiz, u yerda bu global ma'lumot P3 va P4 ga ham qanday "tushirilishini" ko'ramiz.
Asosiy fikr
- YOLO11 ning g'ishti —
Conv= konvolyutsiya → BatchNorm → SiLU. Beshta qadam-2 liConvrasmni 640 dan 20 gacha kichraytiradi: O = ⌊(I + 2P − K) / S⌋ + 1. - BatchNorm ishga tushirishda konvolyutsiya ichiga "eritiladi" (fuse): natija bir xil, amal kam.
predict()buni o'zi qiladi. - Har bir to'r o'z o'lchamdagi obyekt uchun: P3 kataklari kichik maydonni, P5 kataklari katta maydonni ko'radi, SPPF dan keyin esa butun rasmni.
Mashqlar
conv2d_numpyni 1-qatlam (tarmoq.model[1]) uchun ishlating. Kirish sifatida 0-qatlam chiqishini (xarita) bering. Kanal soni va o'lcham formulaga mosmi?- Receptive field formulasini 0–1-qatlamlar uchun qo'lda davom ettirib, 3-qatlam uchun hisoblang (2-qatlam C3k2 ichida bir nechta 3 × 3 konvolyutsiya bor, shuning uchun faqat 3-qatlamning o'z hissasini qo'shing). O'lchangan 31 bilan farqni tushuntiring.
olchov()ni CPU uchun yozing (torch.cuda.synchronizekerak emas). BN birlashtirish CPU da ko'proq yutuq beradimi yoki kamroq?
Bu bobni bepul o'qidingiz.
Kitob o'rgatadi, lekin sizning kodingiz nega ishlamaganini ayta olmaydi. Kursda uy vazifangiz tekshiriladi.