Arxitektura: yolo11.yaml qatorma-qator
Bu bobning kodi: kod/04_arxitektura.py — kitob papkasidan ishga tushiring: python kod/04_arxitektura.py
Model — bu bitta yaml fayl
YOLO11 ning butun tuzilishi Python kodida emas, 50 qatorli matn faylida yozilgan. Ultralytics shu faylni o'qib, tarmoqni qurib beradi. Fayl ultralytics paketining ichida turibdi:
import inspect
import math
import re
from pathlib import Path

import numpy as np
import pandas as pd
import torch
import yaml
import ultralytics
from ultralytics import YOLO
from ultralytics.utils import ASSETS, LOGGER
from ultralytics.utils.torch_utils import get_flops, get_num_params

LOGGER.setLevel("ERROR")                      # model qurilganda chiqadigan jadval va log larni o'chiramiz

papka = Path(ultralytics.__file__).parent / "cfg" / "models"
yaml_yol = papka / "11" / "yolo11.yaml"
matn = yaml_yol.read_text()
print(yaml_yol.relative_to(Path(ultralytics.__file__).parent.parent), "\n")
print(matn[matn.index("scales:"):matn.index("# YOLO11n head")].rstrip())
ultralytics/cfg/models/11/yolo11.yaml

scales: # model compound scaling constants, i.e. 'model=yolo11n.yaml' will call yolo11.yaml with scale 'n'
  # [depth, width, max_channels]
  n: [0.50, 0.25, 1024] # summary: 181 layers, 2624080 parameters, 2624064 gradients, 6.6 GFLOPs
  s: [0.50, 0.50, 1024] # summary: 181 layers, 9458752 parameters, 9458736 gradients, 21.7 GFLOPs
  m: [0.50, 1.00, 512] # summary: 231 layers, 20114688 parameters, 20114672 gradients, 68.5 GFLOPs
  l: [1.00, 1.00, 512] # summary: 357 layers, 25372160 parameters, 25372144 gradients, 87.6 GFLOPs
  x: [1.00, 1.50, 512] # summary: 357 layers, 56966176 parameters, 56966160 gradients, 196.0 GFLOPs

# YOLO11n backbone
backbone:
  # [from, repeats, module, args]
  - [-1, 1, Conv, [64, 3, 2]] # 0-P1/2
  - [-1, 1, Conv, [128, 3, 2]] # 1-P2/4
  - [-1, 2, C3k2, [256, False, 0.25]]
  - [-1, 1, Conv, [256, 3, 2]] # 3-P3/8
  - [-1, 2, C3k2, [512, False, 0.25]]
  - [-1, 1, Conv, [512, 3, 2]] # 5-P4/16
  - [-1, 2, C3k2, [512, True]]
  - [-1, 1, Conv, [1024, 3, 2]] # 7-P5/32
  - [-1, 2, C3k2, [1024, True]]
  - [-1, 1, SPPF, [1024, 5]] # 9
  - [-1, 2, C2PSA, [1024]] # 10
Har bir qatlam qatori to'rtta narsa: [from, repeats, module, args].
| Ustun | Ma'nosi | Misol |
|---|---|---|
from |
kirish qaysi qatlamdan keladi; −1 = oldingi qatlam | [-1, 6] — oldingi va 6-qatlam |
repeats |
blok ichida necha marta takrorlanadi | 2 |
module |
blok turi (ultralytics/nn/modules/ dagi klass) |
C3k2 |
args |
blok parametrlari; birinchisi — chiqish kanallari | [256, False, 0.25] |
Izohlardagi P1/2 ... P5/32 — qatlam chiqishi asl rasmdan necha barobar kichik: P3/8 — 8 barobar (640 → 80). 3-bobda shu o'lchamlarni formulaga solib tekshirgan edik.
Bitta fayl, besh model: depth va width
Faylda kanallar "katta model" uchun yozilgan: birinchi Conv da 64 kanal. Lekin 3-bobda yolo11n ning birinchi qatlamida 16 kanal ko'rdik. Farq scales qatoridan keladi: n: [0.50, 0.25, 1024] — depth (chuqurlik) koeffitsiyenti 0.5, width (kenglik) 0.25, kanal chegarasi 1024. Ultralytics ning nn/tasks.py faylidagi parse_model funksiyasi ularni shunday qo'llaydi:
Kanallar 8 ga karrali qilib yaxlitlanadi — GPU hisobi shunday tezroq. 64 · 0.25 = 16. Formulani har qatlam uchun hisoblab, haqiqiy model bilan solishtiramiz:
def kanal(c, w, cmax):
    """parse_model dagi qoida: chegaralash, kenglikka ko'paytirish, 8 ga karrali qilib yuqoriga yaxlitlash."""
    return math.ceil(min(c, cmax) * w / 8) * 8

model = YOLO("weights/yolo11n.pt")
tarmoq = model.model.eval()
shakllar = {}
ilgaklar = [q.register_forward_hook(lambda m, i, o, k=k: shakllar.__setitem__(k, tuple(o.shape[1:])))
            for k, q in enumerate(tarmoq.model[:23])]
with torch.no_grad():
    tarmoq(torch.zeros(1, 3, 640, 640))
for h in ilgaklar:
    h.remove()

cfg = yaml.safe_load(matn)
d, w, cmax = cfg["scales"]["n"]
qatorlar = []
for i, (f, n, mod, args) in enumerate(cfg["backbone"] + cfg["head"]):
    if mod in ("Conv", "C3k2", "SPPF", "C2PSA"):
        qatorlar.append({"qatlam": i, "modul": mod, "yaml: kanal": args[0], "yaml: takror": n,
                         "formula: kanal": kanal(args[0], w, cmax), "formula: takror": max(round(n * d), 1),
                         "haqiqiy kanal": shakllar[i][0],
                         "haqiqiy takror": len(tarmoq.model[i].m) if mod in ("C3k2", "C2PSA") else n})
show(pd.DataFrame(qatorlar), 20)
| qatlam | modul | yaml: kanal | yaml: takror | formula: kanal | formula: takror | haqiqiy kanal | haqiqiy takror |
|---|---|---|---|---|---|---|---|
| 0 | Conv | 64 | 1 | 16 | 1 | 16 | 1 |
| 1 | Conv | 128 | 1 | 32 | 1 | 32 | 1 |
| 2 | C3k2 | 256 | 2 | 64 | 1 | 64 | 1 |
| 3 | Conv | 256 | 1 | 64 | 1 | 64 | 1 |
| 4 | C3k2 | 512 | 2 | 128 | 1 | 128 | 1 |
| 5 | Conv | 512 | 1 | 128 | 1 | 128 | 1 |
| 6 | C3k2 | 512 | 2 | 128 | 1 | 128 | 1 |
| 7 | Conv | 1 024 | 1 | 256 | 1 | 256 | 1 |
| 8 | C3k2 | 1 024 | 2 | 256 | 1 | 256 | 1 |
| 9 | SPPF | 1 024 | 1 | 256 | 1 | 256 | 1 |
| 10 | C2PSA | 1 024 | 2 | 256 | 1 | 256 | 1 |
| 13 | C3k2 | 512 | 2 | 128 | 1 | 128 | 1 |
| 16 | C3k2 | 256 | 2 | 64 | 1 | 64 | 1 |
| 17 | Conv | 256 | 1 | 64 | 1 | 64 | 1 |
| 19 | C3k2 | 512 | 2 | 128 | 1 | 128 | 1 |
| 20 | Conv | 512 | 1 | 128 | 1 | 128 | 1 |
| 22 | C3k2 | 1 024 | 2 | 256 | 1 | 256 | 1 |
Formula har qatorda haqiqiy model bilan bir xil. Endi beshala o'lchamni og'irliksiz, faqat yaml dan quramiz:
qatorlar = []
for s in "nsmlx":
    m = YOLO(f"yolo11{s}.yaml").model             # og'irliksiz: tasodifiy vaznlar, faqat tuzilish
    qatorlar.append({"model": f"yolo11{s}", "[depth, width, max_kanal]": str(cfg["scales"][s]),
                     "parametr, mln": get_num_params(m) / 1e6, "GFLOPs": get_flops(m, 640),
                     "2-qatlam ichida": type(m.model[2].m[0]).__name__})
show(pd.DataFrame(qatorlar))
| model | [depth, width, max_kanal] | parametr, mln | GFLOPs | 2-qatlam ichida |
|---|---|---|---|---|
| yolo11n | [0.5, 0.25, 1024] | 2.624 | 6.614 | Bottleneck |
| yolo11s | [0.5, 0.5, 1024] | 9.459 | 21.718 | Bottleneck |
| yolo11m | [0.5, 1.0, 512] | 20.115 | 68.528 | C3k |
| yolo11l | [1.0, 1.0, 512] | 25.372 | 87.613 | C3k |
| yolo11x | [1.0, 1.5, 512] | 56.966 | 195.959 | C3k |
Parametrlar va GFLOPs yaml izohlaridagi raqamlarga aynan mos keladi. Oxirgi ustunga qarang: n va s da 2-qatlam ichida oddiy Bottleneck, m, l, x da esa og'irroq C3k. Buni ham parse_model qiladi: if scale in "mlx": c3k = True. Ya'ni katta modellar faqat kengroq va chuqurroq emas, ba'zi bloklari ham boshqacha.
C3k2: ikki yo'l va qisqa tutashuv
C3k2 — YOLO11 ning asosiy "ishchi" bloki, 23 ta qatlamdan 8 tasi shu. U YOLOv8 dagi C2f dan meros oladi va forward funksiyasini o'zgarishsiz ishlatadi. Kodning o'zi (ultralytics/nn/modules/block.py):
from ultralytics.nn.modules.block import Bottleneck, C2f, C3k2

def manba(f):
    """Funksiya kodini docstring siz ko'rsatadi."""
    return re.sub(r'\n\s*"""[\s\S]*?"""', "", inspect.getsource(f))

print("C3k2 ning ota klassi:", C3k2.__mro__[1].__name__, "\n")
print(manba(C2f.forward))
print(manba(Bottleneck.forward))
C3k2 ning ota klassi: C2f

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        y = list(self.cv1(x).chunk(2, 1))
        y.extend(m(y[-1]) for m in self.m)
        return self.cv2(torch.cat(y, 1))

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        return x + self.cv2(self.cv1(x)) if self.add else self.cv2(self.cv1(x))
Qatorma-qator:
cv1(x).chunk(2, 1)— 1 × 1 konvolyutsiya kanallarni ikki qismga bo'ladi.- Birinchi qism hech narsaga tegmasdan o'tadi. Ikkinchisi
Bottlenecklardan o'tadi, va har birining natijasi ro'yxatga qo'shiladi. cv2(torch.cat(y, 1))— hamma qismlar kanal bo'yicha yopishtiriladi va 1 × 1 konvolyutsiya bilan aralashtiriladi.
Bottleneck ning o'zi — ikki 3 × 3 konvolyutsiya va qisqa tutashuv (residual, shortcut):
Blok natijani noldan emas, kirishga "tuzatish" sifatida hisoblaydi. O'qitishda gradient x + yo'li orqali to'g'ridan-to'g'ri oldingi qatlamlarga o'tadi — chuqur tarmoq shu sababli o'qitiladi (ResNet g'oyasi, CV_KITOBI 4-bob). Bo'linish esa hisobni tejaydi: kanallarning yarmi og'ir qismga umuman kirmaydi.
SPPF: uchta max-pool — uch xil o'lcham
9-qatlam. Kodi:
from ultralytics.nn.modules.block import SPPF

print(manba(SPPF.forward))
sppf = tarmoq.model[9]
print("max-pool:", sppf.m, "| necha marta:", getattr(sppf, "n", 3))   # eski .pt faylda n maydoni yo'q
print("yolo11n.pt dagi SPPF da 'n' maydoni bormi:", hasattr(sppf, "n"))
    def forward(self, x: torch.Tensor) -> torch.Tensor:
        y = [self.cv1(x)]
        y.extend(self.m(y[-1]) for _ in range(getattr(self, "n", 3)))
        y = self.cv2(torch.cat(y, 1))
        return y + x if getattr(self, "add", False) else y

max-pool: MaxPool2d(kernel_size=5, stride=1, padding=2, dilation=1, ceil_mode=False) | necha marta: 3
yolo11n.pt dagi SPPF da 'n' maydoni bormi: False
Kodda getattr(self, "n", 3) bejiz emas: yolo11n.pt fayli n parametri qo'shilishidan oldingi versiyada saqlangan va undagi SPPF obyektida bu maydon yo'q. Kutubxona eski fayllar ham ishlashi uchun standart qiymatni (3) oladi. Real loyihalarda ham shunday: model fayli kutubxona versiyasidan eski bo'lishi mumkin.
Bir xil 5 × 5 max-pool ketma-ket uch marta qo'llanadi va to'rtala natija (asl + 3 ta) yopishtiriladi. Nega? YOLOv4 davridagi asl SPP bloki bitta kirishga 5 × 5, 9 × 9 va 13 × 13 lik uchta alohida max-pool qo'llardi — uch xil o'lchamdagi "atrofga qarash". 5 × 5 ni ikki marta qo'llash 9 × 9 bilan, uch marta qo'llash 13 × 13 bilan aynan bir xil natija beradi. Tekshiramiz:
x = torch.randn(1, 128, 20, 20)
katta = lambda k: torch.nn.functional.max_pool2d(x, k, stride=1, padding=k // 2)   # asl SPP: bitta katta oyna
y1 = sppf.m(x)
y2 = sppf.m(y1)
y3 = sppf.m(y2)
print("5x5 bir marta  vs 5x5  :", float((y1 - katta(5)).abs().max()))
print("5x5 ikki marta vs 9x9  :", float((y2 - katta(9)).abs().max()))
print("5x5 uch marta  vs 13x13:", float((y3 - katta(13)).abs().max()))
5x5 bir marta  vs 5x5  : 0.0
5x5 ikki marta vs 9x9  : 0.0
5x5 uch marta  vs 13x13: 0.0
Farq aynan nol. Lekin hisob kamroq: har nuqtada 5 × 5 oyna 25 ta taqqoslash, uch marta — 75 ta. Alohida 5, 9, 13 lik oynalar esa 25 + 81 + 169 = 275 ta taqqoslash. "F" (fast) — shundan. 3-bobda SPPF dan keyin katakning ko'rish maydoni birdan butun rasmga yetganini ko'rgan edik: 13 × 13 oyna 20 × 20 lik to'rda, har katak 32 piksel bo'lsa, 400 dan ortiq pikselni qamraydi.
C2PSA: attention
10-qatlam — YOLO11 ga yangi qo'shilgan blok. Ichida transformerlardagi attention bor: har bir katak qolgan hamma kataklarga "qaraydi" va qaysi biri o'zi uchun muhimligini hal qiladi:
N = 20 · 20 = 400 ta katak. Har katak uchun uchta vektor hisoblanadi: Q (query — "men nima qidiryapman"), K (key — "menda nima bor") va V (value — "men beradigan ma'lumot"). QKᵀ — 400 × 400 lik jadval: har juftlik qanchalik mos. softmax har qatorni 1 ga yig'iladigan og'irliklarga aylantiradi. √d_k ga bo'lish qiymatlarni juda katta bo'lib ketishdan saqlaydi. Ultralytics dagi kod:
from ultralytics.nn.modules.block import Attention

print(manba(Attention.forward))
att = tarmoq.model[10].m[0].attn
print(f"boshlar (heads): {att.num_heads}, d_k (key_dim): {att.key_dim}, d_v (head_dim): {att.head_dim}, "
      f"1/sqrt(d_k) = {att.scale:.4f}")
    def forward(self, x: torch.Tensor) -> torch.Tensor:
        B, C, H, W = x.shape
        N = H * W
        qkv = self.qkv(x)
        q, k, v = qkv.view(B, self.num_heads, self.key_dim * 2 + self.head_dim, N).split(
            [self.key_dim, self.key_dim, self.head_dim], dim=2
        )

        attn = (q.transpose(-2, -1) @ k) * self.scale
        attn = attn.softmax(dim=-1)
        x = (v @ attn.transpose(-2, -1)).view(B, C, H, W) + self.pe(v.reshape(B, C, H, W))
        x = self.proj(x)
        return x

boshlar (heads): 2, d_k (key_dim): 32, d_v (head_dim): 64, 1/sqrt(d_k) = 0.1768
Formulani haqiqiy qatlam ustida qo'lda qayta hisoblab tekshiramiz. Kirish — 3-bobdagi kabi bus.jpg:
import cv2

rasm = cv2.resize(cv2.imread(str(ASSETS / "bus.jpg")), (640, 640))[:, :, ::-1].copy()   # BGR -> RGB
xin = torch.from_numpy(rasm).permute(2, 0, 1)[None].float() / 255

saqla = {}
h = att.register_forward_hook(lambda m, i, o: saqla.update(kirish=i[0], chiqish=o))
with torch.no_grad():
    tarmoq(xin)
h.remove()

a = saqla["kirish"]                                              # (1, 128, 20, 20)
B, C, H, W = a.shape
N = H * W
with torch.no_grad():
    qkv = att.qkv(a).view(B, att.num_heads, 2 * att.key_dim + att.head_dim, N)
    q, k, v = qkv.split([att.key_dim, att.key_dim, att.head_dim], dim=2)   # har boshga Q, K, V
    A = torch.softmax(torch.einsum("bhdn,bhdm->bhnm", q, k) * att.scale, dim=-1)   # (1, boshlar, N, N)
    y = torch.einsum("bhdm,bhnm->bhdn", v, A).reshape(B, C, H, W)                # og'irlangan V yig'indisi
    y = att.proj(y + att.pe(v.reshape(B, C, H, W)))              # pe: joylashuv ma'lumoti (3x3 depthwise conv)
print("attention jadvali shakli:", tuple(A.shape))
print("har qator yig'indisi (birinchi 3 ta):", A[0, 0, :3].sum(-1).numpy().round(4))
print("qo'lda hisob vs qatlam chiqishi, eng katta farq:", float((y - saqla["chiqish"]).abs().max()))
attention jadvali shakli: (1, 2, 400, 400)
har qator yig'indisi (birinchi 3 ta): [          1           1           1]
qo'lda hisob vs qatlam chiqishi, eng katta farq: 0.0
Ikki katak nimaga "qarashini" ko'raylik: bitta odam turgan katak va bino devoridagi katak.
import matplotlib.pyplot as plt

natija = YOLO("weights/yolo11n.pt").predict(ASSETS / "bus.jpg", verbose=False)[0]   # alohida nusxa: predict
                                                                  # tarmoqni fuse qiladi, bizniki o'zgarmasin (3-bob)
xc, yc = natija.boxes.xywh[3, :2].tolist()                        # 1-bobdagi o'rtadagi odam (ishonchi 0.86)
H0, W0 = natija.orig_shape
odam = (int(yc / H0 * 20), int(xc / W0 * 20))                     # 20x20 to'rdagi (qator, ustun)
bino = (2, 15)                                                    # yuqori o'ng: bino devori
_, axes = plt.subplots(2, 2, figsize=(8.5, 8.5))
for qator, (nom, (r, c)) in zip(axes, [("odam", odam), ("bino", bino)]):
    for bosh, ax in enumerate(qator):
        xarita = A[0, bosh, r * 20 + c].reshape(20, 20).numpy()
        ax.imshow(rasm, alpha=0.55)
        ax.imshow(xarita, cmap="inferno", alpha=0.6, extent=(0, 640, 640, 0), interpolation="nearest")
        ax.add_patch(plt.Rectangle((c * 32, r * 32), 32, 32, fill=False, color="cyan", lw=2.5))
        ax.set_title(f"{nom} katagi {r, c}, {bosh}-bosh", fontsize=10)
        ax.axis("off")
fig("attention.png", "Moviy ramka — so'rovchi katak. Yorug' joylar — u eng ko'p e'tibor bergan kataklar.")
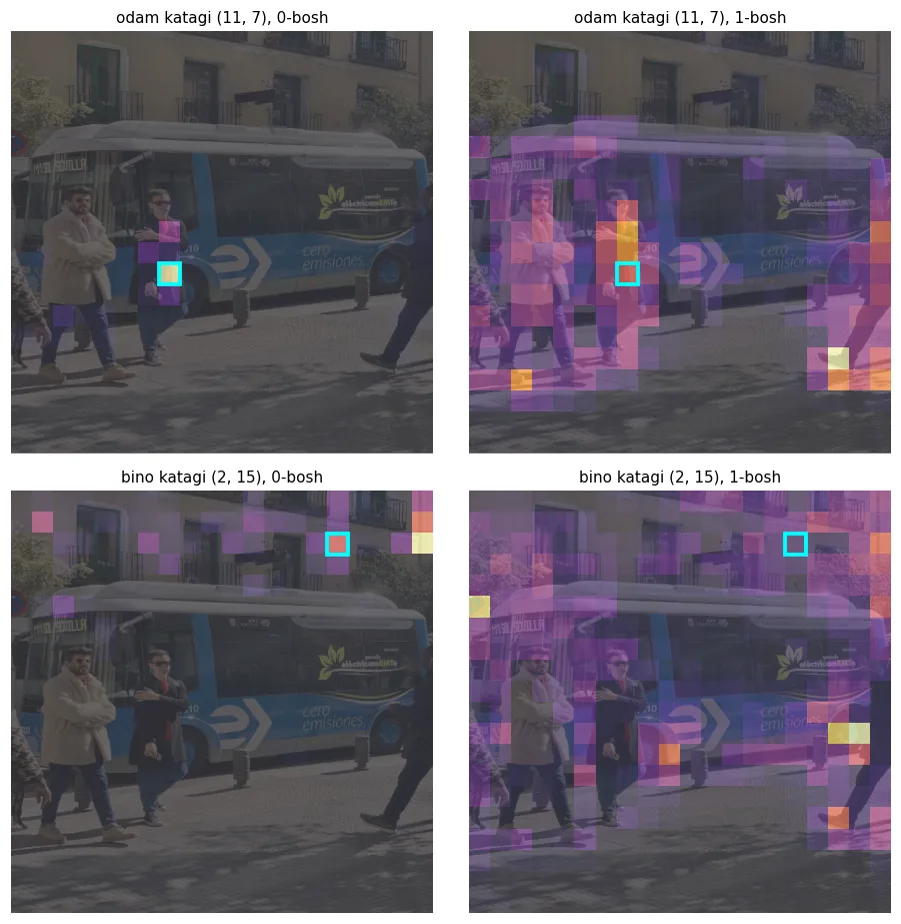
Moviy ramka — so'rovchi katak. Yorug' joylar — u eng ko'p e'tibor bergan kataklar.
Ikki bosh ikki xil ishlaydi. 0-bosh asosan yaqin va o'xshash joyga qaraydi: odam katagi — shu odamning o'zidagi yuqori va pastki kataklarga, bino katagi — bino devorining boshqa kataklariga. 1-bosh butun rasm bo'ylab tarqalgan: odam katagi boshqa odamlar turgan joylarga ham, masalan o'ng chetdagi odamning oyoqlariga qaraydi. Bu vazifalarni hech kim belgilamagan — tarmoq o'qitish davomida o'zi shunday taqsimlagan. Konvolyutsiya faqat qo'shnilarni ko'radi, attention esa bitta qadamda rasmning ikki uchini bog'laydi.
Attention nega faqat 10-qatlamda, eng kichik to'rda? Chunki jadval N × N:
for tor in (20, 40, 80):
    n = tor * tor
    print(f"{tor}x{tor} to'r: N = {n:5d}, attention jadvali N x N = {n * n:>12,} ta son (bitta bosh uchun)")
20x20 to'r: N =   400, attention jadvali N x N =      160,000 ta son (bitta bosh uchun)
40x40 to'r: N =  1600, attention jadvali N x N =    2,560,000 ta son (bitta bosh uchun)
80x80 to'r: N =  6400, attention jadvali N x N =   40,960,000 ta son (bitta bosh uchun)
Kataklar soni 16 barobar oshsa, jadval 16² = 256 barobar kattalashadi: 80 × 80 to'rda bitta bosh uchun 41 millionga yaqin son. Shuning uchun attention eng qo'pol to'rda, arzon joyda qo'llanadi, va u yerdan global ma'lumot neck orqali boshqa to'rlarga tarqatiladi.
Neck: FPN va PAN
Backbone ning chuqur qatlamlari "nima" ni yaxshi biladi (20 × 20 to'rda katta ko'rish maydoni, attention), lekin qo'pol: har katak 32 piksel. Sayoz qatlamlar aniq joyni biladi (80 × 80, har katak 8 piksel), lekin "tushunishi" kam. Neck ikkalasini aralashtiradi:
- Yuqoridan pastga (FPN, Lin va boshq., 2017): 20 × 20 dagi boy ma'lumot 2 barobar kattalashtirilib (
Upsample), 40 × 40 va keyin 80 × 80 dagi backbone chiqishi bilan yopishtiriladi (Concat). - Pastdan yuqoriga (PAN, Liu va boshq., 2018): 80 × 80 dagi aniq joy ma'lumoti qadam-2 li
Convbilan qaytadan 40 × 40 va 20 × 20 ga olib chiqiladi.
Kanallar × balandlik × kenglik — yolo11n uchun, 640 × 640 kirishda (o'lchamlar yuqoridagi ilgaklardan). Gorizontal strelkalar — Concat bilan yopishtiriladigan yon ulanishlar.
Neck qatlamlarining haqiqiy ulanishlari va shakllari:
qatorlar = []
for k in range(11, 23):
    q = tarmoq.model[k]
    qatorlar.append({"qatlam": k, "turi": type(q).__name__, "from": str(q.f),
                     "kirish shakllari": " + ".join(str(shakllar[j if j >= 0 else k - 1]) for j in (q.f if isinstance(q.f, list) else [q.f])),
                     "chiqish (C, H, W)": str(shakllar[k])})
show(pd.DataFrame(qatorlar), 12)
print("Detect kirishlari (from):", tarmoq.model[23].f)
Detect kirishlari (from): [16, 19, 22]
| qatlam | turi | from | kirish shakllari | chiqish (C, H, W) |
|---|---|---|---|---|
| 11 | Upsample | -1 | (256, 20, 20) | (256, 40, 40) |
| 12 | Concat | [-1, 6] | (256, 40, 40) + (128, 40, 40) | (384, 40, 40) |
| 13 | C3k2 | -1 | (384, 40, 40) | (128, 40, 40) |
| 14 | Upsample | -1 | (128, 40, 40) | (128, 80, 80) |
| 15 | Concat | [-1, 4] | (128, 80, 80) + (128, 80, 80) | (256, 80, 80) |
| 16 | C3k2 | -1 | (256, 80, 80) | (64, 80, 80) |
| 17 | Conv | -1 | (64, 80, 80) | (64, 40, 40) |
| 18 | Concat | [-1, 13] | (64, 40, 40) + (128, 40, 40) | (192, 40, 40) |
| 19 | C3k2 | -1 | (192, 40, 40) | (128, 40, 40) |
| 20 | Conv | -1 | (128, 40, 40) | (128, 20, 20) |
| 21 | Concat | [-1, 10] | (128, 20, 20) + (256, 20, 20) | (384, 20, 20) |
| 22 | C3k2 | -1 | (384, 20, 20) | (256, 20, 20) |
Concat kanallarni qo'shadi: 12-qatlamda 256 (kattalashtirilgan 10-qatlam) + 128 (backbone ning 6-qatlami) = 384. Detect ga uchta xarita boradi: 16 (80 × 80, kichik obyektlar), 19 (40 × 40) va 22 (20 × 20, katta obyektlar). 80 × 80 xaritaga yetib kelgan ma'lumot endi faqat sayoz qatlamdan emas: unda 10-qatlamdagi attention va SPPF ning global ko'rinishi ham bor.
Parametrlar qayerda
qismlar = {"backbone (0–10)": range(0, 11), "neck (11–22)": range(11, 23), "head: Detect (23)": range(23, 24)}
jami = sum(p.numel() for p in tarmoq.parameters())
qatorlar = []
for nom, oraliq in qismlar.items():
    p = sum(t.numel() for i in oraliq for t in tarmoq.model[i].parameters())
    qatorlar.append({"qism": nom, "parametr": p, "ulush, %": round(p / jami * 100, 1)})
qatorlar.append({"qism": "jami", "parametr": jami, "ulush, %": 100.0})
show(pd.DataFrame(qatorlar))
| qism | parametr | ulush, % |
|---|---|---|
| backbone (0–10) | 1 365 472 | 52 |
| neck (11–22) | 793 696 | 30.2 |
| head: Detect (23) | 464 912 | 17.7 |
| jami | 2 624 080 | 100 |
Parametrlarning yarmi backbone da. Detect esa bitta qatlam bo'lsa ham, har oltinchi parametr unda. Uning ichini 5-bobda ochamiz.
YOLO26 da nima o'zgargan
2-bobda YOLO26 ning tanasi YOLO11 bilan bir xil bloklardan qurilganini aytgan edik. Ikki yaml faylni qatlamma-qatlam solishtiramiz (izohlarsiz):
import difflib

def qatlamlar(yol):
    """yaml dan faqat qatlam qatorlari va bosh sozlamalari, izohlarsiz."""
    return [re.sub(r"\s*#.*", "", l).rstrip() for l in yol.read_text().splitlines()
            if l.strip().startswith(("- [", "end2end", "reg_max"))]

farq = difflib.unified_diff(qatlamlar(papka / "11" / "yolo11.yaml"), qatlamlar(papka / "26" / "yolo26.yaml"),
                            "yolo11.yaml", "yolo26.yaml", lineterm="", n=0)
print("\n".join(farq))
--- yolo11.yaml
+++ yolo26.yaml
@@ -0,0 +1,2 @@
+end2end: True
+reg_max: 1
@@ -10 +12 @@
-  - [-1, 1, SPPF, [1024, 5]]
+  - [-1, 1, SPPF, [1024, 5, 3, True]]
@@ -14 +16 @@
-  - [-1, 2, C3k2, [512, False]]
+  - [-1, 2, C3k2, [512, True]]
@@ -17 +19 @@
-  - [-1, 2, C3k2, [256, False]]
+  - [-1, 2, C3k2, [256, True]]
@@ -20 +22 @@
-  - [-1, 2, C3k2, [512, False]]
+  - [-1, 2, C3k2, [512, True]]
@@ -23 +25 @@
-  - [-1, 2, C3k2, [1024, True]]
+  - [-1, 1, C3k2, [1024, True, 0.5, True]]
- bilan boshlangan qator YOLO11 da, + bilan boshlangani YOLO26 da. O'zgarishlar oz va aniq:
- Bosh sozlamalari:
end2end: True(NMS siz bosh) vareg_max: 1(DFL yo'q) — 5-bobning mavzusi. - SPPF:
[1024, 5, 3, True]— max-pool soni aniq 3, va oxirgiTrue— SPPF atrofida ham qisqa tutashuv (y + x). - Neck dagi C3k2 lar (13, 16, 19-qatlamlar):
False→True, ya'nic3k=True— ichida oddiyBottlenecko'rniga og'irroqC3k, xuddi yolo11m dagi kabi, lekin n o'lchamida ham. - Oxirgi C3k2 (22-qatlam): takror 2 → 1 va
[1024, True, 0.5, True]— to'rtinchi argumentattn=True, ya'ni P5 chiqishi oldida yana bitta attention bloki. - Backbone ning qolgan qismi (0–8 va 10-qatlamlar) — aynan bir xil.
Asosiy fikr
- YOLO11 = yaml fayl +
parse_model. Bitta fayldan beshta model: kanallarwidthga, takrorlardepthga ko'paytiriladi, m/l/x da esa ba'zi bloklar og'irroq turga almashadi. - Asosiy g'ishtlar: C3k2 (bo'linish + qisqa tutashuv), SPPF (5 × 5 max-pool uch marta = 5, 9, 13 lik oynalar), C2PSA (400 katak ustida attention, faqat eng kichik to'rda).
- Neck (FPN + PAN) chuqur qatlamlarning "nima" ma'lumotini va sayoz qatlamlarning "qayerda" ma'lumotini aralashtiradi va Detect ga uch o'lchamli xarita beradi: 80², 40², 20².
Mashqlar
kanal()formulasi bilan yolo11s va yolo11x ning 10-qatlami (C2PSA) necha kanal bo'lishini qo'lda hisoblang. KeyinYOLO("yolo11s.yaml")bilan tekshiring. Nega x da 1024 · 1.5 = 1536 emas?attention.pngni boshqa katak uchun chizing: masalan avtobus g'ildiragi. Qaysi bosh "yaqin atrofga", qaysi biri "uzoqqa" qaraydi?yolo11.yamlnusxasini oling va neck dan PAN qismini (17–22-qatlamlar) olib tashlab, Detect ni[[16, 13, 10], ...]ga ulang. Model quriladimi? Parametrlar qanchaga kamaydi? (Og'irliksiz qurish yetarli, o'qitish shart emas.)
Bu bobni bepul o'qidingiz.
Kitob o'rgatadi, lekin sizning kodingiz nega ishlamaganini ayta olmaydi. Kursda uy vazifangiz tekshiriladi.