Fayl o'qish va yozish: CSV va Excel
Sahna: ma'lumot fayl bo'lib keladi
Hech kim jadvalni qo'lda yozib bermaydi. U fayl bo'lib keladi: CSV (vergul bilan ajratilgan matn), Excel, ba'zan boshqa dasturdan eksport. Bu bobda avtomobil e'lonlari faylini ochamiz va o'qishning oddiy ko'ringan, lekin keyin muammo beradigan joylarini ko'ramiz.
Kitob ma'lumotlari DATA papkada (sahifa yuqorisidan yuklab olishingiz mumkin).
read_csv: birinchi tanishuv
import pandas as pd

avto = pd.read_csv(DATA / "avto_savdo.csv")
print(avto.shape)
avto.head()
(612, 9)
| elon_id | sana | model | rang | yil | probeg_km | uzatma | viloyat | narx | |
|---|---|---|---|---|---|---|---|---|---|
| 0 | 1001 | 12.07.2025 | CAPTIVA | Qora | 2013 | NaN | Avtomat | Toshkent | 123 500 000 so'm |
| 1 | 1002 | 15.01.2025 | NEXIA 3 | Qizil | 2012 | 233862 | Avtomat | Toshkent | 32500000 |
| 2 | 1003 | 01.07.2025 | SPARK | Oq | 2024 | 31254 | Mexanika | Namangan | 93 000 000 so'm |
| 3 | 1004 | 08.07.2025 | Spark | Qizil | 2015 | 201 112 | Avtomat | Andijon | 36500000 |
| 4 | 1005 | 07.02.2025 | Onix | Qizil | 2021 | 86520 | Mexanika | Andijon | 142500000 |
read_csv faylni o'qib, DataFrame qaytaradi. Birinchi qator — ustun nomlari (sarlavha). head() — birinchi 5 qator: katta faylni ochganda hech qachon hammasini chiqarmang.
Endi eng muhim tekshiruv — pandas har ustunni qanday tur deb tushundi:
avto.dtypes
| 0 | |
|---|---|
| elon_id | int64 |
| sana | object |
| model | object |
| rang | object |
| yil | int64 |
| probeg_km | object |
| uzatma | object |
| viloyat | object |
| narx | object |
Ko'zga tashlanadigan uchta narsa:
narx—object(matn). Faylda "45 000 000 so'm" kabi yozilgan — bo'shliq va "so'm" bor, pandas buni son deb o'qiy olmadi.probeg_km— u hamobject: ba'zi qatorlarda son bo'shliq bilan yozilgan.sana—object: pandas sanani o'zi tanimadi.
Bu xato emas — pandas ehtiyotkor: shubhali ustunni matn sifatida qoldiradi, ma'lumot yo'qolmasin deb. Tozalash — bizning ish (12-bob). Hozir o'qish paytida tuzatsa bo'ladiganini tuzatamiz.
Sana: format aniq beriladi
avto = pd.read_csv(DATA / "avto_savdo.csv", parse_dates=["sana"], date_format="%d.%m.%Y")
print(avto["sana"].dtype)
print(avto["sana"].min(), "—", avto["sana"].max())
datetime64[ns]
2025-01-01 00:00:00 — 2025-10-27 00:00:00
Faylda sanalar 12.07.2025 — kun.oy.yil (O'zbekistonda shunday). date_format="%d.%m.%Y" — pandas ga aniq aytamiz: %d kun, %m oy, %Y to'rt xonali yil. Format bermasangiz, pandas taxmin qiladi — va 03.04.2025 ni 4-mart emas, 3-aprel deb o'qishi mumkin. Taxmin xato bo'lsa, ogohlantirish ham chiqmaydi.
Faqat keragini o'qish
Katta fayl bilan ishlaganda hammasini xotiraga yuklash shart emas:
kichik = pd.read_csv(DATA / "avto_savdo.csv", usecols=["model", "yil", "viloyat"], nrows=100,
                     dtype={"viloyat": "category"})
print(kichik.shape)
print(kichik.memory_usage(deep=True).round(-2).to_dict())
(100, 3)
{'Index': 100, 'model': 6300, 'yil': 800, 'viloyat': 900}
usecols— faqat shu ustunlar.nrows— faqat birinchi N qator: faylni tez "hidlab ko'rish" uchun.dtype={"viloyat": "category"}— takrorlanadigan matnlar uchun maxsus tur: har viloyat nomi bir marta saqlanadi, qatorlarda faqat kod.viloyatustunimodeldan ancha kam joy egallaganiga qarang.
Excel dan kelgan CSV: nuqta-vergul va vergulli kasr
O'zbek yoki rus tilidagi Windows da Excel "CSV" ni ko'pincha nuqta-vergul bilan saqlaydi, kasrni esa vergul bilan yozadi. Shunday faylni oddiy o'qisak nima bo'lishini ko'ramiz:
import io

excel_csv = "mahsulot;narx;soni\nNon;5000,50;3\nSut;12000,00;2\n"
print(pd.read_csv(io.StringIO(excel_csv)).shape)
togri = pd.read_csv(io.StringIO(excel_csv), sep=";", decimal=",")
print(togri.dtypes.to_dict())
togri
(2, 1)
{'mahsulot': dtype('O'), 'narx': dtype('float64'), 'soni': dtype('int64')}
| mahsulot | narx | soni | |
|---|---|---|---|
| 0 | Non | 5000.5 | 3 |
| 1 | Sut | 12000 | 2 |
Birinchi urinish — 2 qator, 1 ustun: pandas vergul kutdi, nuqta-vergulni ajratuvchi deb bilmadi, butun qatorni bitta matn qildi. sep=";" va decimal="," bilan — to'g'ri ustunlar va haqiqiy kasr sonlar. (io.StringIO — matnni fayl o'rniga ishlatish usuli; real hayotda bu yerda fayl yo'li turadi.)
Qoida: o'qigandan keyin darhol shape va dtypes ni tekshiring. Ustunlar soni kam yoki raqamli ustun object bo'lsa — ajratuvchi yoki format noto'g'ri.
Yozish: to_csv va index tuzog'i
yangi = avto[["elon_id", "model", "yil"]].head(3)
yangi.to_csv(ISH / "xato.csv")
yangi.to_csv(ISH / "togri.csv", index=False)
print(pd.read_csv(ISH / "xato.csv").columns.tolist())
print(pd.read_csv(ISH / "togri.csv").columns.tolist())
['Unnamed: 0', 'elon_id', 'model', 'yil']
['elon_id', 'model', 'yil']
to_csv standart holda index ni ham yozadi. Qaytadan o'qiganda u nomsiz ustun bo'lib kirib keladi — Unnamed: 0. Bir necha marta saqlab-o'qisangiz, Unnamed: 0.1, Unnamed: 0.2 ko'payib boradi. Index ma'noli bo'lmasa (0, 1, 2...) — doim index=False.
Excel
yangi.to_excel(ISH / "e'lonlar.xlsx", index=False, sheet_name="Avto")
qaytdi = pd.read_excel(ISH / "e'lonlar.xlsx", sheet_name="Avto")
print(qaytdi.equals(yangi.reset_index(drop=True)))
True
to_excel / read_excel ishlashi uchun openpyxl kutubxonasi kerak (pip install openpyxl). sheet_name — qaysi varaq. Excel faylida bir nechta varaq bo'lsa, sheet_name=None hammasini lug'at qilib qaytaradi.
Bir qarashda: e'lonlar qayerdan
avto["viloyat"].value_counts().plot(kind="bar", color="#1a73e8", title="E'lonlar soni, viloyat bo'yicha", rot=30)
plt.show()
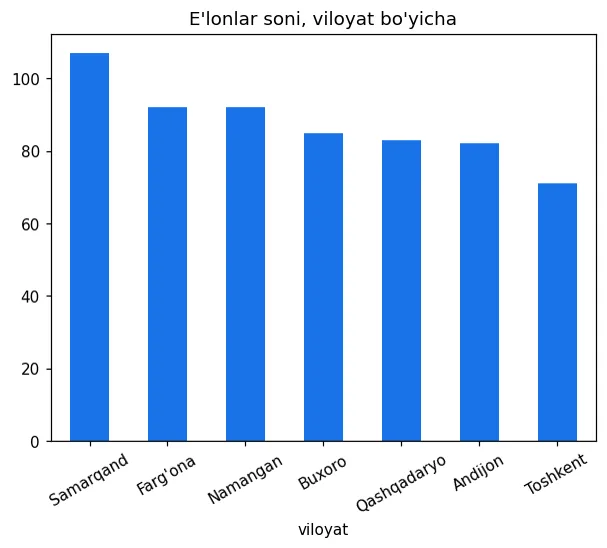
Fayl o'qildi — va bir qatorda birinchi savolga javob bor. Lekin ehtiyot bo'ling: hali tozalamadik. 12-bobda bu faylda takror qatorlar borligini topamiz — ular ham shu ustunlarda sanaldi.
Xulosa
pd.read_csv(fayl)→ DataFrame; darholshape,dtypes,head()bilan tekshiring.- Sana:
parse_dates+ aniqdate_format(%d.%m.%Y) — taxminga qoldirmang. - Katta fayl:
usecols,nrows, takrorlanuvchi matngacategory. - Excel CSV:
sep=";",decimal=",". - Yozish:
to_csv(..., index=False), aks holdaUnnamed: 0. - Excel:
to_excel/read_excel(openpyxlbilan).
Mashqlar
avto_savdo.csvni faqatmodelvanarxustunlari bilan, birinchi 10 qatorni o'qing."sana,summa\n05.03.2025,100\n06.03.2025,250"matnini sanani to'g'ri tushungan holda o'qing. Birinchi sana qaysi oy?dokon_savdo.csvni o'qing. Nechta qator, nechta ustun? Qaysi ustunlar son emas?
Javoblar
pd.read_csv(DATA / "avto_savdo.csv", usecols=["model", "narx"], nrows=10).parse_dates=["sana"], date_format="%d.%m.%Y"bilan — mart (3-oy).pd.read_csv(DATA / "dokon_savdo.csv")— 11 352 qator, 8 ustun;sana,vaqt,tolov—object.
Bu bobni bepul o'qidingiz.
Kitob o'rgatadi, lekin sizning kodingiz nega ishlamaganini ayta olmaydi. Kursda uy vazifangiz tekshiriladi.