Tanlash: loc, iloc va filtrlar
Sahna: "menga faqat ..."
Tahlilchiga keladigan savollarning aksariyati "faqat" so'zi bilan boshlanadi: faqat Toshkentdagi e'lonlar, faqat avtomat uzatmali, faqat 2020 dan yangi, faqat model va yil ustunlari. Bu bob — jadvaldan kerakli qator va ustunlarni olishning hamma usullari.
import pandas as pd

avto = pd.read_csv(DATA / "avto_savdo.csv", parse_dates=["sana"], date_format="%d.%m.%Y")
avto = avto.set_index("elon_id")
avto.head(3)
| elon_id | sana | model | rang | yil | probeg_km | uzatma | viloyat | narx |
|---|---|---|---|---|---|---|---|---|
| 1001 | 2025-07-12 00:00:00 | CAPTIVA | Qora | 2013 | NaN | Avtomat | Toshkent | 123 500 000 so'm |
| 1002 | 2025-01-15 00:00:00 | NEXIA 3 | Qizil | 2012 | 233862 | Avtomat | Toshkent | 32500000 |
| 1003 | 2025-07-01 00:00:00 | SPARK | Oq | 2024 | 31254 | Mexanika | Namangan | 93 000 000 so'm |
set_index("elon_id") — e'lon raqamini qator yorlig'i qildik. Endi har qatorning ma'noli nomi bor: 1001, 1002...
loc va iloc
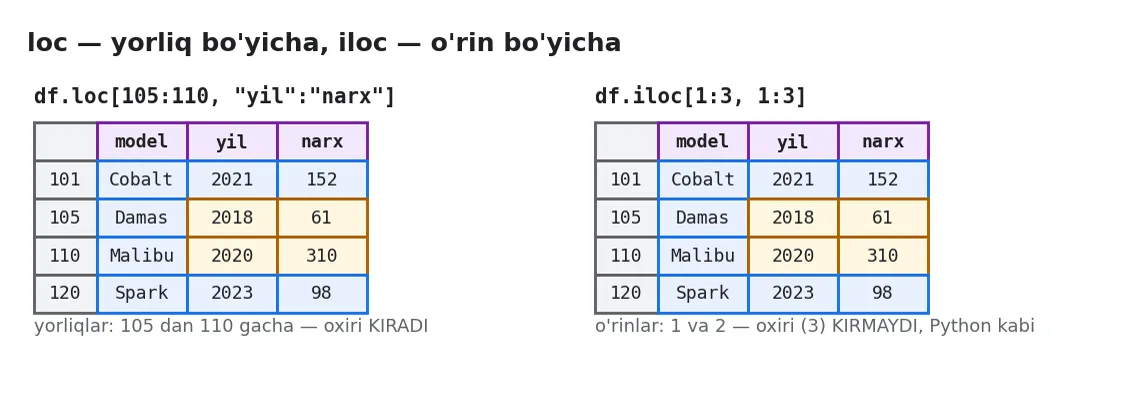
loc yorliq bo'yicha (oxiri kiradi), iloc o'rin bo'yicha (oxiri kirmaydi)
Ikki usul, ikki xil savol:
loc— "yorlig'i shu bo'lgan qator va ustun":avto.loc[1005, "yil"].iloc— "o'rni shu bo'lgan qator va ustun" (integer location):avto.iloc[4, 3]— 5-qator, 4-ustun.
print(avto.loc[1005, "model"], "|", avto.iloc[4, 1])
avto.loc[1003:1005, "model":"yil"]
Onix | Onix
| elon_id | model | rang | yil |
|---|---|---|---|
| 1003 | SPARK | Oq | 2024 |
| 1004 | Spark | Qizil | 2015 |
| 1005 | Onix | Qizil | 2021 |
loc da kesish oxirini ham oladi: 1003:1005 — uchta qator, "model":"yil" — model dan yil gacha hamma ustunlar. Yorliqlar bilan "oxirgisidan bittasi oldin" degan tushuncha ma'nosiz — yorliq raqam emas bo'lishi mumkin.
avto.iloc[2:5, [1, 4]]
| elon_id | model | probeg_km |
|---|---|---|
| 1003 | SPARK | 31254 |
| 1004 | Spark | 201 112 |
| 1005 | Onix | 86520 |
iloc — xuddi NumPy (3-bob): oxiri kirmaydi, ro'yxat bilan tanlash mumkin.
Qachon qaysi biri? Deyarli har doim loc: kod ustun nomi bilan yozilsa, ustunlar tartibi o'zgarganda ham to'g'ri ishlaydi. iloc — "birinchi 10 qator", "oxirgi ustun" kabi o'rin muhim bo'lgan joyda.
Shart bilan filtr
3-bobdagi mask pandas da ham ishlaydi:
toshkent = avto["viloyat"] == "Toshkent"
print(toshkent.sum(), "ta Toshkent e'loni")
yangi_avtomat = (avto["yil"] >= 2020) & (avto["uzatma"] == "Avtomat")
avto.loc[yangi_avtomat & toshkent, ["model", "yil", "narx"]].head()
71 ta Toshkent e'loni
| elon_id | model | yil | narx |
|---|---|---|---|
| 1128 | Captiva | 2020 | 280500000 |
| 1129 | Spark | 2022 | 69 000 000 so'm |
| 1370 | CAPTIVA | 2022 | 337500000 |
| 1206 | Captiva | 2024 | 408000000 |
| 1216 | Onix | 2024 | 209500000 |
loc[shart, ustunlar] — qatorlarni shart bilan, ustunlarni nom bilan bitta qadamda. Shartlar — & (va), | (yoki), ~ (emas), har biri qavsda — NumPy dagi qoida.
Filtr natijasi ham jadval — uni darhol rasmga aylantirish mumkin. Yangi avtomat mashinalar har viloyatdagi e'lonlarning qancha qismi?
ulush = (yangi_avtomat.groupby(avto["viloyat"]).mean() * 100).sort_values()
ax = ulush.plot(kind="barh", color="#1a73e8", title="2020+ avtomat mashinalar ulushi, %")
ax.axvline(yangi_avtomat.mean() * 100, color="#c5221f", linestyle="--", label="butun respublika")
ax.legend(loc="lower right")
plt.show()
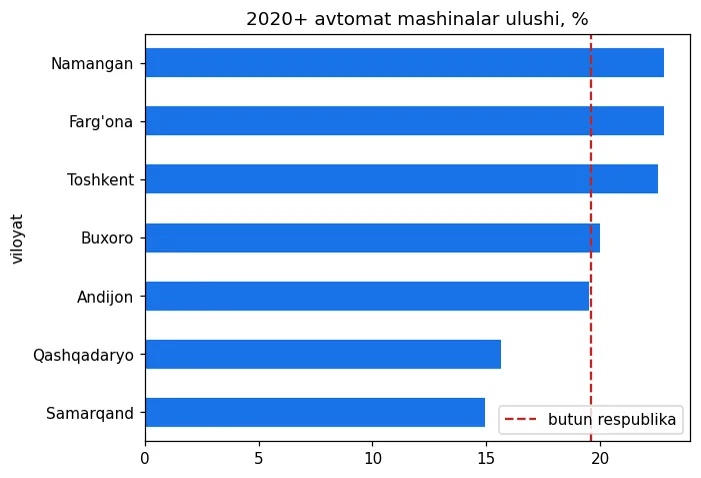
Mask — True/False; uning o'rtachasi — True lar ulushi (5-bob). groupby(avto["viloyat"]) uni har viloyat uchun alohida hisobladi (14-bob). Qizil chiziq — umumiy ulush: undan o'ngdagi viloyatlarda yangi avtomat mashinalar ko'proq.
Qulay filtrlar: isin, between, query
vodiy = avto["viloyat"].isin(["Andijon", "Namangan", "Farg'ona"])
print("vodiy:", vodiy.sum())
print("2015–2018:", avto["yil"].between(2015, 2018).sum())
avto.query("yil >= 2022 and uzatma == 'Mexanika' and viloyat != 'Toshkent'")[["model", "yil", "viloyat"]].head()
vodiy: 266
2015–2018: 198
| elon_id | model | yil | viloyat |
|---|---|---|---|
| 1003 | SPARK | 2024 | Namangan |
| 1006 | COBALT | 2024 | Samarqand |
| 1019 | Nexia 3 | 2024 | Buxoro |
| 1040 | GENTRA | 2022 | Samarqand |
| 1548 | SPARK | 2022 | Andijon |
isin([...])— ro'yxatdagi qiymatlardan biri: uchta|o'rniga.between(a, b)— oraliq, ikkala chegara kiradi.query("...")— shartni matn sifatida, ustun nomlari bilan. Uzun shartlarda o'qish oson;and/orni bu yerda so'z bilan yozish mumkin, chunkiqueryuni o'zi tarjima qiladi.
Matn bo'yicha filtr: .str
som_bilan = avto["narx"].str.contains("so'm")
mln_bilan = avto["narx"].str.contains("mln")
print("'so'm' bor:", som_bilan.sum(), "| 'mln' bor:", mln_bilan.sum(), "| faqat raqam:", (~som_bilan).sum())
avto.loc[mln_bilan, "narx"].head(3)
'so'm' bor: 447 | 'mln' bor: 89 | faqat raqam: 165
| elon_id | narx |
|---|---|
| 1006 | 138 mln so'm |
| 1007 | 166 mln so'm |
| 1024 | 68 mln so'm |
.str — matnli ustun uchun asboblar to'plami: contains, startswith, lower, replace... Shu filtr bilan narx ustuni uch xil formatda yozilganini topdik: "123 500 000 so'm", "45 mln so'm" va oddiy raqam. 12-bobda uchalasini bitta songa aylantiramiz.
Ustunlarni tur bo'yicha tanlash
print(avto.select_dtypes("number").columns.tolist())
print(avto.select_dtypes("object").columns.tolist())
['yil']
['model', 'rang', 'probeg_km', 'uzatma', 'viloyat', 'narx']
select_dtypes — ustunlarni nomi bilan emas, turi bilan tanlash. 10-bobdagi describe aynan shu bilan son ustunlarni ajratadi.
Saralash va eng kattalari
print(avto.sort_values(["yil", "model"], ascending=[False, True])[["model", "yil"]].head(4))
avto.nsmallest(3, "yil")[["model", "yil", "viloyat"]]
           model   yil
elon_id
1083      Cobalt  2024
1433       Damas  2024
1513       Damas  2024
1016      Malibu  2024
| elon_id | model | yil | viloyat |
|---|---|---|---|
| 1002 | NEXIA 3 | 2012 | Toshkent |
| 1020 | Captiva | 2012 | Buxoro |
| 1021 | Onix | 2012 | Buxoro |
sort_values — bir nechta ustun bo'yicha, har biriga o'z yo'nalishi. nlargest / nsmallest — "eng ... N tasi" savoliga bitta qadam (7-bobdagi argsort + kesish o'rniga).
Tanlab o'zgartirish: bitta qadamda
Toshkentdan tashqaridagi e'lonlarning uzatma ustuniga "?" belgisini qo'ymoqchimiz (masalan, ular qayta tekshirilishi kerak). Ikki yozish usuli bor, va faqat bittasi ishlaydi:
import warnings

nusxa = avto.copy()
with warnings.catch_warnings():
    warnings.simplefilter("ignore")
    nusxa[nusxa["viloyat"] != "Toshkent"]["uzatma"] = "?"
print("zanjir bilan:", (nusxa["uzatma"] == "?").sum(), "ta o'zgardi")

nusxa.loc[nusxa["viloyat"] != "Toshkent", "uzatma"] = "?"
print("loc bilan:   ", (nusxa["uzatma"] == "?").sum(), "ta o'zgardi")
zanjir bilan: 0 ta o'zgardi
loc bilan:    541 ta o'zgardi
Birinchi yozuv (df[shart]["ustun"] = ...) — zanjirli indekslash: df[shart] avval yangi jadval (nusxa) yasaydi, qiymat o'sha nusxaga yoziladi va darhol yo'qoladi. Asl jadval o'zgarmadi — 0 ta. pandas bunda ogohlantirish (SettingWithCopyWarning) beradi; biz uni bu yerda yashirdik, natijani ko'rsatish uchun. Real kodda bu ogohlantirishni hech qachon e'tiborsiz qoldirmang.
To'g'ri yo'l — bitta loc: qator sharti va ustun nomi bir qavs ichida. Shunda pandas aynan asl jadvalga yozadi.
Xulosa
loc— yorliq bo'yicha (kesishda oxiri kiradi),iloc— o'rin bo'yicha (oxiri kirmaydi). Odatdaloc.loc[shart, ustunlar]— qator va ustunni bitta qadamda.isin,between(chegaralar kiradi),query("..."),.str.contains.select_dtypes— ustunlarni turi bo'yicha.sort_values(bir nechta ustun),nlargest/nsmallest.- O'zgartirish — faqat
df.loc[shart, "ustun"] = qiymat;df[shart]["ustun"] = ...— jim xato.
Mashqlar
- Samarqanddagi oq rangli mashinalar nechta? Ularning modeli va yili.
ilocbilan oxirgi 3 qator va oxirgi 2 ustunni oling.querybilan: 2018 dan eski yoki probeg ko'rsatilmagan e'lonlar (maslahat:probeg_km.isna()query ichida ishlaydi).- Nega
avto.loc[1001:1003]3 ta qator beradi,avto.iloc[0:3]ham 3 ta — lekinavto.iloc[1001:1003]bo'sh?
Javoblar
avto.loc[(avto["viloyat"] == "Samarqand") & (avto["rang"] == "Oq"), ["model", "yil"]].avto.iloc[-3:, -2:].avto.query("yil < 2018 or probeg_km.isna()").iloco'rin bilan ishlaydi: jadvalda 612 qator, 1001-o'rin yo'q — natija bo'sh (xato emas, kesish shunday).
Bu bobni bepul o'qidingiz.
Kitob o'rgatadi, lekin sizning kodingiz nega ishlamaganini ayta olmaydi. Kursda uy vazifangiz tekshiriladi.