pandas: Series va DataFrame
Sahna: NumPy yetmay qolgan joy
1-qismda hamma narsa son edi. Real jadval esa boshqacha: avtomobil e'lonida model (matn), yil (butun son), narx (katta son), sana, rang, ba'zan bo'sh katak. NumPy array da hamma element bitta turda bo'lishi kerak — bunday jadval unga sig'maydi. Ustunlarning nomi ham yo'q: savdo[:, 3] — "3-ustun" nima ekanini eslab yurish kerak.
pandas shu ikki muammoni hal qiladi: har ustunning o'z nomi va o'z turi bor, qatorlarning esa yorlig'i (index). Ichida esa o'sha NumPy array lar — tezlik saqlanadi.
import pandas as pd

print(pd.__version__)
2.3.3
pd — np kabi umumiy qisqartma.
Series: nomli ustun
Series — bitta ustun: qiymatlar va ularning yorliqlari.
narx = pd.Series([5_000, 12_000, 18_000, 32_000], index=["non", "sut", "guruch", "yog'"], name="narx")
narx
| narx | |
|---|---|
| non | 5000 |
| sut | 12000 |
| guruch | 18000 |
| yog' | 32000 |
Chap tomondagi yorliqlar — index, o'ngdagi — qiymatlar. Endi element raqam bilan emas, nom bilan olinadi:
print(narx["sut"])
print(narx[narx > 10_000].index.tolist())
print(type(narx.values).__name__, narx.values)
12000
['sut', 'guruch', "yog'"]
ndarray [ 5000 12000 18000 32000]
narx.values — ichidagi oddiy NumPy array. Ya'ni 1-qismdagi hamma narsa (mask, aggregatsiya, broadcasting) Series da ham ishlaydi.
Index bo'yicha moslashish
pandas ning eng muhim va eng ko'p hayron qoldiradigan xususiyati — amallar o'rin bo'yicha emas, yorliq bo'yicha bajariladi:
chegirma = pd.Series([500, 1_000], index=["guruch", "non"])
narx - chegirma
| 0 | |
|---|---|
| guruch | 17500 |
| non | 4000 |
| sut | NaN |
| yog' | NaN |
chegirma ning birinchi elementi guruch, narx ning birinchisi non — lekin pandas ularni adashtirmadi: guruchdan guruchni, nondan nonni ayirdi. Juftsiz qolgan sut va yog' uchun natija — NaN ("noma'lum"): ayiradigan son yo'q edi. NumPy bu yerda o'rin bo'yicha ayirib, jim xato qilgan bo'lardi.
Juftsizlarga 0 kerak bo'lsa — buni aniq aytasiz:
narx.sub(chegirma, fill_value=0)
| 0 | |
|---|---|
| guruch | 17500 |
| non | 4000 |
| sut | 12000 |
| yog' | 32000 |
DataFrame: ustunlar to'plami
DataFrame — bir xil index ga ega Series lar to'plami: jadval.
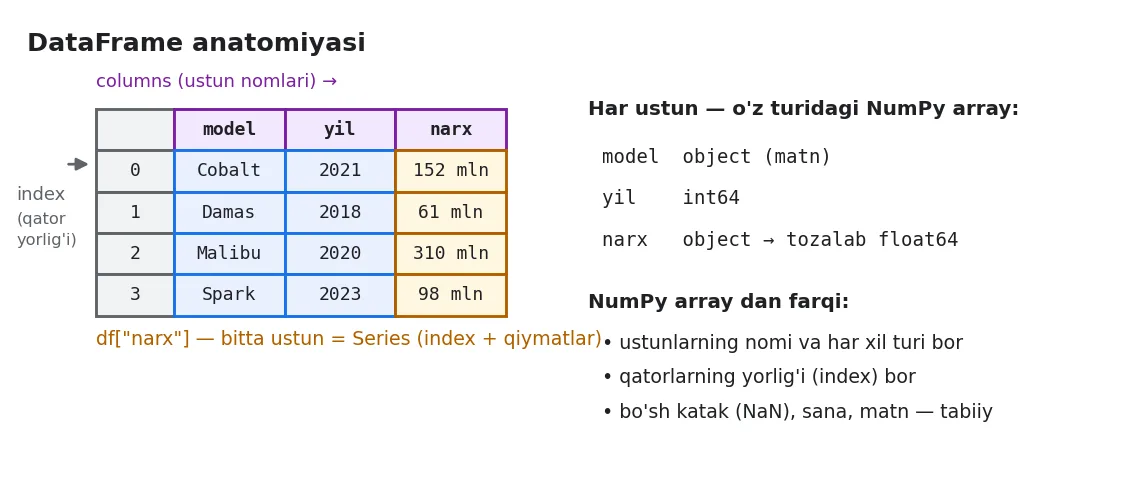
DataFrame anatomiyasi: index, ustun nomlari, har ustun — Series
DataFrame yasashning to'rt yo'li bor, va har biri o'z vaziyatida qulay:
lugatdan = pd.DataFrame({
    "model": ["Cobalt", "Damas", "Malibu", "Spark"],
    "yil": [2021, 2018, 2020, 2023],
    "narx_mln": [152.0, 61.5, 310.0, 98.0],
})
lugatdan
| model | yil | narx_mln | |
|---|---|---|---|
| 0 | Cobalt | 2021 | 152 |
| 1 | Damas | 2018 | 61.5 |
| 2 | Malibu | 2020 | 310 |
| 3 | Spark | 2023 | 98 |
- Lug'atdan — kalit ustun nomi, qiymat — ustun ma'lumoti. Qo'lda kichik jadval yozishning eng qulay yo'li.
yozuvlar = [
    {"model": "Gentra", "yil": 2019, "narx_mln": 128.0},
    {"model": "Onix", "yil": 2024},
]
pd.DataFrame(yozuvlar)
| model | yil | narx_mln | |
|---|---|---|---|
| 0 | Gentra | 2019 | 128 |
| 1 | Onix | 2024 | NaN |
- Yozuvlar ro'yxatidan — har element bitta qator. API va JSON dan keladigan ma'lumot aynan shunday ko'rinadi. Ikkinchi yozuvda narx yo'q edi — pandas xato bermadi,
NaNqo'ydi.
import numpy as np

rng = np.random.default_rng(0)
pd.DataFrame(rng.integers(20, 90, size=(3, 4)), columns=["Du", "Se", "Ch", "Pa"],
             index=["Chilonzor", "Yunusobod", "Sergeli"])
| Du | Se | Ch | Pa | |
|---|---|---|---|---|
| Chilonzor | 79 | 64 | 55 | 38 |
| Yunusobod | 41 | 22 | 25 | 21 |
| Sergeli | 32 | 76 | 65 | 83 |
-
NumPy array dan — ustun va qator nomlarini o'zingiz berasiz. 1-qismdagi savdo jadvali endi o'qilishi oson.
-
Fayldan — eng ko'p ishlatiladigan yo'l, keyingi bob to'liq shunga.
Jadvalning pasporti
df = lugatdan
print("shape:  ", df.shape)
print("columns:", df.columns.tolist())
print("index:  ", df.index)
print(df.dtypes)
shape:   (4, 3)
columns: ['model', 'yil', 'narx_mln']
index:   RangeIndex(start=0, stop=4, step=1)
model        object
yil           int64
narx_mln    float64
dtype: object
2-bobdagi NumPy pasporti bilan solishtiring: shape o'sha, lekin dtype endi har ustun uchun alohida. model — object (pandas da matn shunday ko'rinadi), yil — int64, narx_mln — float64.
Ustun olish: bitta qavs va ikkita qavs
print(type(df["model"]).__name__)
print(type(df[["model", "narx_mln"]]).__name__)
df[["model", "narx_mln"]]
Series
DataFrame
| model | narx_mln | |
|---|---|---|
| 0 | Cobalt | 152 |
| 1 | Damas | 61.5 |
| 2 | Malibu | 310 |
| 3 | Spark | 98 |
df["model"]— bitta ustun → Series.df[["model", "narx_mln"]]— ustunlar ro'yxati → DataFrame. Ichki qavs — Python ro'yxati, tashqi — tanlash.
df.model (nuqta bilan) ham ishlaydi, lekin faqat nom oddiy so'z bo'lsa: df["narx mln"] kabi bo'shliqli yoki df["count"] kabi metod nomi bilan bir xil ustunni nuqta bilan olib bo'lmaydi. Kitobda doim qavs ishlatamiz.
Yangi ustun — vektor amal
df["yoshi"] = 2025 - df["yil"]
df["narx_usd"] = (df["narx_mln"] * 1e6 / 12_650).round(0)
df
| model | yil | narx_mln | yoshi | narx_usd | |
|---|---|---|---|---|---|
| 0 | Cobalt | 2021 | 152 | 4 | 12016 |
| 1 | Damas | 2018 | 61.5 | 7 | 4862 |
| 2 | Malibu | 2020 | 310 | 5 | 24506 |
| 3 | Spark | 2023 | 98 | 2 | 7747 |
Sikl yo'q: 2025 - df["yil"] 4-bobdagi broadcasting — skalyar har qatorga. Natija o'sha index bilan yangi ustun bo'lib qo'shildi.
Bir qarashda: jadval rasmda
pandas ning har bir Series va DataFrame i o'zi chiza oladi (3-qismda batafsil):
df.set_index("model")["narx_mln"].sort_values().plot(kind="barh", color="#1a73e8", title="Narx, mln so'm")
plt.show()
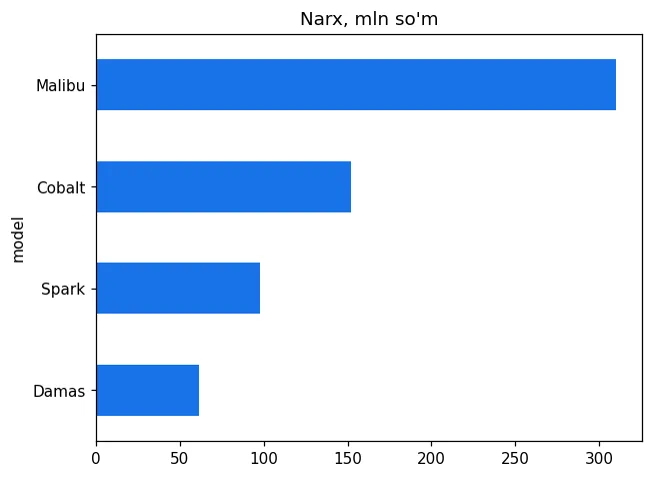
set_index("model") — model nomlarini index qildi, shuning uchun rasmda ular yorliq bo'lib chiqdi.
Xulosa
- pandas — nomli ustunlar, har xil turlar, qator yorliqlari; ichida NumPy.
- Series — bitta ustun (index + qiymatlar); DataFrame — umumiy index li Series lar.
- Amallar index bo'yicha moslashadi; juftsiz joy —
NaN. Kerak bo'lsafill_value. - DataFrame: lug'atdan, yozuvlar ro'yxatidan, NumPy array dan, fayldan.
df["a"]→ Series,df[["a", "b"]]→ DataFrame.
Mashqlar
- Uchta shahar va ularning aholisi (mln) bilan Series yasang, eng kattasini toping.
pd.Series([1, 2, 3]) + pd.Series([10, 20, 30], index=[1, 2, 3])natijasini taxmin qiling, keyin tekshiring.dfdan faqat 2020 yildan yangi mashinalarning model va narxini oling (maslahat: 3-bobdagi mask).
Javoblar
s.idxmax()— eng katta qiymat yorlig'i (argmaxning pandas varianti).[NaN, 12.0, 23.0, NaN]: index 0 va 3 juftsiz, 1 va 2 qo'shiladi.df[df["yil"] > 2020][["model", "narx_mln"]]— 11-bobda bunilocbilan bir qadamda qilamiz.
Bu bobni bepul o'qidingiz.
Kitob o'rgatadi, lekin sizning kodingiz nega ishlamaganini ayta olmaydi. Kursda uy vazifangiz tekshiriladi.