Tozalash: iflos ma'lumotdan ishonchli jadvalga
Sahna: to'rtta muammo
10-bobdagi so'roq avto_savdo.csv da to'rtta muammo topdi:
- 12 ta takror e'lon — hisobda ikki marta sanaladi.
- Model nomlari 45 xil yozilgan, aslida 9 ta model.
- Narx — matn, uch xil formatda: "123 500 000 so'm", "45 mln so'm", "32500000".
- Probeg — matn (bo'shliqli raqamlar) va 37 ta bo'sh katak.
Tozalash — tahlilning eng zerikarli va eng muhim qismi. Iflos ma'lumotdagi o'rtacha narx — chiroyli, aniq, va noto'g'ri son. Bu bobda to'rttasini tartib bilan tuzatamiz va har qadamdan keyin tekshiramiz.
import numpy as np
import pandas as pd

xom = pd.read_csv(DATA / "avto_savdo.csv", parse_dates=["sana"], date_format="%d.%m.%Y")
print(xom.shape)
(612, 9)
xom (xom ashyo) — asl jadvalga tegmaymiz, har qadam yangi jadval beradi. Xato qilsak, boshidan qaytamiz.
1. Takrorlar
print("takror qatorlar:", xom.duplicated().sum())
toza = xom.drop_duplicates()
print(xom.shape, "->", toza.shape)
print("elon_id endi noyobmi:", toza["elon_id"].is_unique)
takror qatorlar: 12
(612, 9) -> (600, 9)
elon_id endi noyobmi: True
drop_duplicates() butunlay bir xil qatorlarning birinchisini qoldiradi. Tekshiruv — is_unique: har e'lon raqami endi bir marta. Agar bir xil elon_id li, lekin boshqa narxli qatorlar bo'lganida — bu "takror" emas, "qaysi biri to'g'ri?" degan savol bo'lardi, va subset=["elon_id"] bilan ko'r-ko'rona o'chirish xato bo'lardi.
2. Matn birlashtirish
toza = toza.assign(model=toza["model"].str.strip().str.title())
print("modellar soni:", toza["model"].nunique())
print(sorted(toza["model"].unique()))
modellar soni: 9
['Captiva', 'Cobalt', 'Damas', 'Gentra', 'Malibu', 'Nexia 3', 'Onix', 'Spark', 'Tracker']
.str.strip() — boshi va oxiridagi bo'shliqlarni olib tashlaydi, .str.title() — har so'zni bosh harf bilan. 45 xil yozilish → 9 ta model. "Nexia 3" ham to'g'ri qoldi: raqamga title tegmaydi.
assign(model=...) — ustunni yangilab, yangi jadval qaytaradi (11-bobdagi loc bilan yozish asl jadvalni o'zgartiradi). Bu bobda asl xom ni saqlab qolish uchun shu usulni ishlatamiz.
Natijani rasmda solishtiramiz:
fig, (chap, ong) = plt.subplots(1, 2, figsize=(11, 3.4))
xom["model"].value_counts().plot(kind="bar", ax=chap, color="#c5221f", title=f"Oldin: {xom['model'].nunique()} xil")
toza["model"].value_counts().plot(kind="bar", ax=ong, color="#137333", title=f"Keyin: {toza['model'].nunique()} xil")
chap.set_xticks([])
ong.tick_params(axis="x", rotation=45)
plt.show()
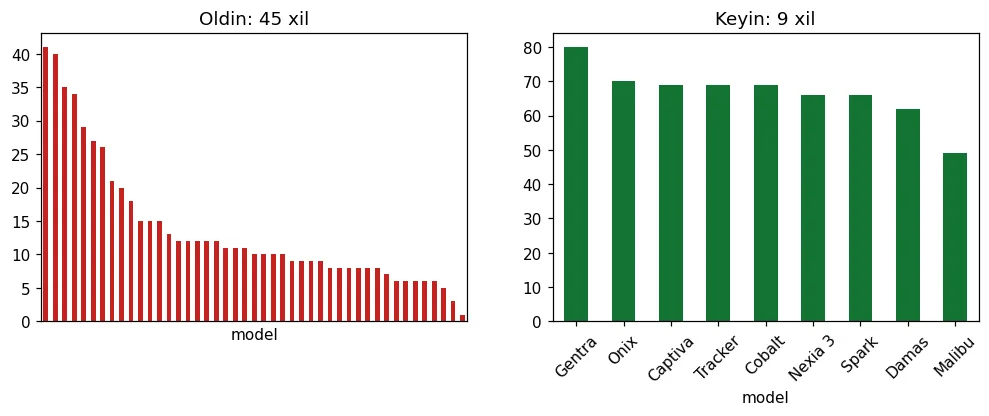
Chapda — bitta model bir nechta kichik ustunlarga "sochilgan". Shunday jadval bilan "eng mashhur model" savoli noto'g'ri javob beradi: tozalashdan oldin birinchi o'rinda Onix (41 e'lon) edi, keyin esa Gentra — 80 e'lon. Gentra ning e'lonlari besh xil yozilishga bo'linib ketgan edi.
3. Narxni songa aylantirish
Narx uch formatda. Har formatni alohida qoida bilan o'qiymiz:
matn = toza["narx"].str.lower().str.replace("so'm", "").str.replace(" ", "")
mln = matn.str.endswith("mln")
son = pd.to_numeric(matn.str.replace("mln", ""), errors="coerce")
narx = np.where(mln, son * 1_000_000, son)

namuna = pd.DataFrame({"asl": toza["narx"], "natija": narx}).groupby(mln.to_numpy()).head(2)
print(namuna.to_string())
print("son bo'lmay qolganlar:", pd.isna(narx).sum())
toza = toza.assign(narx=narx)
                asl     natija
0  123 500 000 so'm  123500000
1          32500000   32500000
5      138 mln so'm  138000000
6      166 mln so'm  166000000
son bo'lmay qolganlar: 0
Qadamlar:
lower(), keyin "so'm" va bo'shliqlarni olib tashlash: "123 500 000 so'm" → "123500000", "45 mln so'm" → "45mln".- Qaysilari "mln" bilan tugashini eslab qolamiz —
mlnmask. pd.to_numeric(..., errors="coerce")— matnni songa.coerce: songa aylanmaydigan narsa bo'lsa — xato emas,NaN. Keyin ularni sanaymiz: 0 ta — hammasi aylandi.np.where(3-bob): "mln" bo'lsa million barobar, aks holda o'zi.
Oxirgi tekshiruv — "son bo'lmay qolganlar" soni. Bu qatorni hech qachon tashlab ketmang: coerce jimgina NaN qo'yadi, va siz uni sanamasangiz, yo'qolgan narxlar o'rtachani indamay buzadi.
4. Probeg: matn va bo'sh kataklar
probeg = pd.to_numeric(toza["probeg_km"].astype(str).str.replace(" ", ""), errors="coerce")
print("bo'sh:", probeg.isna().sum(), "| eng kam:", probeg.min(), "| eng ko'p:", probeg.max())
toza = toza.assign(probeg_km=probeg)
bo'sh: 37 | eng kam: 9406.0 | eng ko'p: 262668.0
Bo'shliqlarni olib tashlab, songa aylantirdik. Bo'sh kataklar NaN bo'lib qoldi — endi ular bilan nima qilish kerak?
Bo'sh katak: o'chirish, to'ldirish yoki belgilash
Uchta yo'l bor, va to'g'risi savolga bog'liq:
| Usul | Qachon |
|---|---|
Qatorni o'chirish (dropna) |
bo'sh kataklar kam va tasodifiy; ustun tahlilda muhim |
To'ldirish (fillna) |
modelga butun jadval kerak; yaxshi taxmin bor |
| Belgilash (yangi ustun) | "bo'sh" ning o'zi ma'lumot bo'lishi mumkin |
Probeg mashina yoshiga qattiq bog'liq. Shuning uchun umumiy o'rtacha bilan to'ldirish (5-bobdagi tuzoq) yangi mashinaga 150 ming km, eskisiga 50 ming km yozib qo'yadi. Yaxshiroq taxmin — o'sha yildagi mashinalarning mediani:
toza = toza.assign(probeg_bormi=toza["probeg_km"].notna())
yil_mediani = toza.groupby("yil")["probeg_km"].transform("median")
umumiy = toza["probeg_km"].median()
toza = toza.assign(probeg_km=toza["probeg_km"].fillna(yil_mediani))

misol = toza.loc[~toza["probeg_bormi"], ["yil", "probeg_km"]].sort_values("yil").iloc[[0, -1]]
print(misol.to_string())
print(f"umumiy median bilan bo'lganda hammasiga {umumiy:,.0f} km yozilardi".replace(",", " "))
print("bo'sh qoldi:", toza["probeg_km"].isna().sum())
      yil  probeg_km
20   2012   240300.0
601  2024    28385.0
umumiy median bilan bo'lganda hammasiga 137 188 km yozilardi
bo'sh qoldi: 0
groupby("yil")["probeg_km"].transform("median") — har qatorga o'z yilining mediani (14-bobda groupby ni batafsil ochamiz; transform — natijani har qatorga qaytaradi). Eng eski va eng yangi mashinaga qarang: ularning to'ldirilgan probegi juda farq qiladi — umumiy median bilan esa bir xil bo'lardi.
probeg_bormi ustuni — belgi: keyinchalik "taxminiy probegli mashinalar" ni alohida ko'rish yoki modelga "bu qiymat taxminiy" deb aytish mumkin. To'ldirdik, lekin unutmadik.
Natija: oldin va keyin
toza.info()
<class 'pandas.core.frame.DataFrame'>
Index: 600 entries, 0 to 611
Data columns (total 10 columns):
 #   Column        Non-Null Count  Dtype
---  ------        --------------  -----
 0   elon_id       600 non-null    int64
 1   sana          600 non-null    datetime64[ns]
 2   model         600 non-null    object
 3   rang          600 non-null    object
 4   yil           600 non-null    int64
 5   probeg_km     600 non-null    float64
 6   uzatma        600 non-null    object
 7   viloyat       600 non-null    object
 8   narx          600 non-null    int64
 9   probeg_bormi  600 non-null    bool
dtypes: bool(1), datetime64[ns](1), float64(1), int64(3), object(4)
memory usage: 47.5+ KB
Hamma ustun to'g'ri turda, bo'sh katak yo'q, takror yo'q. Endi narx haqida birinchi ishonchli tahlil:
tartib = toza.groupby("model")["narx"].median().sort_values().index
fig, ax = plt.subplots(figsize=(10, 3.8))
ax.boxplot([toza.loc[toza["model"] == m, "narx"] / 1e6 for m in tartib], labels=tartib)
ax.set_ylabel("narx, mln so'm")
ax.set_title("Model bo'yicha narx (tozalangandan keyin)")
plt.show()
toza.groupby("model")["narx"].median().div(1e6).round(1).sort_values()
| model | narx |
|---|---|
| Spark | 42.8 |
| Damas | 44.5 |
| Nexia 3 | 58 |
| Gentra | 79.8 |
| Cobalt | 83 |
| Onix | 109.2 |
| Tracker | 164 |
| Malibu | 180 |
| Captiva | 197 |
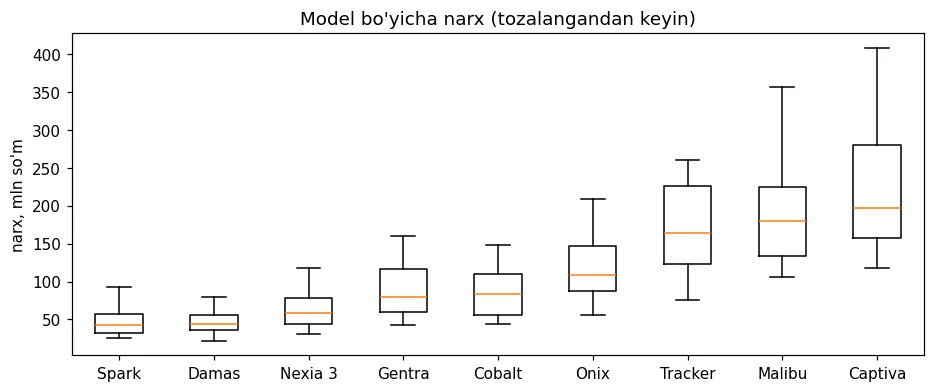
Spark va Damas eng arzon, Captiva eng qimmat — kutilganidek. Har qutining ichida esa katta tarqalish: bir xil model yiliga va probegiga qarab ikki-uch barobar farq qiladi. 14-bobda shu tarqalishni yil bo'yicha ochamiz.
Toza jadvalni saqlaymiz — o'z kompyuteringizda keyingi boblarni shu fayldan boshlashingiz mumkin (kitobning o'zida esa 13-bob butun tozalashni bitta zanjirda qaytadan bajaradi):
toza.to_csv(ISH / "avto_toza.csv", index=False)
print(toza.shape)
(600, 10)
Xulosa: tozalash tartibi
- Asl jadvalga tegmang —
xomsaqlanadi, har qadam yangi jadval. - Takrorlar —
drop_duplicates, keyin kalit ustunis_uniquemi. - Matn —
.str.strip(),.str.lower()/.title(); natijaninuniquebilan tekshiring. - Songa aylantirish — avval belgilarni olib tashlash, keyin
pd.to_numeric(errors="coerce"), va albatta nechtaNaNchiqqanini sanash. - Bo'sh kataklar — o'chirish, to'ldirish yoki belgilash; to'ldirsangiz — guruh bo'yicha va belgi ustuni bilan.
- Oxirida —
info()va oddiy rasm: natija mantiqqa mos keladimi.
Mashqlar
xomdan faqat narxi "mln" bilan yozilgan e'lonlarni oling. Ular ichida eng qimmati qancha (so'mda)?- Probegni yil mediani o'rniga model va yil bo'yicha median bilan to'ldiring (
groupby(["model", "yil"])). Qaysi qatorlar baribir bo'sh qolishi mumkin va nega? rangustunida yozilish xilma-xilligi bormi? Qanday tekshirasiz?
Javoblar
xom[xom["narx"].str.contains("mln")]dan keyin yuqoridagi 4 qadam,max().- Agar o'sha model-yil juftligida birorta ham ma'lum probeg bo'lmasa, median
NaN— to'ldirilmaydi. Shuning uchun ikkinchi qadamda yil mediani bilan to'ldirish kerak. xom["rang"].value_counts()— 5 ta qiymat, hammasi bir xil yozilgan: bu ustun toza.
Bu bobni bepul o'qidingiz.
Kitob o'rgatadi, lekin sizning kodingiz nega ishlamaganini ayta olmaydi. Kursda uy vazifangiz tekshiriladi.