Arxitektura: nega model hisoblamaydi
Ikki yo'l
AI ni jadval bilan ishlatishning ikki yo'li bor.
Birinchi yo'l: jadvalni modelga berasiz va so'raysiz: "filiallar bo'yicha jami qancha?" Model o'qiydi va raqam yozadi.
Ikkinchi yo'l: modelga jadvalni emas, faqat uning tavsifini berasiz: ustun nomlari, turlari, bir nechta namuna. Model raqam yozmaydi — plan yozadi: "filial bo'yicha guruhla, summa ustunini jamla". Planni engine bajaradi.
Birinchi yo'l oddiyroq ko'rinadi. Tez ikkinchisini tanladi. Bu bob — nega.
Model jadvalni ko'rmaydi ham
Eng oddiy sababdan boshlaymiz: hajm. Tezning testlarida ishlatiladigan sintetik kredit jadvalini olamiz. Bu jadval butunlay o'ylab topilgan: ismlar, summalar, sanalar — hammasini kompyuter yasagan. Lekin u ataylab haqiqiy bank fayliga o'xshatib "iflos" qilingan.
Model aynan nimani ko'rishini Tezning o'z kodi bilan yasaymiz — prompt/build.py:
from prompt import build

kontekst = build.load_context(TEZ / "prompt/domains/bank_loans")
jadval = kontekst["table"]
prompt = build.system_prompt(kontekst)
fayl = DATA / "loans.csv"

print(f"jadval: {jadval['name']}, {jadval['rows']:,} qator, {len(jadval['columns'])} ustun")
print(f"jadval fayli: {fayl.stat().st_size:,} bayt")
print(f"model ko'radigan prompt: {len(prompt):,} belgi")
print()
print(build.column_lines(jadval)[:900])
jadval: kreditlar, 20,000 qator, 22 ustun
jadval fayli: 4,074,219 bayt
model ko'radigan prompt: 7,283 belgi

- kredit_raqami (integer), samples: [500216, 500245, 500278]
- berilgan_sana (text), samples: ["2024-11-28", "02.04.2024", "14.04.2024"]
- filial (text), all values: ["Тошкент", "Namangan", "Samarqand ", "Samarqand", "Бухоро", "Toshkent", "Qarshi", "Andijon", "Buxoro"]
- viloyat (text), all values: ["Toshkent sh.", "Namangan", "Samarqand", "Andijon", "Buxoro", "Qashqadaryo"]
- qarzdor_id (integer), samples: [700127, 700018, 700054]
- qarzdor_ismi (text), all values: ["Saidova Gulnora", "Qodirov Sherzod", "Petrova Anna", "Nazarov Ulug'bek", "Мирзаев Анвар", "Toshpo'latova Nilufar", "Ergashev Javohir"]
- qarzdor_turi (text), all values: ["Jismoniy", "Yuridik", "YaTT"]
- kredit_turi (text), all values: ["Iste'mol krediti", "Ipoteka", "Biznes krediti", "Avtokredit", "Mikroqarz", "Ta'lim krediti"]
- valyuta (text), all values: ["UZS", "USD"]
- kredit_summasi (text), samples: ["102629561.14",
Yigirma ming qatorli fayl — to'rt million baytdan ortiq. Model ko'radigan butun prompt — bir necha ming belgi. Unda qatorlar yo'q. Har bir ustundan faqat uchta namuna, yoki ustunda qiymatlar kam bo'lsa — ularning ro'yxati.
Demak "filiallar bo'yicha jami qancha?" degan savolga model raqam yozsa, u raqam qayerdan keladi? Faqat bitta joydan: o'ylab topilgan bo'ladi. Model yigirma ming summaning birortasini ham ko'rmagan.
"Unda hamma qatorni promptga solaylik" — degan fikr kelishi mumkin. Tezdagi model serveri 8192
token kontekst bilan ishga tushadi (speed/config.json). 1-bobdagi bir million qatorli fayl esa
44.5 MB edi. Bu fayl hech qanday kichik modelning kontekstiga sig'maydi. Sig'ganda ham, kichik
model million sonni xatosiz qo'sha olishiga hech qanday kafolat yo'q.
Namunalardagi bir narsaga e'tibor bering: filial ustunida "Тошкент" va "Toshkent", "Samarqand"
va "Samarqand " (oxirida bo'sh joy bilan) — alohida qiymatlar. Haqiqiy bank fayllari ham xuddi
shunday. Bunday iflos qiymatlarni tozalash ham hisoblash — demak u ham engine ning ishi
(unify_spelling tooli, 10-bob).
Tezning qatlamlari
Endi butun yo'lni chizamiz. Rangli qutilar — bugun ishlaydigan kod. Kulrang quti — hali qurilmagan qism.
diagramma(
    {
        "So'rov\no'zbek / rus / ingliz": (0, 0, 2.6, 1.1, "manba"),
        "Prompt + JSON schema\nprompt/build.py": (3.4, 0, 2.8, 1.1, "qayta"),
        "Model\nllama-server, 127.0.0.1": (7.0, 0, 2.8, 1.1, "xizmat"),
        "JSON reja\nyoki savol": (7.0, 2.2, 2.8, 1.1, "kuzatuv"),
        "Dvigatel\naccuracy/execute.py": (3.4, 2.2, 2.8, 1.1, "qayta"),
        "DuckDB\nhaqiqiy raqamlar": (0, 2.2, 2.6, 1.1, "saqlash"),
        "Ilova: ko'rish, tasdiqlash,\nbekor qilish (hali yo'q)": (0, 4.4, 2.6, 1.1, "oddiy"),
    },
    [
        ("So'rov\no'zbek / rus / ingliz", "Prompt + JSON schema\nprompt/build.py"),
        ("Prompt + JSON schema\nprompt/build.py", "Model\nllama-server, 127.0.0.1"),
        ("Model\nllama-server, 127.0.0.1", "JSON reja\nyoki savol", "grammar ichida"),
        ("JSON reja\nyoki savol", "Dvigatel\naccuracy/execute.py"),
        ("Dvigatel\naccuracy/execute.py", "DuckDB\nhaqiqiy raqamlar", "SQL"),
        ("DuckDB\nhaqiqiy raqamlar", "Ilova: ko'rish, tasdiqlash,\nbekor qilish (hali yo'q)"),
    ],
    nom="qatlamlar.png",
    izoh="Tezning bugungi yo'li: so'rovdan raqamgacha",
)
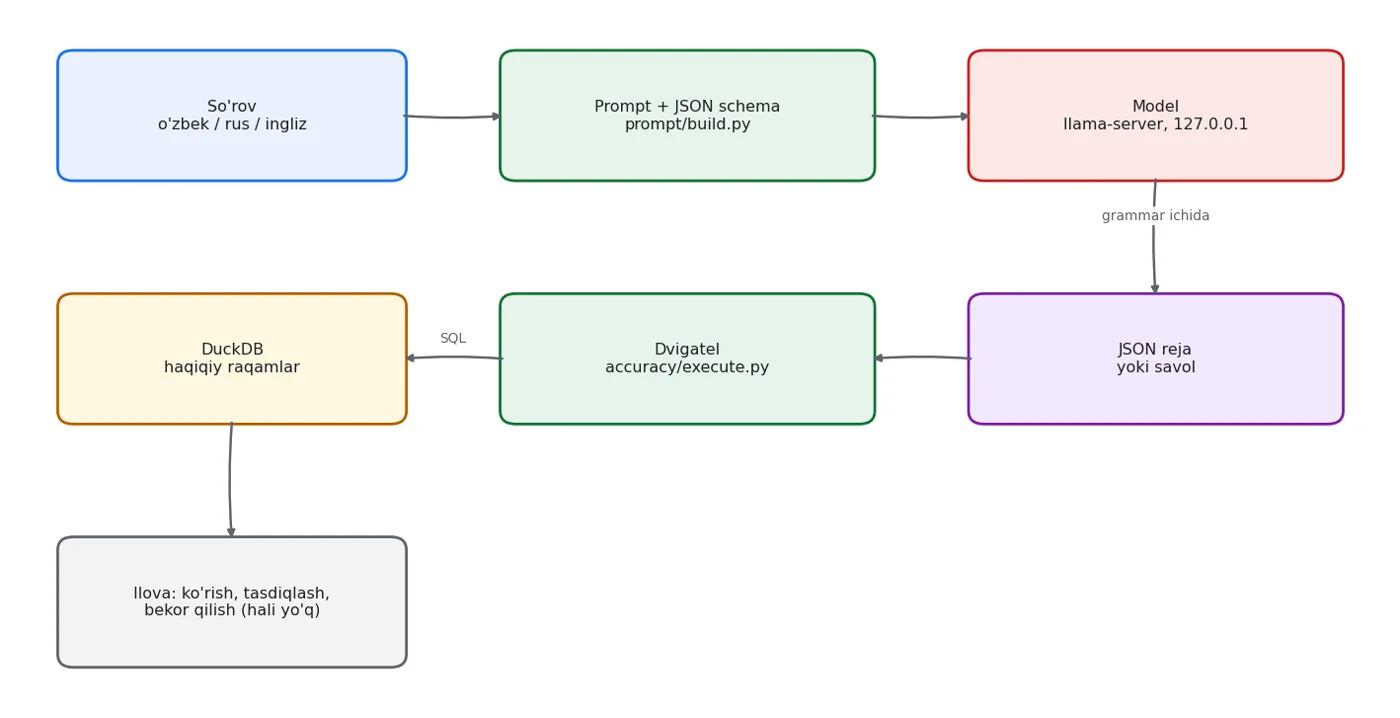
Tezning bugungi yo'li: so'rovdan raqamgacha
Har bir qatlamning bitta vazifasi bor:
| Qatlam | Nima qiladi | Nima qilmaydi |
|---|---|---|
prompt/build.py |
Jadval tavsifi, toollar ro'yxati va qoidalardan prompt yasaydi; javob shaklini JSON schema bilan cheklaydi | Qatorlarni modelga bermaydi |
| Model (llama-server) | So'rovni plan yoki savolga aylantiradi | Raqam yozmaydi, jadvalga tegmaydi |
accuracy/execute.py |
Planni qadamma-qadam bajaradi, har bir toolni tekshiradi | Model nima deganini "tuzatib" o'tirmaydi |
| DuckDB | Hamma hisobni bajaradi | O'zidan hech narsa qo'shmaydi — engine bergan SQL ni aniq bajaradi |
Model serveri faqat 127.0.0.1 manzilida tinglaydi — ya'ni faqat shu kompyuterning o'zidan
kirish mumkin. Tarmoqdagi boshqa kompyuter unga ulana olmaydi. Bu maxfiylikning birinchi qatori
(27-bobda to'liq).
Birinchi to'siq: grammar
Model plan yozadi — lekin u plan noto'g'ri bo'lsa-chi? Masalan, jadvalda yo'q ustun nomini yozsa?
Tezda bunga ikki to'siq bor. Birinchisi — model hali yozayotgan paytda ishlaydi. build.py
promptdan tashqari javobning aniq shaklini ham yasaydi — JSON schema. Model serveri bu
schemani grammar ga aylantiradi va model har bir tokenni faqat shu grammar ruxsat bergan
variantlardan tanlaydi.
Schema nimalarni cheklashini ko'raylik:
import json

schema = build.output_schema(kontekst)
reja_shakli, savol_shakli = schema["anyOf"]
variantlar = reja_shakli["properties"]["steps"]["items"]["anyOf"]
print(f"schema hajmi: {len(json.dumps(schema)):,} belgi")
print(f"bitta qadamning mumkin bo'lgan shakllari: {len(variantlar)}")
print(f"rejadagi qadamlar: {reja_shakli['properties']['steps']['minItems']} dan {reja_shakli['properties']['steps']['maxItems']} gacha")
print(f"savol uzunligi: {savol_shakli['properties']['ask']['maxLength']} belgigacha")
print()
print(json.dumps(variantlar[0], ensure_ascii=False, indent=1)[:700])
schema hajmi: 48,781 belgi
bitta qadamning mumkin bo'lgan shakllari: 85
rejadagi qadamlar: 1 dan 4 gacha
savol uzunligi: 300 belgigacha

{
 "type": "object",
 "properties": {
  "tool": {
   "const": "filter"
  },
  "args": {
   "type": "object",
   "properties": {
    "column": {
     "type": "string",
     "enum": [
      "filial"
     ]
    },
    "op": {
     "enum": [
      "=",
      "!="
     ]
    },
    "value": {
     "enum": [
      "Тошкент",
      "Namangan",
      "Samarqand ",
      "Samarqand",
      "Бухоро",
      "Toshkent",
      "Qarshi",
      "Andijon",
      "Buxoro"
     ]
    }
   },
   "required": [
    "column",
    "op",
    "value"
   ],
   "additionalProperties": false
  }
 },
 "required": [
  "tool",
  "args"
 ],
 "additionalProperties": false
}
Birinchi variantni o'qing: filter tooli, filial ustuni, = yoki != amali — va value
uchun faqat jadvalda bor qiymatlar ro'yxati. = amalida model "Ташкент" yoki "Tashkent" deb
yoza olmaydi, chunki grammar unga bunday harflar ketma-ketligini bermaydi. U faqat jadvalda
haqiqatan bor "Toshkent" yoki "Тошкент" ni tanlay oladi. (contains yoki > kabi amallarda esa
qiymat erkin — u yerda ro'yxat bilan cheklab bo'lmaydi.)
Ustun nomlari ham xuddi shunday: faqat jadvaldagi nomlar. Tool nomlari ham: faqat o'n beshta. Schema har bir jadval uchun qaytadan yasaladi — shuning uchun model har doim aynan shu jadvalning ustunlari bilan cheklanadi.
Grammar ham xato qilishi mumkin
Grammar bizni ko'p narsadan himoya qiladi, lekin uning o'zi ham tuzoq bo'lishi mumkin. tez9 modeli yetti soat o'qitilganidan keyin birinchi testda juda yomon chiqdi — va sababi model emas, grammar edi: llama.cpp ixtiyoriy kalitlarni majburiylaridan keyinga qo'yadi, model esa boshqa tartibda o'rgangan edi. Bu hikoya 9-bobda. (Grammar tuzatilgandan keyin ham tez9 eski modeldan yutmadi — lekin bu boshqa sabab, 21-bob.)
Ikkinchi to'siq: engine
Grammar shaklni tekshiradi. Lekin ba'zi xatolar shakl jihatidan to'g'ri bo'ladi. Masalan, ko'p qadamli planda ikkinchi qadam birinchi qadam natijasida yo'q ustunni so'rashi mumkin.
Ikkinchi to'siq — engine. Har bir tool ishga tushishdan oldin ustunlar haqiqatan borligini tekshiradi. Yo'q ustun bilan plan beramiz:
from accuracy.run import open_data, BASE
from accuracy.execute import run_plan
from accuracy.tools import ToolError

sozlamalar = json.load(open(TEZ / "accuracy/settings.json", encoding="utf-8"))
con = open_data(str(fayl))
print(f"bazaga yuklandi: {con.execute(f'select count(*) from {BASE}').fetchone()[0]:,} qator")

yomon_reja = [{"tool": "group_and_total", "args": {"group_by": ["mijoz"], "value_column": "qoldiq_uzs", "agg": "sum"}}]
try:
    run_plan(con, BASE, yomon_reja, sozlamalar)
except ToolError as xato:
    print(f"reja to'xtatildi: {xato}")
bazaga yuklandi: 20,000 qator
reja to'xtatildi: columns not in current result: mijoz
Plan bajarilmadi va sababi aniq aytildi. Hech qanday "taxminiy" natija chiqmadi. Bu muhim: noto'g'ri plan to'xtashi kerak, jim o'tib ketmasligi kerak.
Qanday bilamizki, plan to'g'ri?
Endi eng nozik savol. Model plan yozdi, engine uni xatosiz bajardi. Lekin natija so'ralgan narsami?
Testlarda biz buni shunday tekshiramiz: har bir test savoliga to'g'ri planni oldindan yozib
qo'yganmiz. Model plani ham, to'g'ri plan ham bajariladi va natijalari solishtiriladi —
accuracy/compare.py dagi same_result. Planlarning matni emas, natijalari.
Nega matn emas? Chunki bitta savolga bir nechta to'g'ri plan bo'lishi mumkin:
from accuracy.compare import same_result

def bajar(qadamlar):
    return run_plan(con, BASE, qadamlar, sozlamalar)

jamla = {"tool": "group_and_total", "args": {"group_by": ["viloyat"], "value_column": "qoldiq_uzs", "agg": "sum"}}
a = bajar([{"tool": "filter", "args": {"column": "valyuta", "op": "=", "value": "USD"}}, jamla])
b = bajar([{"tool": "filter", "args": {"column": "valyuta", "op": "in", "values": ["USD"]}}, jamla])
c = bajar([jamla])

print("A: valyuta = USD, keyin viloyat bo'yicha jami")
print("B: valyuta ro'yxatda [USD], keyin viloyat bo'yicha jami")
print("C: filtrsiz, viloyat bo'yicha jami")
print(f"A va B bir xilmi: {same_result(a, b, sozlamalar)}")
print(f"A va C bir xilmi: {same_result(a, c, sozlamalar)}")
A: valyuta = USD, keyin viloyat bo'yicha jami
B: valyuta ro'yxatda [USD], keyin viloyat bo'yicha jami
C: filtrsiz, viloyat bo'yicha jami
A va B bir xilmi: True
A va C bir xilmi: False
A va B — har xil yozilgan, lekin bir xil natija beradigan planlar. same_result ularni teng deb
biladi. C esa filtrni tashlab yuborgan — natija boshqa, va same_result buni ushlaydi.
Bu usulning bir kamchiligi bor va uni ochiq aytish kerak: ikki xil plan tasodifan bir xil natija bersa, test xatoni sezmaydi. Masalan, jadvalda faqat USD kreditlari qolgan bo'lsa, filtrli va filtrsiz plan bir xil chiqadi. Shuning uchun test savollari va jadvallar shunday tanlanadiki, noto'g'ri plan ko'rinadigan farq bersin (23-bob).
Planda bor, kodda yo'q
Loyiha boshidagi arxitektura plani bundan kattaroq edi. Unda yana bir nechta qatlam bor:
- Ilova (React va ECharts): oyna, jadval, jonli grafiklar.
- API (FastAPI): ilova va engine orasidagi ko'prik.
- Tarix va bekor qilish: har bir qadam yangi versiya yaratadi, hech narsa ustidan yozilmaydi, bir bosishda orqaga qaytish.
- Avtomatik tekshiruvlar: har bir qadamdan keyin qator soni, jamilar, bo'sh kataklar manba bilan solishtiriladi; tekshiruv o'tmasa, qadam to'xtaydi.
- Oldindan ko'rish va tasdiqlash: odam o'zgarishni ko'radi va "ha" deydi.
Bularning hech biri hali kod sifatida yo'q. Bugun bor narsa — diagrammadagi rangli qutilar: prompt, model, engine, DuckDB. Ular test to'plamlari orqali ishlatiladi, ilova orqali emas.
Biz bu tartibni ongli tanladik va 2-bobda sababini aytdik. Lekin arxitektura shunday qurilganki,
ilova keyin ustiga qo'shiladi: engine planni qayerdan kelganini bilmaydi — testdanmi,
ilovadanmi. Bir xil run_plan ikkalasiga ham xizmat qiladi.
Xulosa
- Model jadvalni ko'rmaydi: u faqat ustun nomlari va bir nechta namunani ko'radi. Shuning uchun u raqam yozsa — bu o'ylab topilgan raqam bo'lardi.
- Model plan yozadi, DuckDB hisoblaydi. Har bir qatlamning bitta vazifasi bor.
- Noto'g'ri planga qarshi ikki to'siq: grammar (model faqat bor ustun, bor qiymat va o'n besh tooldan tanlaydi) va engine (yo'q ustun bo'lsa, plan to'xtaydi).
- Planning to'g'riligini matni bilan emas, natijasi bilan tekshiramiz (
same_result). - Ilova, tarix, avtomatik tekshiruvlar — hali planda.
Bu bilan birinchi qism tugadi: muammo, maqsad va arxitektura. Ikkinchi qismda bitta qator kod yozishdan oldin nimalarni o'lchaganimizni ko'ramiz — Excel o'qishdan boshlab.
Bu bobni bepul o'qidingiz.
Kitob o'rgatadi, lekin sizning kodingiz nega ishlamaganini ayta olmaydi. Kursda uy vazifangiz tekshiriladi.