Jadvalni o'zgartirish: yangi ustunlar, apply va zanjir
Sahna: toza jadvaldan foydali jadvalga
12-bobda jadvalni to'g'rilab chiqdik. Endi uni boyitamiz: mashina yoshi, narx toifasi, mln da narx, uzatmani raqam qilish — har biri yangi savolga javob berish uchun. ML da buni feature engineering deyiladi: mavjud ustunlardan yangi, foydaliroq ustunlar yasash.
Avval toza jadvalni tiklaymiz — 12-bobdagi hamma qadam, lekin bitta zanjir bo'lib:
import numpy as np
import pandas as pd


def narxni_son(ustun):
    matn = ustun.str.lower().str.replace("so'm", "").str.replace(" ", "")
    son = pd.to_numeric(matn.str.replace("mln", ""), errors="raise")
    return son.where(~matn.str.endswith("mln"), son * 1_000_000)


avto = (
    pd.read_csv(DATA / "avto_savdo.csv", parse_dates=["sana"], date_format="%d.%m.%Y")
    .drop_duplicates()
    .assign(
        model=lambda d: d["model"].str.strip().str.title(),
        narx=lambda d: narxni_son(d["narx"]),
        probeg_km=lambda d: pd.to_numeric(d["probeg_km"].astype(str).str.replace(" ", ""), errors="coerce"),
    )
    .assign(probeg_km=lambda d: d["probeg_km"].fillna(d.groupby("yil")["probeg_km"].transform("median")))
    .reset_index(drop=True)
)
print(avto.shape, "| bo'sh:", avto.isna().sum().sum(), "| modellar:", avto["model"].nunique())
(600, 9) | bo'sh: 0 | modellar: 9
Bu method chaining (zanjir): har metod jadval qaytaradi, keyingisi shu jadvalga qo'llanadi. Afzalligi — oraliq o'zgaruvchilar (toza, matn, son...) yo'q, butun tozalash yuqoridan pastga bitta retsept bo'lib o'qiladi.
Ikki tafsilot:
assignichidagilambda d: ...— "zanjirning shu nuqtasidagi jadval". Ikkinchiassigndagidda narx va probeg allaqachon son.- Narx funksiyasida
errors="raise": 12-bobda hammasi songa aylanishini tekshirgan edik. Endi kelajakda yangi, noma'lum format paydo bo'lsa — jimNaNemas, darhol xato. Tekshirilgan qadamni "qattiq" qilish — yaxshi odat.
Oddiy yangi ustunlar
avto = avto.assign(
    yoshi=2025 - avto["yil"],
    narx_mln=(avto["narx"] / 1e6).round(1),
    avtomat=(avto["uzatma"] == "Avtomat").astype(int),
)
avto[["model", "yil", "yoshi", "narx_mln", "uzatma", "avtomat"]].head()
| model | yil | yoshi | narx_mln | uzatma | avtomat | |
|---|---|---|---|---|---|---|
| 0 | Captiva | 2013 | 12 | 123.5 | Avtomat | 1 |
| 1 | Nexia 3 | 2012 | 13 | 32.5 | Avtomat | 1 |
| 2 | Spark | 2024 | 1 | 93 | Mexanika | 0 |
| 3 | Spark | 2015 | 10 | 36.5 | Avtomat | 1 |
| 4 | Onix | 2021 | 4 | 142.5 | Mexanika | 0 |
Hammasi vektor amal (4-bob): sikl yo'q. avtomat — "ha/yo'q" ni 1/0 ga aylantirish: ko'p ML modellar faqat son qabul qiladi.
map: lug'at bo'yicha almashtirish
segment = {"Damas": "tijorat", "Spark": "kichik", "Nexia 3": "sedan", "Cobalt": "sedan", "Gentra": "sedan",
           "Onix": "sedan", "Malibu": "biznes", "Tracker": "krossover", "Captiva": "krossover"}
avto["segment"] = avto["model"].map(segment)
print("segmentsiz qolgan:", avto["segment"].isna().sum())
avto["segment"].value_counts()
segmentsiz qolgan: 0
| segment | count |
|---|---|
| sedan | 285 |
| krossover | 138 |
| kichik | 66 |
| tijorat | 62 |
| biznes | 49 |
map har qiymatni lug'atdan qidiradi. Lug'atda yo'q qiymat NaN bo'ladi — shuning uchun darhol sanadik. Kelajakda yangi model qo'shilsa ("Equinox"), u jim NaN bo'lib qolmasligi uchun shu tekshiruvni kodda qoldiring.
Toifalarga bo'lish: cut va qcut
Narx — uzluksiz son. Hisobot uchun ko'pincha toifalar kerak: "arzon", "o'rta", "qimmat".
chegaralar = [0, 70, 150, np.inf]
avto["toifa"] = pd.cut(avto["narx_mln"], bins=chegaralar, labels=["arzon", "o'rta", "qimmat"])
avto["kvartil"] = pd.qcut(avto["narx_mln"], q=4, labels=["Q1", "Q2", "Q3", "Q4"])
print(avto["toifa"].value_counts().sort_index().to_dict())
print(avto["kvartil"].value_counts().sort_index().to_dict())
{'arzon': 229, "o'rta": 220, 'qimmat': 151}
{'Q1': 157, 'Q2': 143, 'Q3': 151, 'Q4': 149}
cut— chegaralarni siz berasiz: 0–70, 70–150, 150 dan yuqori. Toifalardagi mashinalar soni har xil.qcut— chegaralarni pandas taqsimotga qarab tanlaydi, har toifada teng sonda: to'rt chorak (kvartil) har birida ~150 mashina.
Qaysi biri kerakligi savolga bog'liq: "100 mln dan qimmat mashinalar qancha?" — cut; "eng qimmat chorakda qaysi modellar?" — qcut.
fig, ax = plt.subplots(figsize=(9, 3.2))
ax.hist(avto["narx_mln"], bins=40, color="#a8c7fa")
for c in chegaralar[1:-1]:
    ax.axvline(c, color="#c5221f", linewidth=2)
for c in avto["narx_mln"].quantile([0.25, 0.5, 0.75]):
    ax.axvline(c, color="#137333", linestyle="--")
ax.set_xlabel("narx, mln so'm")
ax.set_title("Qizil — cut chegaralari (biz tanladik), yashil — qcut chegaralari (taqsimot tanladi)")
plt.show()
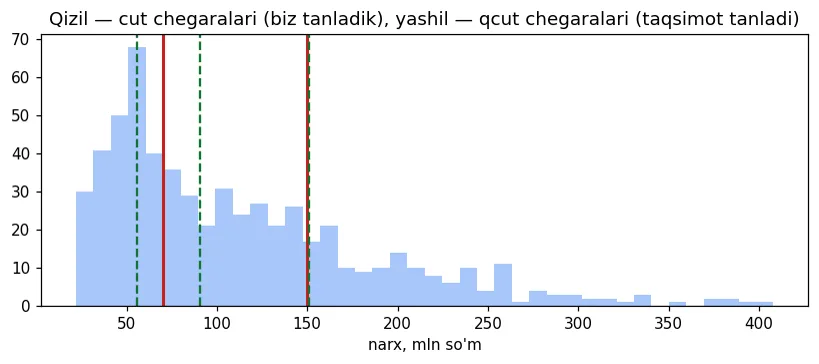
Rasmda farq ko'rinadi: yashil chiziqlar mashinalar zich joyda bir-biriga yaqin, qizil chiziqlar esa biz qo'ygan "yumaloq" sonlarda.
apply: har qatorga o'z funksiyangiz
Ba'zi qoidalar bir nechta ustunga qaraydi. Masalan, "avtomat va 5 yoshdan yosh bo'lsa — premium taklif":
def taklif(qator):
    if qator["avtomat"] == 1 and qator["yoshi"] <= 5:
        return "premium"
    return "oddiy" if qator["narx_mln"] < 150 else "kafolat"


avto["taklif"] = avto.apply(taklif, axis=1)
avto["taklif"].value_counts()
| taklif | count |
|---|---|
| oddiy | 407 |
| premium | 117 |
| kafolat | 76 |
apply(..., axis=1) — funksiyani har qatorga (5-bobdagi axis: qatorlar bo'ylab emas, har qator alohida) chaqiradi. O'qilishi oson — oddiy Python if. Narxi bor:
import time

katta = pd.concat([avto] * 50, ignore_index=True)
boshi = time.perf_counter()
sekin = katta.apply(taklif, axis=1)
apply_s = time.perf_counter() - boshi

boshi = time.perf_counter()
tez = np.select(
    [(katta["avtomat"] == 1) & (katta["yoshi"] <= 5), katta["narx_mln"] < 150],
    ["premium", "oddiy"], default="kafolat")
select_s = time.perf_counter() - boshi
print(f"{len(katta)} qator: apply {apply_s:.3f} s, np.select {select_s:.4f} s, natija bir xil: {(sekin == tez).all()}")
30000 qator: apply 0.104 s, np.select 0.0007 s, natija bir xil: True
apply(axis=1) — aslida yashirin Python sikli: har qator uchun alohida funksiya chaqiruvi. np.select esa shartlar ro'yxatini vektor bilan tekshiradi — birinchi rost shart g'olib, hech biri rost bo'lmasa default. Natija bir xil, tezlik farqi esa juda katta — bu kitob qurilgan kompyuterda yuz barobardan ham ko'p (1-bobdagi sabab bilan). Qoida: avval vektor yo'lini qidiring; apply — boshqa iloj qolmaganda yoki jadval kichik bo'lganda.
Ustunlarni olib tashlash va nomini o'zgartirish
qisqa = (avto
         .drop(columns=["probeg_km", "kvartil", "taklif"])
         .rename(columns={"narx_mln": "narx (mln)", "viloyat": "hudud"}))
print(qisqa.columns.tolist())
['elon_id', 'sana', 'model', 'rang', 'yil', 'uzatma', 'hudud', 'narx', 'yoshi', 'narx (mln)', 'avtomat', 'segment', 'toifa']
drop(columns=[...]) — ustunlarni olib tashlaydi (axis=1 yozishdan aniqroq). rename — lug'at bilan nom almashtirish. Ikkalasi ham yangi jadval qaytaradi.
inplace yoki qayta tayinlash
Ko'p eski kodda shunday yozuvni ko'rasiz:
nusxa = avto.copy()
natija = nusxa.drop(columns=["toifa"], inplace=True)
print("inplace qaytardi:", natija, "| ustunlar soni:", nusxa.shape[1])
inplace qaytardi: None | ustunlar soni: 15
inplace=True jadvalni joyida o'zgartiradi va None qaytaradi. Shuning uchun df = df.drop(..., inplace=True) — klassik xato: df endi None. Zanjirda ham ishlamaydi. pandas jamoasi inplace ni tavsiya qilmaydi: tezlikda yutuq deyarli yo'q, xato esa ko'p. Bu kitobda doim qayta tayinlash: df = df.drop(...).
Tasodifiy namuna va index ni tiklash
namuna = avto.sample(frac=0.1, random_state=42)
print(namuna.shape, namuna.index[:5].tolist())
print(namuna.reset_index(drop=True).index[:5].tolist())
(60, 16) [110, 419, 565, 77, 181]
[0, 1, 2, 3, 4]
sample(frac=0.1) — tasodifiy 10% qator: katta jadvalda g'oyani tez sinash yoki o'qitish/test bo'lish uchun. random_state — 2-bobdagi seed: har safar bir xil namuna. Namunadan keyin index "sochilgan" (asl qator raqamlari) — reset_index(drop=True) uni 0, 1, 2... qiladi; drop=True eskisini ustun qilib qo'shmaslik uchun.
Natija: boyitilgan jadval rasmda
jadval = avto.pivot_table(index="segment", columns="toifa", values="elon_id", aggfunc="count", observed=False)
ax = jadval.plot(kind="barh", stacked=True, color=["#137333", "#f9ab00", "#c5221f"], figsize=(8, 3.4),
                 title="Segment va narx toifasi: e'lonlar soni")
ax.set_xlabel("e'lonlar soni")
plt.show()
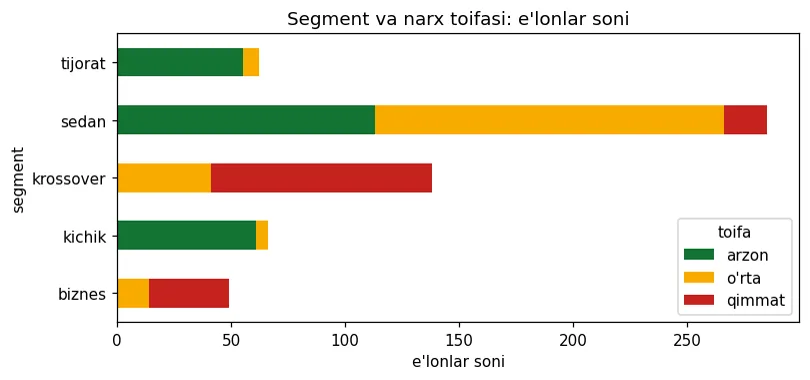
Ikki yangi ustun — segment (map dan) va toifa (cut dan) — birga bitta savolga javob beradi: kichik va tijorat mashinalari deyarli hammasi arzon toifada, krossoverlarning taxminan uchdan ikki qismi qimmat, qolgani o'rta. Sedanlar esa uchala toifaga ham tarqalgan: ko'pchiligi o'rta va arzon, oz qismi qimmat. pivot_table ni 14-bobda batafsil ochamiz.
Xulosa
- Method chaining —
read_csv(...).drop_duplicates().assign(...): butun tayyorlash bitta o'qiladigan retsept;assign(ustun=lambda d: ...). - Yangi ustun — vektor amal;
map— lug'at bilan (yo'q qiymat →NaN, tekshiring). cut— siz bergan chegaralar,qcut— teng sonli guruhlar.apply(axis=1)— o'qilishi oson, lekin sekin; vektor yo'l (np.select,np.where) — ko'p barobar tez.drop(columns=...),rename(columns={...}),sample(frac, random_state),reset_index(drop=True).inplace=TrueNoneqaytaradi — ishlatmang; qayta tayinlang.
Mashqlar
km_yiligaustunini qo'shing: probeg / yosh (yangi mashinalarda yosh 0 bo'lishi mumkin — nima qilasiz?).pd.cutbilan yoshni "yangi" (0–3), "o'rta" (4–8), "eski" (9+) toifalarga bo'ling va har toifa uchun narx medianini toping.takliffunksiyasininp.selectsiz, ikkitanp.wherebilan yozing.
Javoblar
avto["probeg_km"] / avto["yoshi"].replace(0, 1)— nolga bo'lishdan saqlanish (4-bob); yoki 0 yoshlilarni alohida ko'rib chiqing.pd.cut(avto["yoshi"], [-1, 3, 8, np.inf], labels=[...]), keyingroupby(...)["narx_mln"].median().np.where(premium_shart, "premium", np.where(avto["narx_mln"] < 150, "oddiy", "kafolat")).
Bu bobni bepul o'qidingiz.
Kitob o'rgatadi, lekin sizning kodingiz nega ishlamaganini ayta olmaydi. Kursda uy vazifangiz tekshiriladi.