Drift va qayta o'qitish: taksichini qachon o'qitish kerak
Grafik siljidi. Endi nima?
34-bobda bashorat taqsimotini o'lchadik. Model ishonchli edi: javoblarning ko'pi chekkalarda, o'rtada kam.
Bir oy o'tdi. Grafik o'zgardi — endi javoblar o'rtaga to'plana boshladi.
Monitoring o'z ishini qildi: u siljishni ko'rsatdi. Lekin u sizga nima qilishni aytmaydi.
Uch savol qoladi:
- Bu haqiqiy o'zgarishmi yoki tasodifmi?
- Nima o'zgardi — ma'lumotmi yoki dunyoning o'zimi?
- Qayta o'qitish yordam beradimi?
Uchinchisi eng muhim va eng ko'p noto'g'ri javob beriladi. Ko'pchilik "model eskirdi — qayta o'qitamiz" deydi. Ba'zan bu foydasiz.
Ikki xil drift
Farqni tushunish uchun taksichiga qaytamiz.
Birinchi holat. Shahar o'zgarmadi, lekin siz uni boshqa mahallalarga yubora boshladingiz. U eski hududni yaxshi biladi, yangisini bilmaydi.
Bu — ma'lumot drifti (data drift). Dunyo o'sha, lekin kiruvchi ma'lumot boshqa.
Yechim oddiy: unga yangi mahallalarni ko'rsating. Ya'ni qayta o'qitish yordam beradi.
Ikkinchi holat. Hudud o'sha, lekin ko'chalar o'zgardi — bir tomonlama bo'ldi, yangi yo'l ochildi.
Bu — tushuncha drifti (concept drift). Kirish bir xil, lekin to'g'ri javob o'zgardi.
Yechim ham qayta o'qitish, lekin yangi ma'lumot bilan — eski yozuvlar endi noto'g'ri javobni o'rgatadi.
import pandas as pd
show(pd.DataFrame([
    {"Turi": "Ma'lumot drifti", "Nima o'zgardi": "Kiruvchi ma'lumot taqsimoti",
     "Yorliqsiz seziladimi": "**Ha**", "Qayta o'qitish yordam beradimi": "Odatda ha"},
    {"Turi": "Tushuncha drifti", "Nima o'zgardi": "Kirish va javob orasidagi bog'liqlik",
     "Yorliqsiz seziladimi": "Qiyin", "Qayta o'qitish yordam beradimi": "Yangi yorliq kerak"},
    {"Turi": "Xususiyat buzilishi", "Nima o'zgardi": "Quvur (3, 6-bob)",
     "Yorliqsiz seziladimi": "Ha — keskin sakrash", "Qayta o'qitish yordam beradimi": "**Yo'q — tuzatish kerak**"},
]))
| Turi | Nima o'zgardi | Yorliqsiz seziladimi | Qayta o'qitish yordam beradimi |
|---|---|---|---|
| Ma'lumot drifti | Kiruvchi ma'lumot taqsimoti | **Ha** | Odatda ha |
| Tushuncha drifti | Kirish va javob orasidagi bog'liqlik | Qiyin | Yangi yorliq kerak |
| Xususiyat buzilishi | Quvur (3, 6-bob) | Ha — keskin sakrash | **Yo'q — tuzatish kerak** |
Uchinchi qatorga diqqat. Agar xususiyat quvuri buzilgan bo'lsa (3-bobdagi skew, 6-bobdagi buzuq ma'lumot), qayta o'qitish zarar keltiradi: siz buzuq ma'lumotni modelga o'rgatasiz.
Shuning uchun birinchi savol har doim: bu drift mi yoki nosozlikmi?
Yorliqsiz aniqlash
Eng katta qiyinchilik shu: ishlab chiqarishda to'g'ri javob yo'q (1-bob). Brokerni belgilaganingizdan keyin hech kim kelib "to'g'ri" yoki "xato" demaydi.
Demak F1 ni hisoblab bo'lmaydi. Nimani o'lchash mumkin?
Kirish taqsimotini. U yorliqsiz ham o'lchanadi.
Shu bobda haqiqiy drift bilan ishlaymiz — ijara_yangi.csv faylida brokerlar xulqini
o'zgartirgan.
python3 -c "
import pandas as pd
import numpy as np

eski = pd.read_csv('../datasets/ijara.csv')
yangi = pd.read_csv('../datasets/ijara_yangi.csv')
print(f'eski: {len(eski):,} qator | yangi: {len(yangi):,} qator')
print()
USTUN = ['tavsif_uzunligi','rasmlar_soni','telefon_takrorlanishi','kunlik_elonlar','narx_mln']
print(f'{\"ustun\":22s} {\"eski ort\":>10s} {\"yangi ort\":>10s} {\"farq %\":>9s}')
print('-' * 55)
for u in USTUN:
    a, b = eski[u].mean(), yangi[u].mean()
    print(f'{u:22s} {a:>10.2f} {b:>10.2f} {(b-a)/a*100:>8.1f}%')
"
eski: 12,000 qator | yangi: 4,000 qator

ustun                    eski ort  yangi ort    farq %
-------------------------------------------------------
tavsif_uzunligi            316.74     364.20     15.0%
rasmlar_soni                 7.20       8.22     14.2%
telefon_takrorlanishi        3.54       3.69      4.2%
kunlik_elonlar               2.34       2.45      4.9%
narx_mln                     5.72       5.67     -0.9%
Ba'zi ustunlar sezilarli o'zgargan. Lekin "o'rtacha o'zgardi" — bu hali dalil emas. Bizga raqam kerak: qanchalik o'zgardi va bu muhimmi?
PSI: siljish ko'rsatkichi
Eng keng tarqalgan o'lchov — PSI (Population Stability Index).
G'oyasi oddiy: ustunni oraliqlarga bo'lamiz va har oraliqda ulush qanchalik o'zgarganini hisoblaymiz.
shu faylni yaratingsrc/quvur/drift.py
"""Taqsimot siljishini o'lchash — yorliqsiz."""
import numpy as np
import pandas as pd

# sanoatda qabul qilingan chegaralar
KICHIK, KATTA = 0.10, 0.25


def psi(asos: pd.Series, yangi: pd.Series, paqir: int = 10) -> float:
    """Population Stability Index.

    < 0.10  - siljish yo'q
    < 0.25  - o'rtacha siljish, kuzating
    >= 0.25 - katta siljish, harakat kerak
    """
    chegara = np.quantile(asos, np.linspace(0, 1, paqir + 1))
    chegara[0], chegara[-1] = -np.inf, np.inf
    a, _ = np.histogram(asos, bins=chegara)
    b, _ = np.histogram(yangi, bins=chegara)
    # nol bo'lmasin - logarifm uchun
    a = np.clip(a / max(a.sum(), 1), 1e-6, None)
    b = np.clip(b / max(b.sum(), 1), 1e-6, None)
    return float(np.sum((b - a) * np.log(b / a)))


def baho(qiymat: float) -> str:
    if qiymat < KICHIK:
        return "barqaror"
    if qiymat < KATTA:
        return "o'rtacha"
    return "KATTA SILJISH"


def hisobot(asos: pd.DataFrame, yangi: pd.DataFrame,
            ustunlar: list[str]) -> pd.DataFrame:
    qatorlar = [
        {"ustun": u, "psi": round(psi(asos[u], yangi[u]), 4),
         "baho": baho(psi(asos[u], yangi[u]))}
        for u in ustunlar
    ]
    return pd.DataFrame(qatorlar).sort_values("psi", ascending=False)
python3 -c "
import sys; sys.path.insert(0, 'src')
import pandas as pd
from quvur.drift import hisobot

eski = pd.read_csv('../datasets/ijara.csv')
yangi = pd.read_csv('../datasets/ijara_yangi.csv')
USTUN = ['tavsif_uzunligi','rasmlar_soni','telefon_takrorlanishi','kunlik_elonlar',
         'narx_mln','maydon','xonalar','egasi_tasdiqlangan']
h = hisobot(eski, yangi, USTUN)
print(h.to_string(index=False))
"
                ustun    psi     baho
         rasmlar_soni 0.2251 o'rtacha
      tavsif_uzunligi 0.1262 o'rtacha
telefon_takrorlanishi 0.0089 barqaror
       kunlik_elonlar 0.0075 barqaror
             narx_mln 0.0046 barqaror
               maydon 0.0031 barqaror
              xonalar 0.0012 barqaror
   egasi_tasdiqlangan 0.0009 barqaror
Jadval qaysi ustun siljiganini aniq ko'rsatadi. Bu 34-bobdagi grafikdan ko'ra foydaliroq: grafik "nimadir o'zgardi" deydi, PSI esa nima o'zgarganini aytadi.
PSI chegaralari qonun emas
0.10 va 0.25 — sanoatda keng ishlatiladigan raqamlar, lekin ular hech qanday
teoremadan kelib chiqmaydi. Ular kredit skoring sohasidagi tajribadan olingan.
Sizning ma'lumotingizda ular noto'g'ri bo'lishi mumkin:
- Mavsumiy ma'lumotda (dekabr va iyul) PSI tabiiy ravishda yuqori bo'ladi — bu drift emas.
- Kichik namunada PSI shovqindan ham oshib ketadi.
To'g'ri yondashuv: bir necha oy davomida normal PSI ni o'lchang va o'z chegarangizni shunga qarab qo'ying. 12-bobdagi partition masalasi bilan bir xil qoida — taxmin qilmang, o'lchang.
Drift natijaga ta'sir qildimi
PSI kirish o'zgarganini ko'rsatdi. Lekin model yomonlashdimi?
Bu bobda bizda maxsus imkoniyat bor: sinov ma'lumotida yorliq bor, shuning uchun haqiqatni ko'rsatib bera olamiz. Ishlab chiqarishda bu bo'lmaydi.
python3 -c "
import sys; sys.path.insert(0, 'src')
import pandas as pd
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import f1_score, precision_score, recall_score
from sklearn.model_selection import train_test_split
from quvur.xususiyat import tayyorla

eski = pd.read_csv('../datasets/ijara.csv')
yangi = pd.read_csv('../datasets/ijara_yangi.csv')

x, y = tayyorla(eski), eski['broker']
Xtr, Xte, ytr, yte = train_test_split(x, y, test_size=0.25, stratify=y, random_state=42)
m = RandomForestClassifier(n_estimators=150, min_samples_leaf=3, random_state=42, n_jobs=1).fit(Xtr, ytr)

def baho(mod, X, Y):
    p = mod.predict(X)
    return f1_score(Y,p), precision_score(Y,p), recall_score(Y,p)

a = baho(m, Xte, yte)
b = baho(m, tayyorla(yangi), yangi['broker'])
print(f'{\"davr\":14s} {\"F1\":>8s} {\"aniqlik\":>9s} {\"toliqlik\":>9s}')
print('-' * 44)
print(f'{\"eski (sinov)\":14s} {a[0]:>8.3f} {a[1]:>9.3f} {a[2]:>9.3f}')
print(f'{\"yangi\":14s} {b[0]:>8.3f} {b[1]:>9.3f} {b[2]:>9.3f}')
print()
print(f'F1 tushishi: {a[0]-b[0]:.3f}')
"
davr                 F1   aniqlik  toliqlik
--------------------------------------------
eski (sinov)      0.860     0.893     0.828
yangi             0.664     0.883     0.533

F1 tushishi: 0.195
1-bobdagi raqam qaytdi. Va endi biz uning sababini bilamiz: PSI jadvalidagi siljigan ustunlar.
Diqqat: aniqlik deyarli o'zgarmadi, to'liqlik qulab tushdi. Ya'ni model "broker" deganda hali ham haq — lekin brokerlarning ko'pini ko'rmayapti.
Bu mantiqiy: brokerlar xulqini o'zgartirib, egalarga o'xshab qolishgan.
Qayta o'qitish yordam beradimi
Endi eng muhim savol. Yangi ma'lumotda qayta o'qitamiz va tekshiramiz.
python3 -c "
import sys; sys.path.insert(0, 'src')
import pandas as pd
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import f1_score
from sklearn.model_selection import train_test_split
from quvur.xususiyat import tayyorla

eski = pd.read_csv('../datasets/ijara.csv')
yangi = pd.read_csv('../datasets/ijara_yangi.csv')

Xy, yy = tayyorla(yangi), yangi['broker']
Xtr_y, Xte_y, ytr_y, yte_y = train_test_split(Xy, yy, test_size=0.25, stratify=yy, random_state=42)

# 1) ESKI model, yangi sinovda
xe, ye = tayyorla(eski), eski['broker']
Xtr_e, _, ytr_e, _ = train_test_split(xe, ye, test_size=0.25, stratify=ye, random_state=42)
eski_m = RandomForestClassifier(n_estimators=150, min_samples_leaf=3, random_state=42, n_jobs=1).fit(Xtr_e, ytr_e)
f_eski = f1_score(yte_y, eski_m.predict(Xte_y))

# 2) FAQAT yangi malumotda oqitilgan
yangi_m = RandomForestClassifier(n_estimators=150, min_samples_leaf=3, random_state=42, n_jobs=1).fit(Xtr_y, ytr_y)
f_yangi = f1_score(yte_y, yangi_m.predict(Xte_y))

# 3) IKKALASI birga
Xb = pd.concat([Xtr_e, Xtr_y]); yb = pd.concat([ytr_e, ytr_y])
birga_m = RandomForestClassifier(n_estimators=150, min_samples_leaf=3, random_state=42, n_jobs=1).fit(Xb, yb)
f_birga = f1_score(yte_y, birga_m.predict(Xte_y))

print('YANGI sinov toplamida F1:')
print(f'  eski model          : {f_eski:.3f}')
print(f'  faqat yangida oqitildi: {f_yangi:.3f}')
print(f'  ikkalasida oqitildi : {f_birga:.3f}')
print()
print(f'qayta oqitish foydasi: +{f_yangi-f_eski:.3f}')
"
YANGI sinov toplamida F1:
  eski model          : 0.632
  faqat yangida oqitildi: 0.822
  ikkalasida oqitildi : 0.774

qayta oqitish foydasi: +0.189
Qayta o'qitish yordam berdi — va bu ma'lumot drifti ekanini tasdiqlaydi. Agar tushuncha drifti bo'lganda, foyda ancha kam bo'lardi.
Uchinchi qatorga ham qarang: eski va yangi ma'lumotni birga ishlatish har doim ham eng yaxshi emas. Eski yozuvlar endi eskirgan bo'lsa, ular modelni orqaga tortadi.
Jadval bo'yicha qayta o'qitish — odat, strategiya emas
"Har hafta dushanba kuni qayta o'qitamiz" — keng tarqalgan yondashuv va u ikki tomondan noto'g'ri.
Kech qoladi. Chorshanba kuni manba buzilsa, siz olti kun yomon model bilan ishlaysiz.
Erta ham bo'ladi. Hech narsa o'zgarmagan bo'lsa, siz har hafta hisob-kitob qilasiz, yangi model chiqarasiz, xavf olasiz — hech qanday foyda uchun.
To'g'ri yondashuv — sabab bilan qayta o'qitish:
| Signal | Harakat |
|---|---|
| PSI > chegara | Tekshirish, keyin qayta o'qitish |
| Bashorat taqsimoti siljidi (34-bob) | Tekshirish |
| Yangi yorliq to'plandi | Qayta o'qitishga arziydi |
| Hech narsa o'zgarmadi | Tegmang |
Jadval faqat zaxira sifatida qoladi: "kamida oyiga bir marta, agar boshqa sabab bo'lmasa".
Avtomatik qayta o'qitish xavfi
Drift sezildi → quvur ishga tushdi → yangi model chiqdi. Chiroyli ko'rinadi.
Lekin 6 va 31-boblarni eslang: agar drift aslida buzilgan ma'lumot bo'lsa?
Unda siz buzuq ma'lumotda o'qitasiz va yomon modelni avtomatik chiqarasiz. Drift aniqlash tizimi endi zararga ishlayapti.
Shuning uchun avtomatik qayta o'qitishda uch to'siq bo'lishi shart:
- Ma'lumot sifati (6-bob) — kirish qoidaga mos bo'lsin;
- Sifat darvozasi (24, 31-bob) — yangi model chegaradan past bo'lmasin;
- Shadow yoki canary (33-bob) — to'g'ridan 100% ga chiqmasin.
Uchalasi bo'lsa, avtomatik qayta o'qitish xavfsiz. Bittasi yo'q bo'lsa — qo'lda tasdiqlash qoldiring.
To'liq halqa
diagramma(
    {
        "Ishlayotgan\nmodel": (0, 2.0, 2.2, 1.0, "xizmat"),
        "Monitoring\n(34-bob)": (3.0, 2.0, 2.2, 1.0, "kuzatuv"),
        "Drift\nsezildi": (6.0, 2.0, 2.0, 1.0, "kuzatuv"),
        "Sabab?\nsifat yoki drift": (8.8, 2.0, 2.4, 1.0, "qayta"),
        "Quvurni\ntuzatish": (11.9, 3.4, 2.1, 0.9, "manba"),
        "Qayta\no'qitish": (11.9, 0.7, 2.1, 0.9, "qayta"),
    },
    [
        ("Ishlayotgan\nmodel", "Monitoring\n(34-bob)"),
        ("Monitoring\n(34-bob)", "Drift\nsezildi"),
        ("Drift\nsezildi", "Sabab?\nsifat yoki drift"),
        ("Sabab?\nsifat yoki drift", "Quvurni\ntuzatish", "nosozlik"),
        ("Sabab?\nsifat yoki drift", "Qayta\no'qitish", "haqiqiy drift"),
    ],
    nom="drift_halqa.png", kenglik=15,
    izoh="Eng muhim tugun - o'rtadagi savol. Usiz drift har doim 'qayta o'qitish' deb javob oladi.",
)
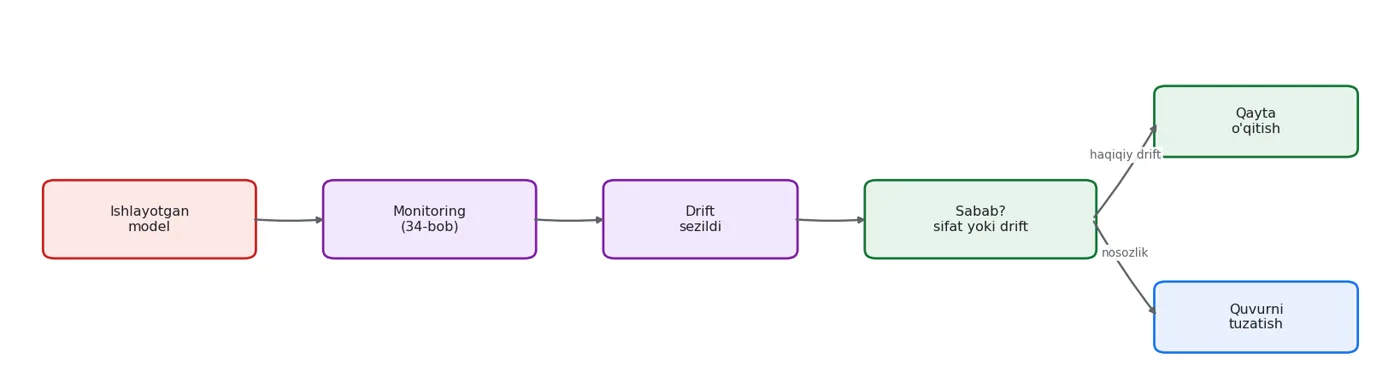
Eng muhim tugun - o'rtadagi savol. Usiz drift har doim 'qayta o'qitish' deb javob oladi.
Xulosa
| Tushuncha | Asosiy fikr |
|---|---|
| Monitoring siljishni ko'rsatadi | Lekin nima qilishni aytmaydi |
| Ma'lumot drifti | Kirish o'zgardi — qayta o'qitish yordam beradi |
| Tushuncha drifti | Bog'liqlik o'zgardi — yangi yorliq kerak |
| Xususiyat buzilishi | Qayta o'qitish zarar keltiradi — tuzatish kerak |
| Birinchi savol | "Drift mi yoki nosozlikmi?" |
| PSI | Yorliqsiz o'lchanadi; qaysi ustun siljiganini aytadi |
| PSI chegaralari | Qonun emas — o'z normangizni o'lchang |
| Jadval bo'yicha qayta o'qitish | Kech ham, erta ham bo'ladi |
| Sabab bilan qayta o'qitish | Signal bo'lsa — harakat; bo'lmasa — tegmang |
| Avtomatik qayta o'qitish | Faqat uch to'siq bilan: sifat, darvoza, canary |
Talaba ishi
ijara_yangi.csvdan tasodifiy 500 qator oling va PSI ni qayta hisoblang. Kichik namunada raqam qanday o'zgardi?psi()dapaqirni 5 va 20 qiling. Natija qanchalik barqaror?- Eski ma'lumotning faqat oxirgi yarmini yangisi bilan qo'shib o'qiting. Natija yaxshilandimi?
- Bashorat taqsimotining PSI sini hisoblang (34-bobdagi
model_ehtimol_taqsimoti). Kirish PSI sidan oldin yoki keyin siljidi? - Sizning loyihangizda tushuncha driftini qanday sezasiz? Qanday yorliq to'playsiz?
Bu bobni bepul o'qidingiz.
Kitob o'rgatadi, lekin sizning kodingiz nega ishlamaganini ayta olmaydi. Kursda uy vazifangiz tekshiriladi.