Loyiha tuzilishi: o'qitish va xizmat ikki xil hayot
Tikuvchi va fabrika
Kostyum buyurtma qildingiz.
Tikuvchi keldi, o'z santimetri bilan o'lchov oldi: yelka 46, bel 82, qo'l 64. Hammasini daftariga yozdi va fabrikaga yubordi.
Fabrikada esa boshqa santimetr ishlatiladi. U ham to'g'ri santimetr — faqat ozgina cho'zilgan, har metrda ikki foiz farq qiladi.
Ikki hafta o'tdi. Kostyum keldi. Kiyib ko'rdingiz — tor.
Endi aybdorni toping. Tikuvchi xato qildimi? Yo'q, u to'g'ri o'lchadi. Fabrika xato qildimi? Yo'q, u yozilgan raqam bo'yicha tikdi. Hech kim xato qilmadi, lekin kostyum kiyib bo'lmaydi.
Muammo o'lchovda emas, ikki xil santimetrda.
ML da bu har kuni sodir bo'ladi
Modelni o'qitayotganda siz xususiyatlarni bir marta hisoblaysiz — pandas bilan, katta
jadvalda, shoshilmasdan.
Xizmat ko'rsatayotganda esa o'sha xususiyatlarni boshqa kod hisoblaydi — bitta qator uchun, tezkor, ehtimol boshqa tilda.
Ikkalasi ham "to'g'ri" yozilgan. Lekin agar ular arzimagan narsada farq qilsa — o'lchov birligi, ustunlar tartibi, bo'sh qiymatni to'ldirish usuli — model noto'g'ri javob bera boshlaydi.
Va 1-bobni eslang: u bu haqda sizga aytmaydi.
Bu hodisaning nomi bor: training-serving skew (o'qitish va xizmat orasidagi siljish). Shu bobda uni o'z ko'zingiz bilan ko'rasiz va F1 ning qanchaga tushishini o'lchaysiz.
Ikki xil kod, ikki xil talab
ML loyihasida ikkita butunlay boshqa kod bor va ularni chalkashtirish eng qimmat xatolardan biri.
import pandas as pd
show(pd.DataFrame([
    {"jihat": "Qachon ishlaydi", "O'QITISH": "Haftada bir marta", "XIZMAT": "Soniyada yuz marta"},
    {"jihat": "Ma'lumot hajmi", "O'QITISH": "Millionlab qator", "XIZMAT": "Bitta qator"},
    {"jihat": "Tezlik talabi", "O'QITISH": "Soatlar bo'lsa ham mayli", "XIZMAT": "50 ms dan kam"},
    {"jihat": "Apparat", "O'QITISH": "GPU, ko'p xotira", "XIZMAT": "Arzon CPU yetadi"},
    {"jihat": "Yiqilsa", "O'QITISH": "Ertaga qayta chopamiz", "XIZMAT": "Mijoz zarar ko'radi"},
    {"jihat": "Kutubxonalar", "O'QITISH": "sklearn, pandas, matplotlib", "XIZMAT": "faqat kerakli minimum"},
]))
| jihat | O'QITISH | XIZMAT |
|---|---|---|
| Qachon ishlaydi | Haftada bir marta | Soniyada yuz marta |
| Ma'lumot hajmi | Millionlab qator | Bitta qator |
| Tezlik talabi | Soatlar bo'lsa ham mayli | 50 ms dan kam |
| Apparat | GPU, ko'p xotira | Arzon CPU yetadi |
| Yiqilsa | Ertaga qayta chopamiz | Mijoz zarar ko'radi |
| Kutubxonalar | sklearn, pandas, matplotlib | faqat kerakli minimum |
Ularni bitta faylga qo'ysangiz, xizmat konteyneriga matplotlib ham tushadi va image 1 GB bo'ladi.
Bundan yomoni — keyingi bo'limdagi xato yuz beradi.
Eng qimmat ML xatosi: o'qitish/xizmat nomuvofiqligi
Model o'qitilganda ma'lumot bir xil tayyorlanadi, xizmatda esa boshqacha. Model buni aytmaydi — u shunchaki yomonroq bashorat qiladi.
Ingliz tilida bu training/serving skew deyiladi. Eng keng tarqalgan ko'rinishi — ustunlar tartibi.
Sabab: sklearn modeliga numpy massiv berilsa, u ustun nomlariga qaramaydi — faqat
joylashuviga qaraydi. Xizmatda ma'lumot lug'atdan kelsa, tartib oson buziladi.
import numpy as np
import pandas as pd
from sklearn.ensemble import RandomForestClassifier
from sklearn.model_selection import train_test_split
from sklearn.metrics import f1_score

d = pd.read_csv(DATA / "ijara.csv")
XUS = ["xonalar", "maydon", "qavat", "jami_qavat", "narx_mln", "tavsif_uzunligi",
       "rasmlar_soni", "telefon_takrorlanishi", "kunlik_elonlar", "egasi_tasdiqlangan"]

Xtr, Xte, ytr, yte = train_test_split(d[XUS], d["broker"], test_size=0.25,
                                      stratify=d["broker"], random_state=42)
m = RandomForestClassifier(n_estimators=150, min_samples_leaf=3,
                           random_state=42, n_jobs=1).fit(Xtr, ytr)

# XIZMATDA: lug'atdan kelgan ma'lumot alifbo tartibida tuzilgan
alifbo = sorted(XUS)
print("o'qitish tartibi :", XUS[:4], "...")
print("xizmat tartibi   :", alifbo[:4], "...")

togri = f1_score(yte, m.predict(Xte[XUS]))
# .values bilan — nomlar yo'qoladi, faqat joylashuv qoladi
notogri = f1_score(yte, m.predict(Xte[alifbo].values))
print(f"\nto'g'ri tartib  : F1 = {togri:.3f}")
print(f"buzilgan tartib : F1 = {notogri:.3f}")
print(f"yo'qotish       : {togri - notogri:.3f}")
o'qitish tartibi : ['xonalar', 'maydon', 'qavat', 'jami_qavat'] ...
xizmat tartibi   : ['egasi_tasdiqlangan', 'jami_qavat', 'kunlik_elonlar', 'maydon'] ...

to'g'ri tartib  : F1 = 0.860
buzilgan tartib : F1 = 0.557
yo'qotish       : 0.304
F1 keskin tushdi.
Nima sodir bo'lganini aniq tasavvur qiling. Model o'qitilayotganda birinchi ustun xonalar soni edi — qiymatlar 1 dan 5 gacha. Ikkinchi ustun maydon edi — 30 dan 200 gacha.
Xizmatda esa ustunlar alifbo tartibida keldi. Endi birinchi ustunda egasi_tasdiqlangan
(0 yoki 1), ikkinchisida jami_qavat turibdi.
Model esa buni bilmaydi. U "birinchi ustun xonalar soni" deb o'rgangan va shunday deb o'qiyveradi. 9 qavatli binoni 9 xonali kvartira deb tushunadi.
Tikuvchi va fabrikani eslang: ikkala kod ham "to'g'ri" ishladi. Faqat o'lchov birligi kelishilmagan edi.
Va yana o'sha naqsh takrorlanadi: dastur yiqilmadi. Xato xabari yo'q. Model har so'rovga javob qaytaradi, ishonch bilan. Faqat javoblar bema'ni.
Bu xato test muhitida ko'rinmaydi
Eng yomon tomoni shu. Siz modelni sinab ko'rasiz — pytest yozasiz, u DataFrame beradi,
hammasi ishlaydi.
Chunki testni siz yozasiz va siz ustunlarni to'g'ri tartibda berasiz. Xato esa xizmat kodida, JSON dan lug'at yasalgan joyda tug'iladi — va u yerda tartib tasodifiy.
Shuning uchun bu xatoni faqat bir xil kodni ikkala tomonda ishlatish hal qiladi. Buni quyida quramiz.
Nega DataFrame bilan berilganda xato chiqmadi? Chunki sklearn DataFrame da ustun nomlarini
tekshiradi. .values esa nomlarni tashlab yuboradi:
try:
    m.predict(Xte[alifbo])            # DataFrame — nomlar bor
except Exception as e:
    print("DataFrame bilan:", type(e).__name__)
    print(" ", str(e).split("\n")[0][:110])
DataFrame bilan: ValueError
  The feature names should match those that were passed during fit.
Mana asosiy saboq: sklearn sizni ogohlantirishga harakat qildi, lekin .values yozilishi
bilanoq himoya yo'qoldi.
Va bu xatoning eng xavfli tomoni — uning jimligi:
- dastur yiqilmadi
- xato xabari yo'q
- kodni sinaydigan testlar o'tadi
- model hali ham javob qaytaradi, faqat javob noto'g'ri
Shuning uchun bunday xato oylab sezilmasligi mumkin — kimdir metrikaga qarab "model nega yomonlashdi?" deb so'ramaguncha.
Yechim: tayyorlash kodi bitta bo'lsin
Tikuvchi hikoyasiga qayting. Kostyum tor chiqmasligi uchun nima qilish kerak edi?
Javob oddiy: ikkalasi bitta santimetrdan foydalansin.
Tikuvchi o'lchaydi, fabrika tikadi — lekin o'lchov asbobi bitta bo'lsin. Unda u cho'zilgan bo'lsa ham muhim emas: ikkalasi bir xil xato qiladi, kostyum joyida bo'ladi.
Dasturda ham xuddi shunday. Qoida: ma'lumotni tayyorlaydigan kod bitta joyda yozilsin va ikkala tomon ham o'shani chaqirsin.
Diqqat qiling, bu "kodni ehtiyotkorlik bilan nusxalang" degani emas. Nusxa olish — muammoning o'zi. Ikki nusxa bugun bir xil, lekin olti oydan keyin kimdir bittasini o'zgartiradi va ikkinchisini unutadi.
Yagona ishonchli yechim — nusxa bo'lmasligi.
diagramma(
    {
        "Xom ma'lumot\n(CSV / API / oqim)": (0, 1.2, 2.6, 1.1, "manba"),
        "xususiyat.py\n(BITTA tayyorlash kodi)": (3.4, 1.2, 2.8, 1.1, "qayta"),
        "O'qitish\n(haftada bir)": (7.2, 0, 2.4, 1.1, "qayta"),
        "Xizmat\n(soniyada yuz)": (7.2, 2.4, 2.4, 1.1, "xizmat"),
    },
    [
        ("Xom ma'lumot\n(CSV / API / oqim)", "xususiyat.py\n(BITTA tayyorlash kodi)"),
        ("xususiyat.py\n(BITTA tayyorlash kodi)", "O'qitish\n(haftada bir)"),
        ("xususiyat.py\n(BITTA tayyorlash kodi)", "Xizmat\n(soniyada yuz)"),
    ],
    nom="bitta_tayyorlash.png", kenglik=12,
    izoh="Tayyorlash kodi bitta. O'qitish ham, xizmat ham o'shani chaqiradi — nomuvofiqlik imkonsiz bo'ladi.",
)
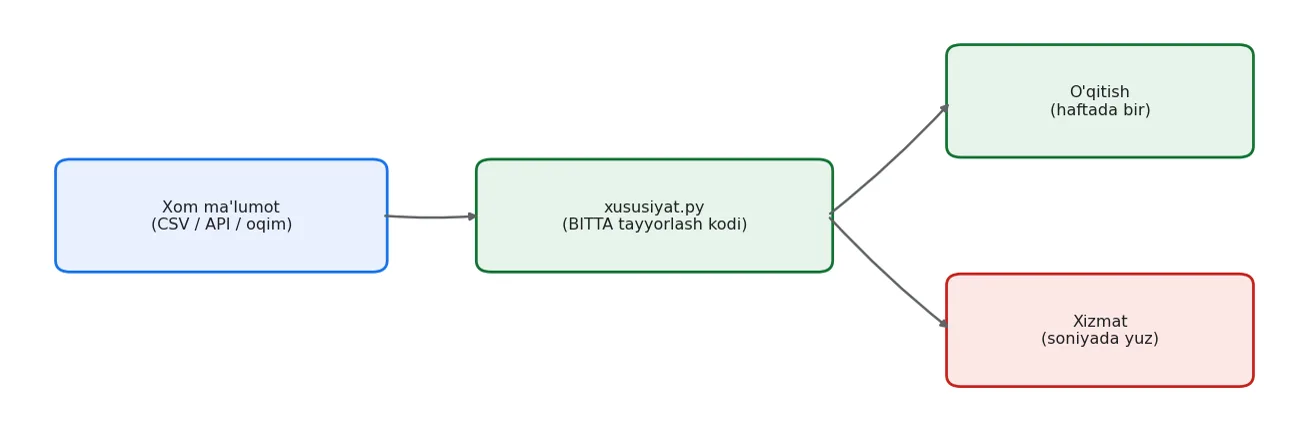
Tayyorlash kodi bitta. O'qitish ham, xizmat ham o'shani chaqiradi — nomuvofiqlik imkonsiz bo'ladi.
Amalda buni yozamiz:
shu faylni yaratingsrc/quvur/xususiyat.py
"""Xususiyat tayyorlash — O'QITISH va XIZMAT uchun BITTA manba.

Bu fayl ikkala tomondan ham chaqiriladi. Uni ikki joyga nusxalash —
o'qitish/xizmat nomuvofiqligining birinchi sababi.
"""
import pandas as pd

XOM_USTUNLAR = ["xonalar", "maydon", "qavat", "jami_qavat", "narx_mln", "tavsif_uzunligi",
                "rasmlar_soni", "telefon_takrorlanishi", "kunlik_elonlar", "egasi_tasdiqlangan"]

# model kutadigan ustunlar, ANIQ shu tartibda
XUSUSIYATLAR = [*XOM_USTUNLAR, "narx_m2", "qavat_nisbati", "rasm_tavsif"]


def tayyorla(df: pd.DataFrame) -> pd.DataFrame:
    """Xom qatorlardan model kutadigan xususiyatlarni yasaydi."""
    x = df[XOM_USTUNLAR].copy()
    x["narx_m2"] = x["narx_mln"] * 1000 / x["maydon"]
    x["qavat_nisbati"] = x["qavat"] / x["jami_qavat"]
    x["rasm_tavsif"] = x["rasmlar_soni"] / (x["tavsif_uzunligi"] / 100).clip(lower=0.3)
    return x[XUSUSIYATLAR]                      # tartib kafolatlangan


def bitta_qator(xom: dict) -> pd.DataFrame:
    """Xizmat uchun: bitta lug'atdan bitta qatorli DataFrame."""
    return tayyorla(pd.DataFrame([xom]))
python3 -c "
import sys; sys.path.insert(0, 'src')
import pandas as pd
from quvur.xususiyat import tayyorla, bitta_qator, XUSUSIYATLAR

d = pd.read_csv('../datasets/ijara.csv')
koplab = tayyorla(d.head(3))
yakka = bitta_qator(d.iloc[0].to_dict())

print('xususiyatlar:', XUSUSIYATLAR)
print()
print('ko\'plab (3 qator) birinchi qatori:')
print(koplab.iloc[0].round(4).to_dict())
print()
print('yakka qator (xizmat yo\'li):')
print(yakka.iloc[0].round(4).to_dict())
print()
print('IKKALASI BIR XILMI:', koplab.iloc[0].round(9).equals(yakka.iloc[0].round(9)))
"
xususiyatlar: ['xonalar', 'maydon', 'qavat', 'jami_qavat', 'narx_mln', 'tavsif_uzunligi', 'rasmlar_soni', 'telefon_takrorlanishi', 'kunlik_elonlar', 'egasi_tasdiqlangan', 'narx_m2', 'qavat_nisbati', 'rasm_tavsif']

ko'plab (3 qator) birinchi qatori:
{'xonalar': 4.0, 'maydon': 99.4, 'qavat': 3.0, 'jami_qavat': 4.0, 'narx_mln': 11.47, 'tavsif_uzunligi': 189.0, 'rasmlar_soni': 11.0, 'telefon_takrorlanishi': 2.0, 'kunlik_elonlar': 1.0, 'egasi_tasdiqlangan': 0.0, 'narx_m2': 115.3924, 'qavat_nisbati': 0.75, 'rasm_tavsif': 5.8201}

yakka qator (xizmat yo'li):
{'xonalar': 4.0, 'maydon': 99.4, 'qavat': 3.0, 'jami_qavat': 4.0, 'narx_mln': 11.47, 'tavsif_uzunligi': 189.0, 'rasmlar_soni': 11.0, 'telefon_takrorlanishi': 2.0, 'kunlik_elonlar': 1.0, 'egasi_tasdiqlangan': 0.0, 'narx_m2': 115.3924, 'qavat_nisbati': 0.75, 'rasm_tavsif': 5.8201}

IKKALASI BIR XILMI: True
Oxirgi qator — bu test. U o'qitish yo'li (ko'p qator) va xizmat yo'li (bitta qator) bir xil
natija berishini tekshiradi. 25-bobda buni pytest ga o'tkazamiz; hozir esa asosiy fikr:
bu tenglikni tekshirish mumkin, demak uni tekshirish kerak.
Loyiha papkalari
diagramma(
    {
        "src/quvur/\n(umumiy kod)": (0, 0, 2.6, 1.0, "qayta"),
        "src/oqitish/\n(faqat o'qitish)": (0, 1.6, 2.6, 1.0, "manba"),
        "src/xizmat/\n(faqat xizmat)": (0, 3.2, 2.6, 1.0, "xizmat"),
        "konfiguratsiya/\n(YAML, .env)": (3.6, 0.8, 2.4, 1.0, "saqlash"),
        "modellar/\n(artefaktlar)": (3.6, 2.4, 2.4, 1.0, "saqlash"),
        "tests/": (6.8, 0.8, 2.0, 1.0, "qayta"),
        "Dockerfile\n(xizmat uchun)": (6.8, 2.4, 2.0, 1.0, "xizmat"),
    },
    [
        ("src/quvur/\n(umumiy kod)", "src/oqitish/\n(faqat o'qitish)"),
        ("src/quvur/\n(umumiy kod)", "src/xizmat/\n(faqat xizmat)"),
        ("konfiguratsiya/\n(YAML, .env)", "modellar/\n(artefaktlar)"),
    ],
    nom="papkalar.png", kenglik=12,
    izoh="quvur/ ikkala tomon ishlatadigan kod. oqitish/ va xizmat/ bir-birini import qilmaydi.",
)
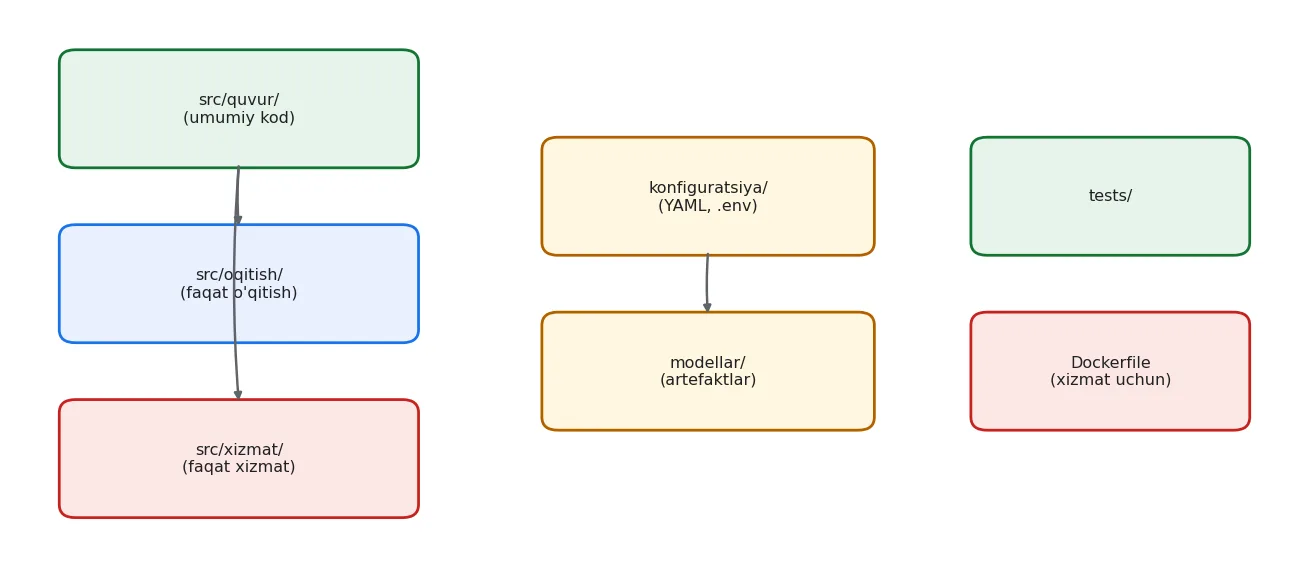
quvur/ ikkala tomon ishlatadigan kod. oqitish/ va xizmat/ bir-birini import qilmaydi.
Qat'iy qoida: oqitish/ va xizmat/ bir-birini import qilmaydi. Umumiy narsa bo'lsa, u
quvur/ ga chiqadi. Shu qoida xizmat konteyneriga matplotlib tushib qolishining oldini oladi.
mkdir -p src/oqitish src/xizmat konfiguratsiya modellar tests
touch src/quvur/__init__.py src/oqitish/__init__.py src/xizmat/__init__.py
find src konfiguratsiya modellar tests -type f -o -type d | sort | head -20
konfiguratsiya
modellar
src
src/oqitish
src/oqitish/__init__.py
src/quvur
src/quvur/__init__.py
src/quvur/__pycache__
src/quvur/__pycache__/xususiyat.cpython-310.pyc
src/quvur/pasport.py
src/quvur/takrorlanish.py
src/quvur/xususiyat.py
src/xizmat
src/xizmat/__init__.py
tests
Konfiguratsiya koddan tashqarida
O'qitish parametrlari kodda yozilgan bo'lsa, har o'zgartirishda kodga tegish kerak — va git tarixi "n_estimators ni 100 dan 150 ga o'zgartirdim" degan commitlar bilan to'ladi.
shu faylni yaratingkonfiguratsiya/oqitish.yaml
# O'qitish sozlamalari. Kodga tegmasdan o'zgartiriladi.
seed: 42

malumot:
  yol: "../datasets/ijara.csv"
  test_ulushi: 0.25
  nishon: "broker"

model:
  turi: "random_forest"
  parametrlar:
    n_estimators: 150
    min_samples_leaf: 3
    class_weight: null

sifat:
  # CI shu chegaralarni tekshiradi (31-bob)
  eng_kam_f1: 0.80
  eng_kam_toliqlik: 0.75
shu faylni yaratingsrc/quvur/sozlama.py
"""YAML konfiguratsiyani o'qish va tekshirish."""
from dataclasses import dataclass
from pathlib import Path
from typing import Any


@dataclass(frozen=True, slots=True)
class Sozlama:
    seed: int
    malumot: dict[str, Any]
    model: dict[str, Any]
    sifat: dict[str, float]

    @classmethod
    def yukla(cls, yol: str | Path) -> "Sozlama":
        matn = Path(yol).read_text(encoding="utf-8")
        xom = _oddiy_yaml(matn)
        s = cls(seed=int(xom["seed"]), malumot=xom["malumot"],
                model=xom["model"], sifat=xom["sifat"])
        s.tekshir()
        return s

    def tekshir(self) -> None:
        """Noto'g'ri sozlama bilan o'qitish BOSHLANMASIN."""
        t = self.malumot.get("test_ulushi", 0)
        if not 0 < float(t) < 1:
            raise ValueError(f"test_ulushi 0 va 1 orasida bo'lishi kerak, berilgan: {t}")
        if not Path(self.malumot["yol"]).exists():
            raise FileNotFoundError(f"ma'lumot topilmadi: {self.malumot['yol']}")
        for kalit, qiymat in self.sifat.items():
            if not 0 <= float(qiymat) <= 1:
                raise ValueError(f"sifat.{kalit} 0..1 oralig'ida bo'lishi kerak: {qiymat}")


def _oddiy_yaml(matn: str) -> dict[str, Any]:
    """Minimal YAML o'qigich (PyYAML bo'lmasa ham ishlaydi).

    Faqat shu kitobdagi tuzilish uchun: ikki daraja, oddiy qiymatlar.
    Haqiqiy loyihada `pyyaml` ishlating.
    """
    try:
        import yaml
        return yaml.safe_load(matn)
    except ImportError:
        pass
    natija: dict[str, Any] = {}
    stek: list[tuple[int, dict[str, Any]]] = [(-1, natija)]
    for xom in matn.splitlines():
        if not xom.strip() or xom.strip().startswith("#"):
            continue
        chuqurlik = len(xom) - len(xom.lstrip())
        kalit, _, qiymat = xom.strip().partition(":")
        qiymat = qiymat.split("#")[0].strip().strip('"\'')
        while stek and stek[-1][0] >= chuqurlik:
            stek.pop()
        ota = stek[-1][1]
        if qiymat == "":
            yangi: dict[str, Any] = {}
            ota[kalit.strip()] = yangi
            stek.append((chuqurlik, yangi))
        else:
            ota[kalit.strip()] = _qiymat(qiymat)
    return natija


def _qiymat(x: str) -> Any:
    if x in {"null", "~", "None"}:
        return None
    if x in {"true", "false"}:
        return x == "true"
    try:
        return int(x)
    except ValueError:
        pass
    try:
        return float(x)
    except ValueError:
        return x
python3 -c "
import sys; sys.path.insert(0, 'src')
from quvur.sozlama import Sozlama
s = Sozlama.yukla('konfiguratsiya/oqitish.yaml')
print('seed        :', s.seed)
print('model       :', s.model['turi'], s.model['parametrlar'])
print('test ulushi :', s.malumot['test_ulushi'])
print('F1 chegarasi:', s.sifat['eng_kam_f1'])
"
seed        : 42
model       : random_forest {'n_estimators': 150, 'min_samples_leaf': 3, 'class_weight': None}
test ulushi : 0.25
F1 chegarasi: 0.8
Noto'g'ri sozlama bilan nima bo'lishini ham ko'ramiz — o'qitish boshlanmasligi kerak:
python3 -c "
import sys; sys.path.insert(0, 'src')
from quvur.sozlama import Sozlama
from pathlib import Path

xom = Path('konfiguratsiya/oqitish.yaml').read_text(encoding='utf-8')
buzuq = xom.replace('test_ulushi: 0.25', 'test_ulushi: 1.5')
Path('buzuq.yaml').write_text(buzuq, encoding='utf-8')
try:
    Sozlama.yukla('buzuq.yaml')
except ValueError as e:
    print('XATO (yaxshi):', e)
Path('buzuq.yaml').unlink()
"
XATO (yaxshi): test_ulushi 0 va 1 orasida bo'lishi kerak, berilgan: 1.5
Bu 11-bobdagi erta yiqilish qoidasining ML dagi ko'rinishi: uch soatlik o'qitish boshlanib, oxirida "test_ulushi noto'g'ri" deb yiqilsa — uch soat behuda ketadi.
Nima konfiguratsiyaga, nima kodga
Konfiguratsiyaga: o'zgarishi mumkin bo'lgan sonlar — parametrlar, yo'llar, chegaralar, seed.
Kodga: mantiq — xususiyat qanday hisoblanishi, qaysi model sinfi ishlatilishi.
Chegara sinovi: "buni o'zgartirganda kodni qayta sinash kerakmi?" Ha bo'lsa — kodda qolsin.
Xulosa
| Tushuncha | Asosiy fikr |
|---|---|
| Ikki hayot | O'qitish haftada bir, xizmat soniyada yuz marta — talablar boshqa |
| Nomuvofiqlik | Ustun tartibi buzilsa F1 keskin tushadi, dastur esa yiqilmaydi |
.values xavfi |
DataFrame da sklearn nomlarni tekshiradi; .values bu himoyani o'chiradi |
| Bitta tayyorlash | xususiyat.py ikkala tomondan chaqiriladi |
| Tenglik testi | Ko'p qator yo'li = bitta qator yo'li — buni tekshirish mumkin |
| Import qoidasi | oqitish/ va xizmat/ bir-birini import qilmaydi |
| Konfiguratsiya | Sonlar YAML da, mantiq kodda |
| Erta yiqilish | Noto'g'ri sozlama bilan uch soatlik o'qitish boshlanmasin |
Talaba ishi
tayyorlaga yangi xususiyat qo'shing (masalannarx_bozordan_farqi).XUSUSIYATLARro'yxatini yangilashni unutsangiz nima bo'ladi?bitta_qatorga ustuni yetishmayotgan lug'at bering. Qanday xato chiqadi va u tushunarlimi? Tushunarli qiling.- Yuqoridagi nomuvofiqlik tajribasini boshqa xato bilan takrorlang:
qavat_nisbatini teskari hisoblang (jami_qavat / qavat). F1 qanchaga tushadi? Sozlama.tekshir()ga yangi qoida qo'shing:n_estimators10 dan kichik bo'lmasin.
Bu bobni bepul o'qidingiz.
Kitob o'rgatadi, lekin sizning kodingiz nega ishlamaganini ayta olmaydi. Kursda uy vazifangiz tekshiriladi.