Apache Iceberg: jadval formati
Yuz qutili ombor va yo'qolgan ro'yxat
Yangi omborga kirdingiz. Ichkarida yuzta quti terib qo'yilgan. Har qutida hujjatlar bor.
Sizga vazifa berishdi: "Ushbu ombordagi barcha hujjatlarni sanab chiqing".
Oddiy ish, shunday emasmi? Lekin eshikda turib savol berasiz:
— Yuz qutining hammasi shu omborniki-mi?
Ombor mudiri yelka qisadi: — Bilmadim. Anavi burchakdagi o'nta qutini kecha kechqurun kimdir keltirgan edi, hali ro'yxatga kiritilmagan. Yana beshtasini olib chiqib ketmoqchi edilar, yarmi shu yerda qoldi.
Endi ishingiz imkonsiz. Siz qutilarni ko'ryapsiz, lekin qaysilari haqiqatan jadvalga kirishini bilmaysiz.
Parquet bor edi-ku, yana nima kerak
Aynan shu holat ombordagi ma'lumot bilan sodir bo'ladi.
4-bobda Parquet ni ko'rdik va u CSV dan har jihatdan ustun chiqdi. Lekin Parquet — bu bitta qutining formati. U qutining ichi qanday terilishini belgilaydi, xolos.
Ombordagi jadval esa ko'p qutidan iborat:
ombor/elon/
  2026-09-01.parquet
  2026-09-02.parquet
  ...
Parquet bu yerda hech narsa deya olmaydi. Natijada oddiy savollarga javob yo'q:
- Qaysi fayllar jadvalning hozirgi holati? (Yarim yozilgani ham turibdi)
- Kecha soat 10 da jadval qanday edi?
- Bir ustun qo'shsam, eski fayllar nima bo'ladi?
- Men o'qiyotganda kimdir yozsa, nima ko'raman?
Oxirgisi eng xavflisi. Tasavvur qiling: kechki yuklama 40 ta fayldan 23 tasini yozib ulgurdi, shu payt sizning hisobotingiz ishga tushdi. Siz yarim ma'lumotni o'qiysiz va hisobot chiqadi — xato, lekin xato ekani bilinmaydi.
Yechim omborda ham, ma'lumotda ham bitta: ro'yxat kerak. Eshikda osig'liq turgan, "bu omborga hozir aynan mana bu 90 ta quti kiradi" deb yozilgan qog'oz.
Iceberg — o'sha ro'yxat. U fayllarni o'zgartirmaydi (ichida baribir Parquet), lekin ularning ustiga metama'lumot qatlami qo'yadi.
diagramma(
    {
        "Katalog\n(jadval -> metadata)": (0, 1.6, 2.6, 1.1, "qayta"),
        "Metadata\n(sxema, snapshotlar)": (3.4, 1.6, 2.6, 1.1, "qayta"),
        "Manifest\n(qaysi fayllar)": (6.8, 1.6, 2.4, 1.1, "saqlash"),
        "data-1.parquet": (10.0, 3.0, 2.2, 0.9, "manba"),
        "data-2.parquet": (10.0, 1.7, 2.2, 0.9, "manba"),
        "data-3.parquet": (10.0, 0.4, 2.2, 0.9, "manba"),
    },
    [
        ("Katalog\n(jadval -> metadata)", "Metadata\n(sxema, snapshotlar)"),
        ("Metadata\n(sxema, snapshotlar)", "Manifest\n(qaysi fayllar)"),
        ("Manifest\n(qaysi fayllar)", "data-1.parquet"),
        ("Manifest\n(qaysi fayllar)", "data-2.parquet"),
        ("Manifest\n(qaysi fayllar)", "data-3.parquet"),
    ],
    nom="iceberg_qatlam.png", kenglik=14,
    izoh="Ma'lumot baribir Parquet. Iceberg ustiga uch qatlam metama'lumot qo'yadi.",
)
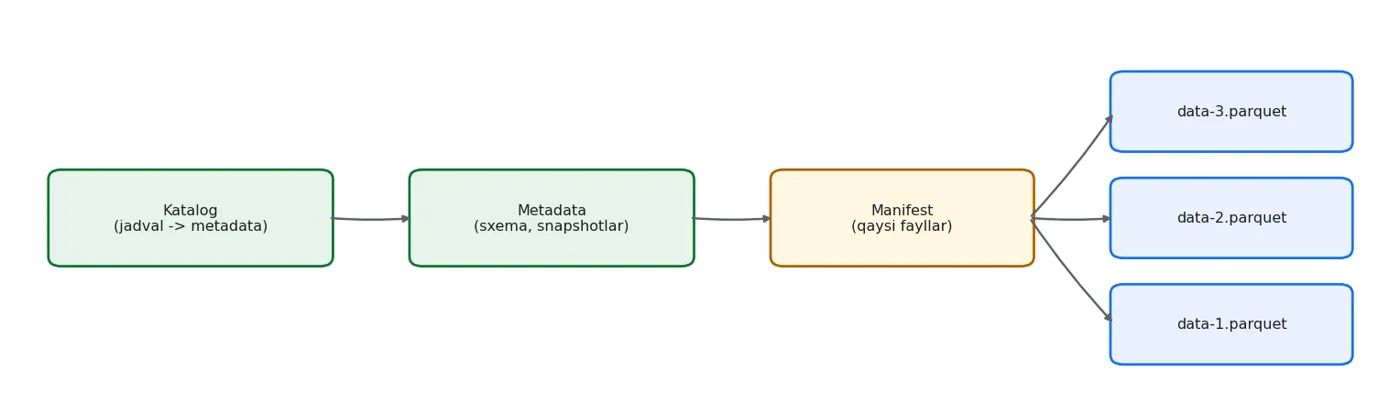
Ma'lumot baribir Parquet. Iceberg ustiga uch qatlam metama'lumot qo'yadi.
Katalog va birinchi jadval
Rasmda uch qatlam bor va ular bir-biriga o'xshash ko'rinadi. Farqni aniq qo'yaylik, chunki keyingi kodning har qatori shularga tegishli.
Omborga qaytamiz. Eshikda ro'yxat osig'liq turibdi — lekin ombor bitta emas, o'nta. Shuning uchun uch daraja kerak:
Katalog — binoning kiraverishidagi taxta: "1-ombor — bu yerda, 2-ombor — u yerda". U jadval nomini uning hozirgi ro'yxati turgan joyga bog'laydi. Boshqa hech narsa qilmaydi.
Metadata — omborning pasporti: qanday qutilar bo'lishi kerak (sxema), qachon nima o'zgargan (snapshotlar tarixi).
Manifest — bugungi ro'yxat: "hozir shu omborda aynan mana bu 90 ta quti bor".
Nega uchta, bitta emas? Chunki ular har xil tezlikda o'zgaradi. Har yozuvda yangi manifest yoziladi, lekin katalogdagi taxtaga faqat bitta strelka ko'chiriladi. Bu ko'chirish atomik — ya'ni bir zumda bo'ladi, yarim holat yo'q.
Aynan shuning uchun siz o'qiyotganda kimdir yozsa, siz eski ro'yxatni to'liq ko'rasiz. Yarim yozilgan holat sizga hech qachon ko'rinmaydi.
Bu bobda pyiceberg va SQLite katalogi ishlatiladi — Spark shart emas. Ishlab chiqarishda
katalog Nessie, Glue yoki REST bo'ladi, lekin mexanizm aynan shu.
shu faylni yaratingsrc/quvur/muz.py
"""Iceberg katalogi bilan ishlash. SQLite katalogi — mahalliy, lekin haqiqiy."""
from pathlib import Path

from pyiceberg.catalog.sql import SqlCatalog

OMBOR = Path("ombor")


def katalog(nom: str = "kitob") -> SqlCatalog:
    """Mahalliy katalog ochadi. Papkalar yo'q bo'lsa yaratiladi."""
    OMBOR.mkdir(parents=True, exist_ok=True)
    return SqlCatalog(
        nom,
        uri=f"sqlite:///{OMBOR.absolute()}/katalog.db",
        warehouse=f"file://{OMBOR.absolute()}",
    )


def snapshotlar(jadval) -> list[tuple[int, int]]:
    """(snapshot_id, qatorlar soni) ro'yxati — eskisidan yangisiga."""
    return [
        (s.snapshot_id, int(s.summary.get("total-records", 0)))
        for s in jadval.metadata.snapshots
    ]
python3 -c "
import sys, shutil, pathlib; sys.path.insert(0, 'src')
shutil.rmtree('ombor', ignore_errors=True)
import pandas as pd, pyarrow as pa
from quvur.muz import katalog

USTUN = ['elon_id','tuman','narx_mln','xonalar','tavsif_uzunligi','broker']
d = pd.read_csv('../datasets/ijara.csv').drop_duplicates('elon_id')
print(f'manba: {len(d):,} e\\'lon')

c = katalog()
c.create_namespace_if_not_exists('rostuy')
birinchi = pa.Table.from_pandas(d.head(5000)[USTUN], preserve_index=False)
t = c.create_table('rostuy.elon', schema=birinchi.schema)
t.append(birinchi)
print(f'jadval yaratildi, qatorlar: {len(t.scan().to_arrow()):,}')
print(f'sxema: {[f.name for f in t.schema().fields]}')
"
manba: 11,906 e'lon
jadval yaratildi, qatorlar: 5,000
sxema: ['elon_id', 'tuman', 'narx_mln', 'xonalar', 'tavsif_uzunligi', 'broker']
Time travel
Endi qo'shimcha ma'lumot yozamiz — xuddi ertasi kungi yuklama kabi.
python3 -c "
import sys; sys.path.insert(0, 'src')
import pandas as pd, pyarrow as pa
from quvur.muz import katalog, snapshotlar

USTUN = ['elon_id','tuman','narx_mln','xonalar','tavsif_uzunligi','broker']
d = pd.read_csv('../datasets/ijara.csv').drop_duplicates('elon_id')
c = katalog()
t = c.load_table('rostuy.elon')

t.append(pa.Table.from_pandas(d.iloc[5000:8000][USTUN], preserve_index=False))
t.append(pa.Table.from_pandas(d.iloc[8000:9500][USTUN], preserve_index=False))

print('SNAPSHOTLAR:')
for i, (sid, n) in enumerate(snapshotlar(t), 1):
    print(f'  {i}. id={sid}  qatorlar={n:,}')
print()
print(f'hozirgi holat: {len(t.scan().to_arrow()):,} qator')
"
SNAPSHOTLAR:
  1. id=7704632210919785281  qatorlar=5,000
  2. id=1527245768806091963  qatorlar=8,000
  3. id=6037738912449442596  qatorlar=9,500

hozirgi holat: 9,500 qator
Har append yangi snapshot yaratdi.
Snapshot — bu eshikdagi ro'yxatning o'sha kungi nusxasi. Yangi qutilar kelganda eski ro'yxat yirtib tashlanmaydi; yangisi yoziladi va eskisi papkaga tikiladi.
Shuning uchun "kecha ombor qanday edi?" degan savolga javob bor: eski ro'yxatni olasiz va unda yozilgan qutilarni sanaysiz. Qutilar hali joyida.
python3 -c "
import sys; sys.path.insert(0, 'src')
from quvur.muz import katalog, snapshotlar

c = katalog()
t = c.load_table('rostuy.elon')
snaps = snapshotlar(t)

print('O\\'TMISHGA SAYOHAT:')
for i, (sid, _) in enumerate(snaps, 1):
    ark = t.scan(snapshot_id=sid).to_arrow()
    d = ark.to_pandas()
    print(f'  {i}-snapshot: {len(ark):>6,} qator, broker ulushi {d[\"broker\"].mean():.3f}')
"
O'TMISHGA SAYOHAT:
  1-snapshot:  5,000 qator, broker ulushi 0.366
  2-snapshot:  8,000 qator, broker ulushi 0.358
  3-snapshot:  9,500 qator, broker ulushi 0.355
Mana nega bu MLOps uchun muhim. 5-bobda ma'lumot versiyasini qo'lda manifest bilan yuritgandik. Iceberg buni jadvalning o'ziga qurib qo'ygan: model pasportiga snapshot id ni yozib qo'ysangiz, olti oydan keyin aynan o'sha ma'lumotni qayta o'qiy olasiz.
Snapshot id — eng arzon ma'lumot versiyasi
24-bobdagi o'qitish quvurini eslang: u ma'lumot xeshini hisoblaydi. Iceberg bilan bu bepul
bo'ladi — t.current_snapshot().snapshot_id ni pasportga yozasiz, tamom.
Qayta o'qitish kerak bo'lsa scan(snapshot_id=...) — nusxa ko'chirish ham, saqlash ham shart
emas.
Sxema evolyutsiyasi
Yangi ustun qo'shish kerak bo'ldi. Parquet fayllar to'plamida bu og'riqli: eski fayllarda u ustun yo'q.
python3 -c "
import sys; sys.path.insert(0, 'src')
import pandas as pd, pyarrow as pa
from pyiceberg.types import LongType
from quvur.muz import katalog

c = katalog()
t = c.load_table('rostuy.elon')
print('ESKI sxema:', [f.name for f in t.schema().fields])

with t.update_schema() as u:
    u.add_column('rasmlar_soni', LongType(), 'E\\'londagi rasmlar soni')
t = c.load_table('rostuy.elon')
print('YANGI sxema:', [f.name for f in t.schema().fields])
print()

eski = t.scan().to_arrow().to_pandas()
print(f'eski qatorlar: {len(eski):,}')
print(f'yangi ustun eski qatorlarda: {eski[\"rasmlar_soni\"].isna().sum():,} ta null')
"
ESKI sxema: ['elon_id', 'tuman', 'narx_mln', 'xonalar', 'tavsif_uzunligi', 'broker']
YANGI sxema: ['elon_id', 'tuman', 'narx_mln', 'xonalar', 'tavsif_uzunligi', 'broker', 'rasmlar_soni']

eski qatorlar: 9,500
yangi ustun eski qatorlarda: 9,500 ta null
Bitta fayl ham qayta yozilmadi.
`add_column` pyarrow turini qabul qilmaydi
Bu yerda men xato qildim: u.add_column('rasmlar_soni', pa.int64(), ...) deb yozdim va build
to'xtadi.
Sabab: update_schema() Iceberg ning o'z turlarini kutadi, pyarrow nikini emas. To'g'risi:
from pyiceberg.types import LongType
u.add_column('rasmlar_soni', LongType(), 'izoh')
Chalkashlik tabiiy, chunki jadvalga ma'lumotni pyarrow bilan yozamiz. Lekin sxema — Iceberg ning ishi, ma'lumot — pyarrow niki. Ikki qatlam, ikki xil tur tizimi.
Nega bu mumkin? Chunki Iceberg ustunlarni nom bilan emas, raqam (id) bilan kuzatadi.
Ro'yxatda "3-ustun = narx" deb yozilgan. Yangi ustun qo'shsangiz, u 7-raqamni oladi.
Eski qutilarda 7-raqamli ustun yo'q — demak javob null.
Taqqoslang: oddiy Parquet to'plamida yangi ustun qo'shish uchun barcha eski fayllarni ochib, o'qib, yangi ustun qo'shib, qayta yozish kerak bo'lardi. Bir terabaytlik jadvalda bu bir kechalik ish va katta xavf.
python3 -c "
import sys; sys.path.insert(0, 'src')
import pandas as pd, pyarrow as pa
from quvur.muz import katalog

USTUN = ['elon_id','tuman','narx_mln','xonalar','tavsif_uzunligi','broker','rasmlar_soni']
d = pd.read_csv('../datasets/ijara.csv').drop_duplicates('elon_id')
c = katalog()
t = c.load_table('rostuy.elon')

yangi = d.iloc[9500:11000][USTUN]
t.append(pa.Table.from_pandas(yangi, preserve_index=False).cast(t.schema().as_arrow()))

ark = t.scan().to_arrow().to_pandas()
print(f'jami qatorlar        : {len(ark):,}')
print(f'rasmlar_soni bor     : {ark[\"rasmlar_soni\"].notna().sum():,}')
print(f'rasmlar_soni null    : {ark[\"rasmlar_soni\"].isna().sum():,}')
print()
print('Bitta jadvalda ikki avlod ma\\'lumot birga yashayapti.')
"
jami qatorlar        : 11,000
rasmlar_soni bor     : 1,500
rasmlar_soni null    : 9,500

Bitta jadvalda ikki avlod ma'lumot birga yashayapti.
Sxema evolyutsiyasi hammasini kechirmaydi
Iceberg xavfsiz qiladigan amallar: ustun qo'shish, nomini o'zgartirish, o'chirish,
tartibni o'zgartirish, turni kengaytirish (int → long).
Xavfsiz emas: turni toraytirish (long → int), null bo'lishi mumkin ustunni majburiy
qilish. Bularni Iceberg rad etadi — va to'g'ri qiladi.
Eng ko'p uchraydigan xato: ustunni o'chirib, keyin bir xil nom bilan boshqa turda qayta
qo'shish. Nom bir xil, id boshqa — eski ma'lumot null bo'lib qoladi va buni hech kim darhol
sezmaydi.
Kichik fayl muammosi
Yana omborga. Sizda 6000 ta hujjat bor. Ularni ikki xil terish mumkin:
- Bitta katta quti — hammasi ichida, bir marta ochasiz.
- 60 ta kichik quti — har birida 100 tadan. 60 marta ochasiz, 60 marta yopasiz.
Hujjatlar soni bir xil. Lekin ikkinchi holatda ish ancha ko'p, chunki har qutini ochish va yopishning o'z narxi bor.
Oqimli yuklamada aynan shu bo'ladi: har necha daqiqada kichik fayl yoziladi, bir oyda o'n minglab fayl to'planadi. Har fayl uchun ochish, metama'lumotini o'qish, yopish kerak.
O'lchab ko'ramiz:
python3 -c "
import sys, pathlib, time; sys.path.insert(0, 'src')
import pandas as pd, pyarrow as pa
from quvur.muz import katalog

USTUN = ['elon_id','tuman','narx_mln','xonalar','tavsif_uzunligi','broker']
d = pd.read_csv('../datasets/ijara.csv').drop_duplicates('elon_id').head(6000)
c = katalog()
c.create_namespace_if_not_exists('sinov')
try: c.drop_table('sinov.kichik')
except Exception: pass
try: c.drop_table('sinov.katta')
except Exception: pass

# 60 ta kichik yozuv (oqim uslubi)
ar = pa.Table.from_pandas(d[USTUN], preserve_index=False)
kichik = c.create_table('sinov.kichik', schema=ar.schema)
for i in range(0, 6000, 100):
    kichik.append(pa.Table.from_pandas(d.iloc[i:i+100][USTUN], preserve_index=False))

# bitta katta yozuv (batch uslubi)
katta = c.create_table('sinov.katta', schema=ar.schema)
katta.append(ar)

def sana(t, nom):
    fayllar = [f.file.file_path for f in t.scan().plan_files()]
    hajm = sum(pathlib.Path(f.replace('file://','')).stat().st_size for f in fayllar)
    t0 = time.perf_counter()
    for _ in range(5): t.scan().to_arrow()
    ms = (time.perf_counter()-t0)/5*1000
    print(f'{nom:22s} fayllar={len(fayllar):>4d}  jami={hajm/1024:>8.1f} KB  o\\'qish={ms:>7.1f} ms')
    return ms, len(fayllar), hajm

a, fa, ha = sana(kichik, '60 ta kichik yozuv')
b, fb, hb = sana(katta, '1 ta katta yozuv')
print()
print(f'fayl soni  {fa/fb:.0f}x ko\\'p')
print(f'disk hajmi {ha/hb:.1f}x katta')
print(f'o\\'qish     {a/b:.1f}x sekin')
"
60 ta kichik yozuv     fayllar=  60  jami=   228.0 KB  o'qish=  111.0 ms
1 ta katta yozuv       fayllar=   1  jami=    56.7 KB  o'qish=    9.0 ms

fayl soni  60x ko'p
disk hajmi 4.0x katta
o'qish     12.3x sekin
Bir xil 6000 qator, bir xil ma'lumot — lekin fayllarga bo'linishi boshqa. Natija o'zi gapiradi.
Yechim — siqish (compaction): kichik fayllarni birlashtirish. Iceberg da bu muntazam
bajariladigan xizmat ishi. pyiceberg da hozircha cheklangan, Spark da
CALL system.rewrite_data_files bor.
Eski snapshotlar joyni egallaydi
Time travel bepul emas: eski snapshotlar eski fayllarni ushlab turadi. Ular o'chirilmaydi.
Shuning uchun ishlab chiqarishda saqlash muddati belgilanadi (masalan 7 kun) va expire_snapshots
muntazam ishlatiladi. Aks holda ombor cheksiz o'sadi.
Bu 11-bobdagi unutilgan replikatsiya sloti bilan bir xil naqsh: foydali mexanizm, tozalanmasa zararli.
Iceberg nimani hal qiladi
import pandas as pd
show(pd.DataFrame([
    {"Muammo": "Qaysi fayllar jadvalga kiradi", "Parquet to'plami": "Noma'lum",
     "Iceberg": "Manifest aytadi"},
    {"Muammo": "Yozayotganda o'qish", "Parquet to'plami": "Yarim ma'lumot ko'rinadi",
     "Iceberg": "Snapshot atomik almashadi"},
    {"Muammo": "Kecha qanday edi", "Parquet to'plami": "Javob yo'q",
     "Iceberg": "Time travel"},
    {"Muammo": "Ustun qo'shish", "Parquet to'plami": "Hamma faylni qayta yozish",
     "Iceberg": "Faqat metama'lumot"},
    {"Muammo": "Bitta qatorni o'chirish", "Parquet to'plami": "Faylni qayta yozish",
     "Iceberg": "Delete fayl"},
]))
| Muammo | Parquet to'plami | Iceberg |
|---|---|---|
| Qaysi fayllar jadvalga kiradi | Noma'lum | Manifest aytadi |
| Yozayotganda o'qish | Yarim ma'lumot ko'rinadi | Snapshot atomik almashadi |
| Kecha qanday edi | Javob yo'q | Time travel |
| Ustun qo'shish | Hamma faylni qayta yozish | Faqat metama'lumot |
| Bitta qatorni o'chirish | Faylni qayta yozish | Delete fayl |
Tozalash
python3 -c "
import sys; sys.path.insert(0, 'src')
from quvur.muz import katalog
c = katalog()
for t in ('sinov.kichik', 'sinov.katta'):
    try: c.drop_table(t); print(f'{t} o\\'chirildi')
    except Exception as e: print(f'{t}: {type(e).__name__}')
print('rostuy.elon saqlanadi (16-bobda kerak)')
"
sinov.kichik o'chirildi
sinov.katta o'chirildi
rostuy.elon saqlanadi (16-bobda kerak)
Xulosa
| Tushuncha | Asosiy fikr |
|---|---|
| Fayl va jadval formati | Parquet — fayl, Iceberg — jadval |
| Metama'lumot | Katalog → metadata → manifest → fayllar |
| Snapshot | Har yozuv yangi snapshot yaratadi |
| Time travel | scan(snapshot_id=...) — eski holat o'qiladi |
| Ma'lumot versiyasi | Snapshot id ni pasportga yozing (5, 24-bob) |
| Sxema evolyutsiyasi | Ustun id bilan kuzatiladi, fayl qayta yozilmaydi |
| Xavfli o'zgarish | Turni toraytirish, nomni qayta ishlatish |
| Kichik fayl | Ko'p mayda yozuv o'qishni sekinlashtiradi |
| Tozalash | expire_snapshots bo'lmasa ombor cheksiz o'sadi |
Talaba ishi
- To'rtinchi
appendqiling va snapshot ro'yxatini qayta chop eting. Eng eski snapshot hali o'qiladimi? - Ustun o'chiring, keyin bir xil nom bilan boshqa turda qo'shing. Eski qatorlarda nima ko'rinadi?
- Kichik yozuv o'lchamini 100 dan 10 ga tushiring. Fayl soni va o'qish vaqti qanday o'zgardi?
tumanbo'yicha partitsiyalangan jadval yarating va bitta tuman bo'yicha so'rovni partitsiyasiz jadval bilan solishtiring.
Bu bobni bepul o'qidingiz.
Kitob o'rgatadi, lekin sizning kodingiz nega ishlamaganini ayta olmaydi. Kursda uy vazifangiz tekshiriladi.