A/B test: sababni tajriba bilan topish
Nega tajriba
27-bobning oxirgi jumlasi: sababni faqat tajriba ko'rsatadi. A/B test shu tajriba: foydalanuvchilar tasodifan ikki guruhga bo'linadi, A eski versiyani ko'radi, B yangisini, boshqa hamma narsa bir xil. Tasodifiy bo'linish aralashuvchi omillarni ikki guruhga teng taqsimlaydi, shuning uchun farq faqat o'zgarishdan.
Do'kon "Sotib olish" tugmasini o'zgartirdi. ab_test.csv: har foydalanuvchi, variant, sotib oldimi, qurilma.
ab = pd.read_csv(CSV.parent / "ab_test.csv")
print(ab.shape); show(ab.head(3))
r = ab.groupby("variant").converted.agg(n="count", konversiya="mean", sotib_oldi="sum")
r["konversiya_%"] = (100 * r.konversiya).round(2)
show(r[["n", "sotib_oldi", "konversiya_%"]])
lift = r.konversiya["B"] / r.konversiya["A"] - 1
print(f"farq: {100*(r.konversiya['B'] - r.konversiya['A']):+.2f} punkt | nisbiy o'sish (lift): {100*lift:+.1f}%")
(18000, 4)
farq: +0.51 punkt | nisbiy o'sish (lift): +12.4%
| user_id | variant | converted | device |
|---|---|---|---|
| 5 149 | A | 0 | android |
| 6 328 | A | 0 | ios |
| 16 675 | B | 0 | android |
| variant | n | sotib_oldi | konversiya_% |
|---|---|---|---|
| A | 9 000 | 370 | 4.11 |
| B | 9 000 | 416 | 4.62 |
B 4.62%, A 4.11%: +0.51 punkt, +12% lift. Marketing "12% o'sish!" deb slayd tayyorlaydi. Analitik avval so'raydi: bu tasodif bo'lishi mumkinmi?
Tekshiruv: tasodifmi
from scipy import stats
def nisbat_testi(k1, n1, k2, n2):
    p1, p2, p = k1 / n1, k2 / n2, (k1 + k2) / (n1 + n2)
    z = (p2 - p1) / np.sqrt(p * (1 - p) * (1 / n1 + 1 / n2))
    se = np.sqrt(p1 * (1 - p1) / n1 + p2 * (1 - p2) / n2)
    return z, 2 * (1 - stats.norm.cdf(abs(z))), (p2 - p1 - 1.96 * se, p2 - p1 + 1.96 * se)

z, p, ci = nisbat_testi(r.sotib_oldi["A"], r.n["A"], r.sotib_oldi["B"], r.n["B"])
print(f"z = {z:.2f} | p = {p:.3f} | farq 95% IO: [{100*ci[0]:+.2f}, {100*ci[1]:+.2f}] punkt")
z = 1.68 | p = 0.093 | farq 95% IO: [-0.09, +1.11] punkt
p = 0.09: farq yo'q dunyoda bunday natija 100 dan 9 marta chiqadi. Odatdagi chegara 0.05 dan yuqori. Ishonch oralig'i −0.09 dan +1.11 punktgacha: B yomonroq ham bo'lishi mumkin (ozgina), 1 punkt yaxshiroq ham. Xulosa: natija noaniq, qaror uchun ma'lumot yetarli emas. Bu "B ishlamadi" degani emas. "Hali bilmaymiz" degani.
Bootstrap bilan xuddi shu (27-bob), formulasiz:
rng = np.random.default_rng(1)
a = ab[ab.variant == "A"].converted.values; b = ab[ab.variant == "B"].converted.values
farqlar = np.array([rng.choice(b, len(b)).mean() - rng.choice(a, len(a)).mean() for _ in range(3000)])
print(f"bootstrap 95% IO: [{100*np.percentile(farqlar, 2.5):+.2f}, {100*np.percentile(farqlar, 97.5):+.2f}] punkt | farq > 0 bo'lgan ulush: {100*(farqlar > 0).mean():.0f}%")
bootstrap 95% IO: [-0.10, +1.08] punkt | farq > 0 bo'lgan ulush: 95%
Nega yetarli emas: namuna hajmi
Test boshlanishidan oldin hisoblanadigan narsa: qancha foydalanuvchi kerak. Uch kirish: hozirgi konversiya (4%), sezmoqchi bo'lgan minimal farq (MDE, masalan +0.5 punkt), va xato darajalari (α = 0.05, quvvat 80%).
def namuna_hajmi(p0, mde, alpha=0.05, power=0.8):
    p1 = p0 + mde; z_a, z_b = stats.norm.ppf(1 - alpha / 2), stats.norm.ppf(power)
    pbar = (p0 + p1) / 2
    n = (z_a * np.sqrt(2 * pbar * (1 - pbar)) + z_b * np.sqrt(p0 * (1 - p0) + p1 * (1 - p1))) ** 2 / mde ** 2
    return int(np.ceil(n))
jadval = pd.DataFrame({"MDE_punkt": [0.25, 0.5, 1.0, 2.0]})
jadval["nisbiy_%"] = (100 * jadval.MDE_punkt / 4).round(0)
jadval["n_har_variant"] = [namuna_hajmi(0.04, m / 100) for m in jadval.MDE_punkt]
jadval["kunlar (1000 user/kun)"] = (2 * jadval.n_har_variant / 1000).round(0)
show(jadval)
| MDE_punkt | nisbiy_% | n_har_variant | kunlar (1000 user/kun) |
|---|---|---|---|
| 0.25 | 6 | 99 331 | 199 |
| 0.5 | 12 | 25 551 | 51 |
| 1 | 25 | 6 745 | 13 |
| 2 | 50 | 1 863 | 4 |
+0.5 punktni ishonchli sezish uchun har variantga 25 mingdan ko'p foydalanuvchi kerak, bizda 9 ming. Test hajmi kichik, va bu testdan oldin ma'lum edi. Analitikning birinchi hissasi A/B testga: "bu farqni sezish uchun N kun kerak, shuncha kutamizmi yoki kattaroq o'zgarish sinaymizmi?"
Formula sezgi: kerakli n ∝ 1 / MDE². Ikki marta kichik farqni sezish uchun to'rt marta ko'p foydalanuvchi.
Quvvat: sezmaslik ehtimoli
Quvvat (power) 80%: agar haqiqiy farq MDE ga teng bo'lsa, test uni 100 dan 80 marta "sezadi". 20 marta sezmaydi. Simulyatsiya: haqiqiy farq +0.5 punkt bo'lgan dunyoda 9000 talik test necha marta p < 0.05 beradi?
rng = np.random.default_rng(3)
def sim(n, p0, p1, takror=1000):
    ka = rng.binomial(n, p0, takror); kb = rng.binomial(n, p1, takror)
    return np.mean([nisbat_testi(x, n, y, n)[1] < 0.05 for x, y in zip(ka, kb)])
for n in [9000, 24000, 50000]:
    print(f"n={n:6} har variantda: haqiqiy +0.5 punkt farqni sezish ehtimoli {100*sim(n, 0.04, 0.045):.0f}%")
print(f"n=9000, haqiqiy farq YO'Q: soxta 'sezilarli' chiqish ehtimoli {100*sim(9000, 0.04, 0.04):.1f}%  (bu alpha)")
n=  9000 har variantda: haqiqiy +0.5 punkt farqni sezish ehtimoli 39%
n= 24000 har variantda: haqiqiy +0.5 punkt farqni sezish ehtimoli 77%
n= 50000 har variantda: haqiqiy +0.5 punkt farqni sezish ehtimoli 97%
n=9000, haqiqiy farq YO'Q: soxta 'sezilarli' chiqish ehtimoli 5.0%  (bu alpha)
9000 da quvvat 40% atrofida: haqiqiy +0.5 punkt bo'lsa ham test uni 10 dan 6 marta ko'rmaydi. Va farq yo'q bo'lsa 5% hollarda "bor" deydi. Ikki xato turi: I tur (yo'q narsani bor deyish, α) va II tur (bor narsani ko'rmaslik, 1 − quvvat).
Segmentlar: qurilma bo'yicha
seg = ab.groupby(["device", "variant"]).converted.agg(["count", "sum", "mean"]).unstack()
out = pd.DataFrame({"n_A": seg[("count", "A")], "n_B": seg[("count", "B")], "A_%": (100 * seg[("mean", "A")]).round(2), "B_%": (100 * seg[("mean", "B")]).round(2)})
out["p"] = [round(nisbat_testi(seg.loc[i, ("sum", "A")], seg.loc[i, ("count", "A")], seg.loc[i, ("sum", "B")], seg.loc[i, ("count", "B")])[1], 3) for i in out.index]
show(out)
| device | n_A | n_B | A_% | B_% | p |
|---|---|---|---|---|---|
| android | 5 401 | 5 400 | 3.98 | 4.31 | 0.384 |
| ios | 2 228 | 2 235 | 4.58 | 5.15 | 0.378 |
| web | 1 371 | 1 365 | 3.87 | 4.98 | 0.156 |
Segmentlarga bo'lish ikki xavf bilan keladi. Birinchisi: har segment kichikroq, quvvat yanada past. Ikkinchisi: 3 segment = 3 test, "biror joyda p < 0.05" chiqish ehtimoli 14%. Segment natijasini yangi gipoteza deb qabul qilish mumkin ("web da effekt kattaroq, alohida test qilaylik"), xulosa deb emas.
A/A test: tasodifning yuzi
Ikki guruhga bir xil versiya ko'rsatilsa, p-qiymat qanday taqsimlanadi? Bu testning "sog'lomligini" tekshiradi.
rng = np.random.default_rng(11)
pv = []
for _ in range(2000):
    x = rng.permutation(ab.converted.values)                # variantlarni tasodifan aralashtiramiz: A/A
    ka, kb = x[:9000].sum(), x[9000:].sum()
    pv.append(nisbat_testi(ka, 9000, kb, 9000)[1])
pv = np.array(pv)
print(f"A/A: p < 0.05 chiqqan ulush {100*(pv < 0.05).mean():.1f}% | p < 0.01: {100*(pv < 0.01).mean():.1f}% | eng kichik p: {pv.min():.4f}")
f, ax = plt.subplots(figsize=(7, 3))
ax.hist(pv, bins=20, color="#4C72B0"); ax.set_title("A/A test: p-qiymat tekis taqsimlanadi, 5% i 0.05 dan kichik"); ax.set_xlabel("p-qiymat")
fig("aa.png", "Hech qanday farq yo'q, lekin 2000 ta A/A testdan 5% i 'sezilarli'. Har 20 ta testdan biri soxta. Shuning uchun bitta test bitta gipoteza, va natija takrorlanishi kerak.")
A/A: p < 0.05 chiqqan ulush 5.8% | p < 0.01: 1.1% | eng kichik p: 0.0001
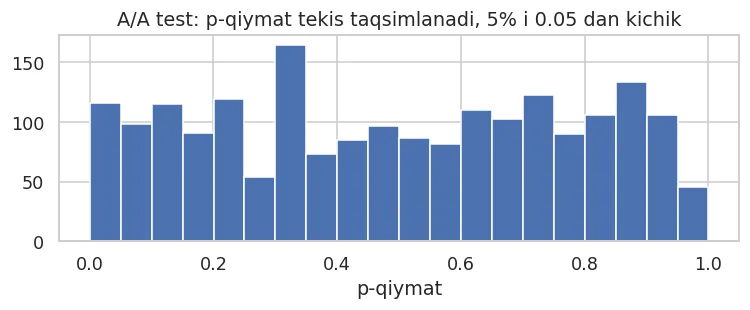
Hech qanday farq yo'q, lekin 2000 ta A/A testdan 5% i 'sezilarli'. Har 20 ta testdan biri soxta. Shuning uchun bitta test bitta gipoteza, va natija takrorlanishi kerak.
Test xatolari ro'yxati
| Xato | Nima bo'ladi | Himoya |
|---|---|---|
| Qarab turish (peeking) | Har kuni p ga qarab, 0.05 dan tushganda to'xtatish: soxta topilma 5% emas, 30% | n oldindan; muddat tugaguncha qaramaslik |
| Kichik n | Quvvat past, "farq yo'q" deb yolg'on xulosa | Namuna hajmi hisobi testdan oldin |
| Ko'p metrika | 10 metrikadan bittasi "o'sdi" | Bitta asosiy metrika oldindan; qolgani qarshi metrika |
| Segment ovi | 8 segmentdan birida effekt | Segment = gipoteza, xulosa emas |
| Yangilik effekti | Yangi tugma birinchi hafta qiziq, keyin odatiy | Test 2+ hafta, to'liq hafta sikli |
| Nomutanosib bo'linish (SRM) | 9000 / 8200: tasodifiy bo'linish buzilgan | chisquare bilan tekshirish; buzilsa test bekor |
| Bir foydalanuvchi ikki guruhda | Cookie tozalagan, ikki qurilma | user_id bo'yicha bo'lish, takrorni tekshirish |
print("SRM tekshiruvi: chisquare([9000, 9000]) p =", round(stats.chisquare(r.n.values).pvalue, 3), "| takror user_id:", ab.user_id.duplicated().sum())
SRM tekshiruvi: chisquare([9000, 9000]) p = 1.0 | takror user_id: 0
Hisobot
Test hisoboti bir sahifa: gipoteza, metrika, n va muddat, natija oraliq bilan, qaror, keyingi qadam.
A/B: "Sotib olish" tugmasi (B: yashil, katta)      Muddat: 14 kun      n: 9 000 / 9 000
Asosiy metrika: sotib olish konversiyasi. Qarshi metrika: bekor foizi (o'zgarmadi).
Natija: A 4.11%, B 4.62%, farq +0.51 p.p. (95% IO: -0.09 .. +1.11), p = 0.09.
Qaror: chiqarmaymiz, testni davom ettiramiz: +0.5 p.p. ni sezish uchun 25 500 / variant kerak (yana ~33 kun).
Segment: web da +1.1 p.p., p = 0.16 (n kichik, gipoteza sifatida yoziladi, qaror emas).
Xavf: SRM yo'q, takror user yo'q, hafta sikli to'liq.
Xulosa
| Tushuncha | Asosiy fikr |
|---|---|
| A/B nima | Tasodifiy bo'linish aralashuvchi omillarni tenglashtiradi: farq = sabab |
| Natija o'qish | Farq + oraliq + p; "noaniq" ham to'g'ri javob |
| Namuna hajmi | Testdan oldin: p0, MDE, α, quvvat; n ∝ 1/MDE² |
| Ikki xato | I tur (α, soxta topilma), II tur (quvvat past, o'tkazib yuborish) |
| Segmentlar | Gipoteza, xulosa emas; ko'p test = soxta topilma |
| A/A | p tekis; 5% soxta; bitta test bitta gipoteza |
| Jarayon | n va metrika oldindan, qaramaslik, SRM, hisobot bir sahifa |
Talaba ishi
namuna_hajmibilan: konversiya 20% bo'lgan saytda +2 punktni sezish uchun n? 1% konversiyada +0.2 punkt uchun? Nega ikkinchisi ancha katta?- Peeking ni simulyatsiya qiling: farq yo'q dunyoda 9000 talik testni 1000 dan boshlab har 1000 da tekshiring, p < 0.05 chiqsa to'xtating. Necha foiz testda "soxta topilma"?
ab_test.csvga qo'shimcha metrika o'ylab toping (masalan "bekor foizi"): B da yaxshilanib, A da yomonlashishi mumkin bo'lgan qarshi metrika nima bo'lardi?- Yuqoridagi hisobot shablonini to'ldirib, rahbarga 3 jumlada aytib bering: nima qildik, nima ko'rdik, nima qilamiz.
Bu bobni bepul o'qidingiz.
Kitob o'rgatadi, lekin sizning kodingiz nega ishlamaganini ayta olmaydi. Kursda uy vazifangiz tekshiriladi.