Ko'p klassli confusion matrix
Endi 10 ta raqamning hammasini taniymiz. Matritsa 10 × 10 bo'ladi. Qoidalar o'sha: - qatorlar — haqiqiy raqam (0 dan 9 gacha), - ustunlar — model aytgan raqam, - diagonal — to'g'ri javoblar, qolgani — adashishlar.
StandardScaler qo'shamiz: SGD feature larning masshtabiga sezgir, scaling bilan natija yaxshilanadi. n_jobs=-1 hamma CPU yadrolarini ishlatadi. Baribir bu katak taxminan 2 minut ishlaydi.
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler

sgd_10 = make_pipeline(StandardScaler(), SGDClassifier(random_state=42))
y_train_pred_10 = cross_val_predict(sgd_10, X_train, y_train, cv=3, n_jobs=-1)
cm_10 = confusion_matrix(y_train, y_train_pred_10)
cm_10
array([[5560,    0,   20,    5,    9,   40,   34,    5,  249,    1],
       [   0, 6399,   36,   24,    4,   44,    4,    8,  214,    9],
       [  28,   28, 5200,   89,   70,   27,   68,   36,  404,    8],
       [  20,   18,  112, 5191,    1,  198,   26,   38,  457,   70],
       [   9,   14,   43,    9, 5178,   12,   34,   24,  367,  152],
       [  26,   15,   28,  164,   53, 4414,   75,   15,  576,   55],
       [  27,   15,   43,    2,   43,   94, 5549,    3,  141,    1],
       [  20,   11,   49,   26,   48,   13,    3, 5677,  215,  203],
       [  17,   62,   44,   88,    3,  119,   24,   10, 5447,   37],
       [  22,   19,   29,   63,  114,   35,    1,  177,  419, 5070]])
100 ta raqamni ko'z bilan o'qish qiyin, lekin bitta qatorni o'qib ko'ramiz. 5-qator (haqiqiy 5 lar): 4414 tasi to'g'ri topilgan. 576 tasi 8, 164 tasi 3 deb aytilgan. Ya'ni 5 larni model ko'pincha 8 va 3 bilan adashtiradi.
Nega qator bo'yicha normalizatsiya kerak?
Klasslar soni har xil: 1 lar 6742 ta, 5 lar 5421 ta. Oddiy sonlarda ko'p klassning xatosi ham ko'p bo'lib ko'rinadi, shuning uchun klasslarni to'g'ri solishtirib bo'lmaydi. Shuning uchun har bir qatorni o'z yig'indisiga bo'lamiz (normalize="true"). Endi har bir katak foiz: "shu raqamning necha foizi qayerga ketdi".
O'ngdagi grafikda faqat xatolarni qoldiramiz. sample_weight ga "xatomi?" massivini beramiz: to'g'ri javoblar 0 vazn oladi va rasmdan yo'qoladi. Endi har bir katak "shu raqamning xatolarining necha foizi qayerga ketdi"ni ko'rsatadi.
fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(13, 5.5))
ConfusionMatrixDisplay.from_predictions(y_train, y_train_pred_10, normalize="true",
                                        values_format=".0%", ax=ax1, colorbar=False)
ConfusionMatrixDisplay.from_predictions(y_train, y_train_pred_10, normalize="true", values_format=".0%",
                                        sample_weight=(y_train_pred_10 != y_train), ax=ax2, colorbar=False)
ax1.set_title("Hamma natijalar (qator bo'yicha %)")
ax2.set_title("Faqat xatolar (qator bo'yicha %)")
plt.show()
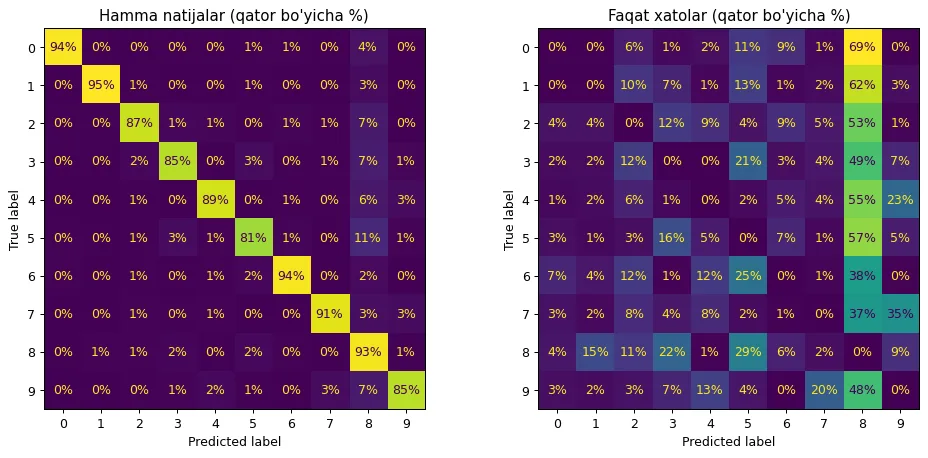
Chap grafik: diagonaldagi foiz — har bir raqamning recall i. Eng yomoni 5 (81%), eng yaxshilari 0, 1 va 6 (94–95%).
O'ng grafik: 8 ustuni juda yorqin. Deyarli hamma raqamlarning xatolari 8 ga ketyapti: 5 ning xatolaridan 57%, 2 ning xatolaridan 53%. Ya'ni model adashsa, ko'pincha "8" deydi.
E'tibor bering: matritsa simmetrik emas. 5 ning xatolaridan 57% i 8 ga ketadi, lekin 8 ning xatolaridan 5 ga ketgani 29%. "Kim kim bilan adashtiriladi" ikki tomondan har xil bo'lishi mumkin.
8 ustunini raqam bilan tekshiramiz:
pd.Series({"haqiqatda 8": (y_train == "8").sum(),
           "model 8 dedi": (y_train_pred_10 == "8").sum(),
           "shundan to'g'ri": cm_10[8, 8]})
haqiqatda 8        5851
model 8 dedi       8489
shundan to'g'ri    5447
dtype: int64
Model 8489 marta "8" dedi, lekin ulardan faqat 5447 tasi haqiqatan 8. Demak 8 klassining precision i 5447 / 8489 = 0.64. Model "8" desa, har 3 holatdan birida adashadi. Qoida o'sha: precision ustunga qaraydi.
Bu bilan nima qilamiz?
Confusion matrix modelni qayerda yaxshilash kerakligini ko'rsatadi. Bizda asosiy muammo — noto'g'ri "8" javoblari. Kitob uchta yo'l taklif qiladi: - 8 ga o'xshash, lekin 8 bo'lmagan rasmlardan ko'proq misol yig'ish. - Yangi feature qo'shish: masalan, yopiq halqalar soni (8 da 2 ta, 6 da 1 ta, 5 da yo'q). - Rasmlarni oldindan qayta ishlash, shunda halqalar yaxshiroq ko'rinadi.
Adashilgan rasmlarning o'ziga qaraymiz: 3 va 5
3 bilan 5 ikki tomonga ham adashtiriladi. Har bir kombinatsiyadan 6 tadan rasm olamiz:
juftlar = [("3", "3"), ("3", "5"), ("5", "3"), ("5", "5")]
fig, axes = plt.subplots(2, 2, figsize=(9, 3.2))
for ax, (h, b) in zip(axes.flat, juftlar):
    tanlov = X_train[(y_train == h) & (y_train_pred_10 == b)][:6]
    ax.imshow(np.hstack(tanlov.reshape(-1, 28, 28)), cmap="binary")
    ax.set_title(f"haqiqat {h}, model {b} dedi")
    ax.axis("off")
plt.show()
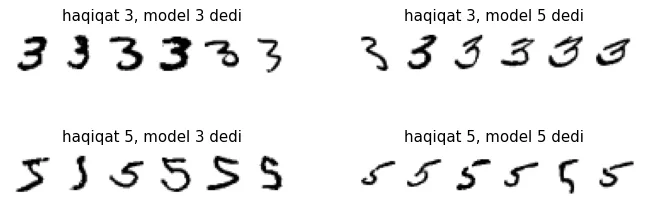
Ba'zi xatolarni tushunsa bo'ladi: bir nechta 5 haqiqatan 3 ga o'xshab yozilgan. Lekin ularning ko'pini odam bemalol taniydi, model esa adashgan.
Nega model bunday adashadi? SGDClassifier — linear model. U har bir piksel uchun bitta vazn o'rganadi va rasmni shunchaki piksellarning vaznli yig'indisi bilan baholaydi. 3 bilan 5 ning farqi bir necha pikselda: yuqori chiziqni pastki yoyga ulaydigan kichik chiziqning o'rnida. Rasm biroz surilsa yoki burilsa, o'sha piksellar o'zgaradi va model adashadi.
Yechim: rasmlarni markazga olib, to'g'rilab olish (preprocessing) yoki rasmning shaklini yaxshiroq tushunadigan model ishlatish (masalan, keyingi modullardagi CNN).
Bu bobni bepul o'qidingiz.
Kitob o'rgatadi, lekin sizning kodingiz nega ishlamaganini ayta olmaydi. Kursda uy vazifangiz tekshiriladi.