Nomutanosib ma'lumot
Nima u?
Nomutanosib (imbalanced) ma'lumot — bir klass ikkinchisidan ancha ko'p bo'lgan ma'lumot. Ko'p klass majority class, kam klass minority class deyiladi.
Real hayotda bu oddiy holat, istisno emas: - Karta firibgarligi: mashhur Kaggle dataseti (Credit Card Fraud) da 284 807 ta to'lovdan atigi 492 tasi firibgarlik, ya'ni 0.17%. - Kasallik skriningi: tekshirilganlarning ko'pchiligi sog'lom. - Zavoddagi nuqsonli mahsulot: 1000 tadan bir nechtasi. - Bizning MNIST: 5 lar 9%.
Va deyarli har doim kam klass — biz qidirayotgan klass.
Nega bu qiyin?
- Accuracy aldaydi. 2-bobda ko'rdik: hech narsa qilmaydigan model 91% oldi.
- Model ko'p klass tomonga og'adi. Model o'qishda umumiy xatolar sonini kamaytirishga harakat qiladi. Ko'pchilikka ko'p klassni aytsa, xatolar soni allaqachon kam bo'ladi. Shuning uchun model kam klassni aytishdan "qochadi".
- O'rganish uchun misol kam. Model kam klassni kam ko'radi.
- Bo'lishda kam klass yo'qolishi mumkin. Fold yoki test da kam klass umuman tushmasligi mumkin.
- ROC curve haddan tashqari yaxshi ko'rinadi. Buni hozir ko'ramiz.
ROC curve va PR curve
6-bobda ROC curve ni o'rgandik. Uning ikkala o'qi ham qator bo'yicha hisoblanadi: TPR — "haqiqat: 5" qatoridan, FPR — "haqiqat: 5 emas" qatoridan.
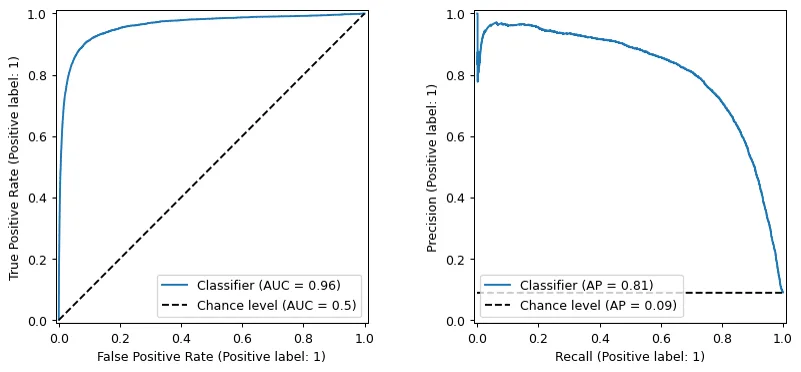
PR curve boshqacha: x o'qi — recall, y o'qi — precision. Precision esa ustun bo'yicha hisoblanadi: model "5" degan rasmlar ichidan. Nomutanosib ma'lumotda aynan shu farq hal qiluvchi bo'ladi.
PR curve da yaxshi joy — yuqori o'ng burchak (recall 1, precision 1). Tasodifiy modelning chizig'i 0.5 da emas, 5 lar ulushida (0.09) turadi: tasodifan "5" deydigan modelning precision i shunchaki 5 lar ulushiga teng bo'ladi. PR curve ostidagi yuza PR AUC (yoki average precision) deyiladi.
Ikkala grafikni bitta model uchun yonma-yon chizamiz:
from sklearn.metrics import RocCurveDisplay, PrecisionRecallDisplay

fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(11, 4.5))
RocCurveDisplay.from_predictions(y_train_5, y_scores, ax=ax1, plot_chance_level=True)
PrecisionRecallDisplay.from_predictions(y_train_5, y_scores, ax=ax2, plot_chance_level=True)
plt.show()
from sklearn.metrics import average_precision_score

pd.DataFrame({"model": [roc_auc_score(y_train_5, y_scores), average_precision_score(y_train_5, y_scores)],
              "tasodifiy model": [0.5, y_train_5.mean()]},
             index=["ROC AUC", "PR AUC (average precision)"])
                               model  tasodifiy model
ROC AUC                     0.960494          0.50000
PR AUC (average precision)  0.810042          0.09035
Model ham, score lar ham bir xil. Lekin: - ROC AUC = 0.960 — juda zo'r ko'rinadi. - PR AUC = 0.810 — yaxshi, lekin modelni hali ancha yaxshilash mumkinligi ko'rinib turibdi.
Nega ROC haddan tashqari yaxshi ko'rsatadi?
Hamma gap maxrajda. Bir xil 687 ta FP ni olaylik:
- FPR = FP / (hamma "5 emas"lar) = 687 / 54 579 = 1.3%. Maxraj ulkan, shuning uchun 687 ta xato juda kichik ko'rinadi.
- Precision = TP / (model "5" deganlar) = 3530 / 4217 = 0.837. Ya'ni model "5" degan javoblarining 16% i noto'g'ri.
Xatolar soni bir xil. Faqat ROC ularni katta klassning hajmiga bo'ladi, precision esa model "5" degan javoblar soniga bo'ladi. Ko'p klass qancha katta bo'lsa, FPR shuncha kichik chiqadi va ROC shuncha yaxshi ko'rinadi.
Kitobdagi qoida: kam klass (positive) kam uchrasa yoki FP siz uchun muhim bo'lsa, PR curve ga qarang. Aks holda ROC curve ishlatsa bo'ladi.
Ma'lumotni yanada nomutanosib qilamiz: 1%
9% hali yengil holat. Real masalalarda 1% yoki undan kam ham bo'ladi. Haqiqiy MNIST rasmlaridan 5 lardan faqat 550 tasini tasodifiy qoldiramiz, "5 emas"larning hammasi qoladi:
rng = np.random.default_rng(42)
qoldir = np.concatenate([np.flatnonzero(y_train != "5"),
                         rng.choice(np.flatnonzero(y_train_5), 550, replace=False)])
X_kam, y_kam = X_train[qoldir], y_train_5[qoldir]
pd.Series(y_kam).value_counts().to_frame().assign(ulushi=lambda d: d["count"] / len(y_kam))
       count    ulushi
False  54579  0.990023
True     550  0.009977
Endi 5 lar 1%. Xuddi shu modelni xuddi shu usulda baholaymiz va 9% bilan yonma-yon qo'yamiz. Bir xil kodni ikki marta yozmaslik uchun baholashni kichik funksiyaga olamiz:
kam_scores = cross_val_predict(sgd_clf, X_kam, y_kam, cv=3, method="decision_function")
kam_pred = kam_scores > 0

def baho(y_true, scores, pred):
    return {"accuracy": accuracy_score(y_true, pred), "precision": precision_score(y_true, pred),
            "recall": recall_score(y_true, pred), "ROC AUC": roc_auc_score(y_true, scores),
            "PR AUC": average_precision_score(y_true, scores)}

pd.DataFrame({"5 lar 9%": baho(y_train_5, y_scores, y_train_pred),
              "5 lar 1%": baho(y_kam, kam_scores, kam_pred)})
           5 lar 9%  5 lar 1%
accuracy   0.957033  0.993288
precision  0.837088  0.715311
recall     0.651171  0.543636
ROC AUC    0.960494  0.944941
PR AUC     0.810042  0.617991
Bu jadval nomutanosiblikning butun xavfini ko'rsatadi:
- Accuracy oshdi: 0.957 → 0.993. Model yaxshilanganga o'xshaydi.
- Aslida esa precision tushdi (0.837 → 0.715), recall tushdi (0.651 → 0.544). Model yomonlashdi.
- ROC AUC deyarli o'zgarmadi: 0.960 → 0.945.
- PR AUC esa sezilarli tushdi: 0.810 → 0.618.
Nega accuracy oshdi? Chunki endi 99% rasm "5 emas". Hech narsa qilmaydigan model 0.990 oladi. Bizning modelimiz undan atigi 0.3 foiz yaxshi. Accuracy faqat ko'p klass qanchalik ko'pligini ko'rsatyapti.
Nega o'zgarishni PR AUC eng to'g'ri ko'rsatdi? Kam klassning o'zi bilan hisoblanadi (precision va recall), shuning uchun "5 emas"larning ko'pligi unga ta'sir qilmaydi.
Matritsaning o'zi esa hammasini ochiq ko'rsatadi:
confusion_matrix(y_kam, kam_pred)
array([[54460,   119],
       [  251,   299]])
550 ta 5 dan 251 tasi o'tkazib yuborilgan (FN). Shu bilan birga 119 ta noto'g'ri signal (FP) bor. Accuracy 99.3% bo'lsa ham, model 5 larning deyarli yarmini topa olmayapti.
Stratification: nega fold larda nisbat saqlanishi kerak?
Ma'lumotimiz tartiblangan: avval 54 579 ta "5 emas", oxirida 550 ta 5. Oddiy KFold ma'lumotni tartib bo'yicha 3 bo'lakka kesadi. Har bir test fold ida nechta 5 bo'lishini sanaymiz:
from sklearn.model_selection import KFold, StratifiedKFold

pd.DataFrame({"KFold": [y_kam[test].sum() for _, test in KFold(3).split(X_kam)],
              "StratifiedKFold": [y_kam[test].sum() for _, test in StratifiedKFold(3).split(X_kam, y_kam)]},
             index=["1-fold", "2-fold", "3-fold"])
        KFold  StratifiedKFold
1-fold      0              184
2-fold      0              183
3-fold    550              183
KFold: 1- va 2-fold da bitta ham 5 yo'q, hamma 550 ta 5 3-fold ga tushdi. 3-fold ni test qilganda, model 1- va 2-fold da o'qitiladi, ya'ni bitta ham 5 ko'rmaydi. Bunday baho ma'nosiz.
StratifiedKFold: har bir fold da 183–184 ta 5. Har bir fold da klasslar nisbati butun ma'lumotdagi bilan bir xil (taxminan 1%).
Nega yuqoridagi natijalarimiz to'g'ri chiqdi? Chunki cross_val_score va cross_val_predict ga classifier va cv=3 berilsa, sklearn o'zi StratifiedKFold ishlatadi. Lekin buni bilish kerak, chunki:
- train_test_split da buni o'zingiz yozishingiz kerak: stratify=y.
- KFold(...) ni qo'lda yaratsangiz, stratification bo'lmaydi.
class_weight="balanced": nega va qanday ishlaydi?
2-sababni eslang: model umumiy xatoni kamaytiradi va har bir xato bir xil "narx"ga ega. 99% rasm "5 emas" bo'lgani uchun model asosan ularga moslashadi.
class_weight="balanced" har bir klassga vazn beradi: kam klassdagi xato qimmatroq bo'ladi. Formula: vazn = jami namunalar / (klasslar soni × shu klassdagi namunalar).
from sklearn.utils.class_weight import compute_class_weight

pd.Series(compute_class_weight("balanced", classes=np.array([False, True]), y=y_kam), index=["5 emas", "5"])
5 emas     0.505039
5         50.117273
dtype: float64
5 ning vazni 50.1, "5 emas"niki 0.505. Nisbati taxminan 99. Ya'ni o'qitishda bitta 5 dagi xato taxminan 99 ta "5 emas"dagi xatoga teng hisoblanadi. Bu aynan klasslar nisbatini (54 579 / 550 ≈ 99) muvozanatlaydi.
Oddiy model bilan balanced modelni bir xil 1% ma'lumotda solishtiramiz:
sgd_bal = SGDClassifier(class_weight="balanced", random_state=42)
bal_scores = cross_val_predict(sgd_bal, X_kam, y_kam, cv=3, method="decision_function")
bal_pred = bal_scores > 0

pd.DataFrame([confusion_matrix(y_kam, kam_pred).ravel(), confusion_matrix(y_kam, bal_pred).ravel()],
             index=["oddiy", "balanced"], columns=["TN", "FP", "FN", "TP"]
            ).assign(precision=lambda d: d.TP / (d.TP + d.FP), recall=lambda d: d.TP / (d.TP + d.FN))
             TN    FP   FN   TP  precision    recall
oddiy     54460   119  251  299   0.715311  0.543636
balanced  53217  1362  115  435   0.242070  0.790909
- FN 251 dan 115 ga tushdi, recall 0.544 → 0.791. Model 5 larni ancha ko'p topyapti.
- FP 119 dan 1362 ga oshdi, precision 0.715 → 0.242. Noto'g'ri signal ko'paydi.
Nega shunday? Vazn qaror chizig'ini "5 emas" tomonga suradi. Bu threshold ni tushirishga juda o'xshaydi. Demak bunda bir narsa yaxshilanib, boshqasi yomonlashdi: biz yana o'sha precision/recall trade-off ning boshqa nuqtasiga o'tdik.
Qaysi biri yaxshi? Bu xatolarning narxiga bog'liq. Kasallikda FN qimmat, shuning uchun balanced yaxshiroq. Spam filtrida FP qimmat, shuning uchun oddiy model yaxshiroq.
Nomutanosiblik bilan ishlashning boshqa usullari: - Threshold ni tanlash — 5-bobda qildik. Ko'pincha eng sodda va yetarli usul. - Resampling — kam klassni ko'paytirish (oversampling, masalan SMOTE) yoki ko'p klassni kamaytirish (undersampling). Bu faqat train qismiga qilinadi, test ga hech qachon qilinmaydi. - Ko'proq ma'lumot yig'ish — kam klassdan yangi misollar topish. Ko'pincha eng kuchli usul.
Oxirgi qadam: test set da bir marta tekshirish
Hamma tanlov train da qilindi: model va threshold (precision 90% uchun 3370). Endi modelni butun train da o'qitamiz va test set ni birinchi va oxirgi marta ishlatamiz:
sgd_clf.fit(X_train, y_train_5)
test_pred = sgd_clf.decision_function(X_test) >= threshold_90
confusion_matrix(y_test_5, test_pred)
array([[9069,   39],
[ 368, 524]])pd.Series({"precision": precision_score(y_test_5, test_pred), "recall": recall_score(y_test_5, test_pred)})
precision    0.930728
recall       0.587444
dtype: float64
Test da precision 0.931, recall 0.587. Cross-validation da 0.900 va 0.480 edi. Test natijasi biroz yaxshiroq. Buning sababi: endi model 60 000 ta rasmda o'qitildi, cross-validation da esa har safar 40 000 tada o'qitilgan edi. Raqamlar bir xil bo'lishi shart emas, lekin bir-biriga yaqin. Demak threshold tanlovimiz yangi ma'lumotda ham ishlaydi.
Muhim: bu test natijasini ko'rib, endi threshold ni o'zgartirmaymiz. Aks holda test ham "train"ga aylanib qoladi.
Bu bobni bepul o'qidingiz.
Kitob o'rgatadi, lekin sizning kodingiz nega ishlamaganini ayta olmaydi. Kursda uy vazifangiz tekshiriladi.