ROC curve va AUC
Nima u?
ROC curve — bitta modelning hamma threshold larda qanday ishlashini bitta grafikda ko'rsatadigan chiziq.
AUC — shu chiziq ostidagi yuza. U butun grafikni bitta songa aylantiradi.
Nega kerak?
5-bobda ko'rdik: confusion matrix threshold ga bog'liq. Threshold o'zgarsa, boshqa matritsa, boshqa precision va boshqa recall chiqadi. Bundan ikkita muammo kelib chiqadi:
- Ikki modelni qanday solishtiramiz? SGD threshold 0 da recall 0.65 berdi. Boshqa model o'z threshold ida recall 0.80 berishi mumkin. Qaysi biri yaxshi? Bitta threshold dagi matritsa bunga javob bermaydi: balki SGD ga boshqa threshold bersak, u ham 0.80 beradi.
- Threshold hali tanlanmagan bo'lsa-chi? Ko'pincha avval model quriladi, threshold esa keyin, loyiha talabiga qarab tanlanadi (masalan, "precision kamida 90% bo'lsin"). Modelni baholash uchun threshold ni kutib o'tira olmaymiz.
Demak bizga threshold ga bog'liq bo'lmagan baho kerak. Savol shunday: "model, threshold qayerda bo'lishidan qat'i nazar, 5 larni boshqalardan qanchalik yaxshi ajrata oladi?" ROC curve shu savolga grafik bilan javob beradi, AUC esa bitta son bilan.
Nega "ROC" deb ataladi?
ROC — Receiver Operating Characteristic, ya'ni "qabul qilgichning ishlash tavsifi". Bu nom Ikkinchi jahon urushi davridagi radarlardan qolgan.
Radar operatori ekrandagi nuqtaga qarab qaror qilgan: bu dushman samolyotimi yoki shunchaki shovqinmi? Radar qabul qilgichining (receiver) sezgirligini oshirsa, samolyotlarning ko'pi topiladi, lekin shovqinni ham samolyot deb o'ylash ko'payadi. Sezgirlikni kamaytirsa, aksincha bo'ladi. Muhandislar qabul qilgich har bir sezgirlikda qanday ishlashini bitta grafikda chizishgan. Shu grafik ROC curve deb atalgan. Keyin u tibbiyotga, undan ML ga o'tgan, nomi esa o'zgarmay qolgan.
Bizda ham xuddi shunday: sezgirlik = threshold, samolyot = 5, shovqin = 5 emas.
Ikki o'q nima va nega aynan ular?
- y o'qi — TPR (true positive rate) = TP / (TP + FN). Bu recall: haqiqiy 5 larning necha foizi topildi. "Haqiqat: 5" qatoridan hisoblanadi.
- x o'qi — FPR (false positive rate) = FP / (FP + TN). Bu 5 bo'lmagan rasmlarning necha foiziga model noto'g'ri "5" deganini ko'rsatadi. "Haqiqat: 5 emas" qatoridan hisoblanadi.
Nega aynan shu ikkitasi? Chunki ular threshold ning foydasi va narxi. Threshold ni tushirsak, ko'proq 5 topamiz (TPR oshadi — foyda), lekin ko'proq 5 emaslarga ham "5" deymiz (FPR oshadi — narx). Radar tilida: qancha samolyot topildi va qancha shovqin samolyot deb aytildi. ROC curve har bir threshold da foydani narxga qarshi qo'yib ko'rsatadi.
ROC curve ni qo'lda chizamiz
Tushunishning eng yaxshi yo'li — o'zimiz chizish. 10 ta haqiqiy rasm olamiz: 4 ta 5 va 6 ta 5 emas. Misol to'liq bo'lishi uchun ular orasiga model adashgan rasmlarni ham qo'shamiz: 3-bobdagi turi massividan 3 ta TP, 1 ta FN, 1 ta FP va 5 ta TN.
Rasmlarni score bo'yicha kattadan kichikka tartiblaymiz (np.argsort(-...): minus ishorasi tartibni kamayish bo'yicha qiladi). Har bir rasm tepasida uning score i:
tanlov = np.concatenate([np.flatnonzero(turi == t)[:n] for t, n in [("TP", 3), ("FN", 1), ("FP", 1), ("TN", 5)]])
tanlov = tanlov[np.argsort(-y_scores[tanlov])]

fig, axes = plt.subplots(1, 10, figsize=(13, 1.8))
for ax, i in zip(axes, tanlov):
    ax.imshow(X_train[i].reshape(28, 28), cmap="binary")
    ax.set_title(f"{y_scores[i]:.0f}", fontsize=9)
    ax.axis("off")
plt.show()
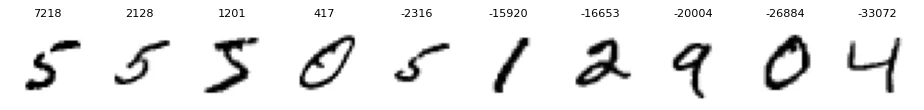
Tartibga qarang: avval uchta aniq yozilgan 5 (7218, 2128, 1201). Keyin 0 (417): model uni 5 ga o'xshatgan. Keyin qiyshiq yozilgan 5 (−2316). Oxirida boshqa raqamlar.
Ideal modelda hamma 5 lar chapda, hamma 5 emaslar o'ngda turardi. Bizda bitta xato bor: 0 bitta 5 dan oldinga o'tib ketgan.
Endi threshold ni eng yuqoridan boshlab pastga suramiz. Threshold biror rasmning score iga tushganda, shu rasm va undan chapdagi hamma rasmlar "5" deb aytiladi. Har bir qadamda TP va FP ni sanaymiz:
- cumsum() — yig'ilib boradigan yig'indi: har bir qatorda "shu qatorgacha nechta True bor". Rasmlar score bo'yicha tartiblangani uchun bu aynan "threshold shu yerda bo'lsa, nechta TP bor" degani.
- TPR = TP / 4 (jami 5 lar), FPR = FP / 6 (jami 5 emaslar).
kichik = pd.DataFrame({"score": y_scores[tanlov].round(), "haqiqat": y_train_5[tanlov]})
qadam = kichik.assign(TP=kichik.haqiqat.cumsum(), FP=(kichik.haqiqat == False).cumsum())
qadam = qadam.assign(TPR=qadam.TP / kichik.haqiqat.sum(), FPR=qadam.FP / (kichik.haqiqat == False).sum())
qadam
     score  haqiqat  TP  FP   TPR       FPR
0   7218.0     True   1   0  0.25  0.000000
1   2128.0     True   2   0  0.50  0.000000
2   1201.0     True   3   0  0.75  0.000000
3    417.0    False   3   1  0.75  0.166667
4  -2316.0     True   4   1  1.00  0.166667
5 -15920.0    False   4   2  1.00  0.333333
6 -16653.0    False   4   3  1.00  0.500000
7 -20004.0    False   4   4  1.00  0.666667
8 -26884.0    False   4   5  1.00  0.833333
9 -33072.0    False   4   6  1.00  1.000000
Jadvalni qadamma-qadam o'qiymiz:
- Boshlanish (jadvaldan oldin): threshold juda baland, model hech kimga "5" demaydi: TP = 0, FP = 0. Nuqta (0, 0).
- 0–2-qadamlar: threshold uchta 5 ga yetadi. Har safar TP bittaga oshadi, FP o'zgarmaydi. Nuqta tepaga yuradi: TPR 0.25 → 0.50 → 0.75.
- 3-qadam: threshold 0 rasmiga (417) yetdi. Endi model uni ham "5" deydi — bu FP. Nuqta o'ngga yuradi: FPR 0 → 0.17.
- 4-qadam: oxirgi 5 (−2316) ham topildi. Nuqta tepaga yuradi: TPR 1.00.
- 5–9-qadamlar: qolgan rasmlarning hammasi 5 emas. Har biri FP, nuqta faqat o'ngga yuradi va (1, 1) ga yetadi: endi model hammaga "5" deydi.
Qoida juda oddiy: haqiqiy 5 — bir qadam tepaga, 5 emas — bir qadam o'ngga. Score lar qanchalik to'g'ri tartiblangan bo'lsa, chiziq shuncha ko'p tepaga chiqib oladi va yuqori chap burchakka shuncha yaqin bo'ladi.
Shu nuqtalarni chizamiz. Nuqta yonidagi raqam — jadvaldagi qadam raqami:
plt.figure(figsize=(5, 5))
plt.plot([0, *qadam.FPR], [0, *qadam.TPR], "o-")
for n, (x, t) in enumerate(zip(qadam.FPR, qadam.TPR)):
    plt.annotate(n, (x, t), textcoords="offset points", xytext=(6, -12))
plt.plot([0, 1], [0, 1], "k--")
plt.xlabel("FPR (5 bo'lmaganlarga noto'g'ri \"5\" deyilgan ulush)")
plt.ylabel("TPR = recall (topilgan 5 lar ulushi)")
plt.grid(alpha=0.3)
plt.show()
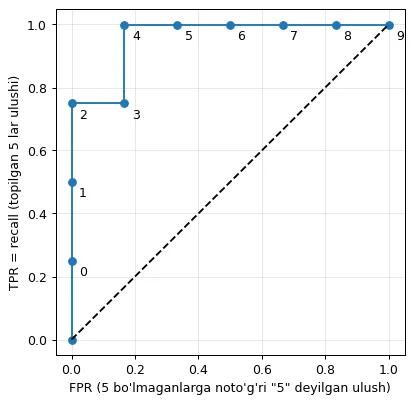
ROC curve ning butun siri shu: u score lar tartibini zinapoya qilib chizadi.
Burchaklar va diagonal nimani bildiradi?
- (0, 0) — threshold juda baland: model hech kimga "5" demaydi. Hech narsa topilmaydi, lekin noto'g'ri signal ham yo'q.
- (1, 1) — threshold juda past: model hammaga "5" deydi. Hamma 5 topiladi, lekin hamma 5 emaslarga ham noto'g'ri "5" deyiladi.
- (0, 1) — yuqori chap burchak: hamma 5 topilgan va bitta ham noto'g'ri signal yo'q. Mukammal model shu nuqtadan o'tadi. Shuning uchun chiziq yuqori chap burchakka qancha yaqin bo'lsa, model shuncha yaxshi.
- Diagonal — tasodifiy model. Score lar tasodifiy bo'lsa, 5 lar va 5 emaslar aralash keladi. Har bir qadam tepaga ham, o'ngga ham bir xil ehtimol bilan bo'ladi va chiziq diagonal bo'ylab ketadi.
Eng muhim fikr: ROC curve dagi har bir nuqta — bitta threshold, ya'ni bitta confusion matrix. Butun chiziq — bitta modelning hamma mumkin bo'lgan matritsalari.
sklearn ning roc_curve funksiyasi xuddi shu ishni qiladi. drop_intermediate=False — hamma nuqtalar qolsin degani (odatda funksiya bitta to'g'ri chiziq ustida yotgan ortiqcha nuqtalarni tashlab yuboradi). Shu yerda AUC uchun kerak bo'ladigan funksiyalarni ham import qilamiz:
from sklearn.metrics import roc_curve, roc_auc_score, auc

fpr, tpr, thr = roc_curve(kichik.haqiqat, kichik.score, drop_intermediate=False)
pd.DataFrame({"threshold": thr, "FPR": fpr, "TPR": tpr})
    threshold       FPR   TPR
0         inf  0.000000  0.00
1      7218.0  0.000000  0.25
2      2128.0  0.000000  0.50
3      1201.0  0.000000  0.75
4       417.0  0.166667  0.75
5     -2316.0  0.166667  1.00
6    -15920.0  0.333333  1.00
7    -16653.0  0.500000  1.00
8    -20004.0  0.666667  1.00
9    -26884.0  0.833333  1.00
10   -33072.0  1.000000  1.00
Natija biz qo'lda hisoblagan jadval bilan bir xil. Faqat boshida bitta qo'shimcha qator bor: threshold = inf (cheksiz). Bu — model hech kimga "5" demaydigan boshlang'ich nuqta (0, 0).
AUC nima?
AUC — Area Under the Curve, ya'ni "egri chiziq ostidagi yuza". Grafik 1 × 1 kvadrat, shuning uchun AUC 0 dan 1 gacha bo'ladi: - mukammal model: chiziq (0, 0) → (0, 1) → (1, 1) bo'ylab ketadi, ostidagi yuza butun kvadrat — 1.0; - tasodifiy model: diagonal, ostidagi yuza kvadratning yarmi — 0.5.
Lekin "yuza" so'zi ko'p narsa demaydi. AUC ning oddiy ma'nosi bor:
AUC — tasodifan olingan bitta 5 ning score i tasodifan olingan bitta 5 emasning score idan katta bo'lish ehtimoli.
Nega bunday? Zinapoyani eslang: 5 — tepaga, 5 emas — o'ngga. Har bir "o'ngga" qadamning ostidagi yuza — shu 5 emasdan oldin turgan (ya'ni undan katta score olgan) 5 lar ulushi. Bu ulushlarni hamma 5 emaslar bo'yicha qo'shsak, to'g'ri tartiblangan juftlar ulushi chiqadi.
Buni tekshiramiz. 4 ta 5 va 6 ta 5 emas — jami 4 × 6 = 24 ta juft. Har bir juftda bitta savol: "5 ning score i kattami?" Qatorlar — 5 larning score lari, ustunlar — 5 emaslarning score lari:
besh = kichik.score[kichik.haqiqat].values
boshqa = kichik.score[kichik.haqiqat == False].values
juftlar = pd.DataFrame(besh[:, None] > boshqa, index=besh, columns=boshqa)
juftlar
          417.0    -15920.0  -16653.0  -20004.0  -26884.0  -33072.0
 7218.0      True      True      True      True      True      True
 2128.0      True      True      True      True      True      True
 1201.0      True      True      True      True      True      True
-2316.0     False      True      True      True      True      True
24 ta katakdan faqat bittasi False: qiyshiq 5 (−2316) va 5 ga o'xshagan 0 (417) juftida 5 emas yuqoriroq score olgan. Bu aynan zinapoyadagi bitta "o'ngga" qadam (3-qadam).
Endi AUC ni uch xil usulda hisoblaymiz:
pd.Series({"to'g'ri tartiblangan juftlar": juftlar.values.sum(),
           "jami juftlar": juftlar.size,
           "ulushi": juftlar.values.mean(),
           "egri ostidagi yuza": auc(fpr, tpr),
           "roc_auc_score": roc_auc_score(kichik.haqiqat, kichik.score)}, dtype=object)
to'g'ri tartiblangan juftlar          23
jami juftlar                          24
ulushi                          0.958333
egri ostidagi yuza              0.958333
roc_auc_score                   0.958333
dtype: object
Uchala usul bir xil javob berdi: 23 / 24 = 0.958.
- juftlarni sanash,
- egri chiziq ostidagi yuzani hisoblash (auc(fpr, tpr)),
- sklearn ning roc_auc_score funksiyasi.
Demak AUC = 0.958 degani: "tasodifan bitta 5 va bitta 5 emas olsak, 95.8% holatda model 5 ga kattaroq score beradi."
Endi butun datasetda tekshiramiz. 5421 × 54 579 — 295 milliondan ortiq juft, hammasini sanash shart emas. 100 000 ta tasodifiy juft olamiz:
rng = np.random.default_rng(42)
besh_score = rng.choice(y_scores[y_train_5], 100_000)
boshqa_score = rng.choice(y_scores[y_train != "5"], 100_000)

pd.Series({"tasodifiy juftlarda to'g'ri tartib": (besh_score > boshqa_score).mean(),
           "roc_auc_score": roc_auc_score(y_train_5, y_scores)})
tasodifiy juftlarda to'g'ri tartib    0.960220
roc_auc_score                         0.960494
dtype: float64
100 000 ta tasodifiy juftning 96.02% ida 5 kattaroq score olgan. roc_auc_score esa 0.9605. Deyarli bir xil. Ya'ni bizning SGD modelning AUC i 0.96 bo'lsa, bu "100 ta tasodifiy juftdan 96 tasida 5 ni to'g'ri yuqoriga qo'yadi" degani.
AUC shkalasi: 0.5 va undan past nima degani?
Uchta holatni solishtiramiz: bizning model, butunlay tasodifiy score lar va bizning score larning teskarisi (minus ishorasi bilan):
pd.Series({"bizning model": roc_auc_score(y_train_5, y_scores),
           "tasodifiy score": roc_auc_score(y_train_5, rng.normal(size=len(y_train_5))),
           "teskari score": roc_auc_score(y_train_5, -y_scores)})
bizning model      0.960494
tasodifiy score    0.494741
teskari score      0.039506
dtype: float64
- 0.96 — bizning model: juftlarning 96% ida tartib to'g'ri.
- 0.49 — tasodifiy score lar: tanga tashlashdek, 50% atrofida. Tasodifiy modelning AUC i 0.5 bo'lishi va diagonal ham shundan.
- 0.04 — teskari score lar: model hamma narsani teskari tartiblaydi. AUC 0.5 dan past bo'lsa, model foydali narsani o'rgangan, lekin javobni teskari bergan: score ishorasini almashtirsak, yana 0.96 bo'ladi. Amalda AUC 0.5 dan past chiqsa, ko'pincha label lar almashib qolgan bo'ladi.
AUC nima uchun kerak: modellarni solishtirish
AUC threshold ga bog'liq emas: u faqat score larning tartibini baholaydi. Threshold qayerga qo'yilmasin, score lar tartibi o'zgarmaydi. Shuning uchun AUC ikki modelni threshold tanlamasdan solishtirishga qulay.
Kitobdagidek SGD ni RandomForest bilan solishtiramiz. RandomForest da decision_function yo'q, uning o'rniga predict_proba bor: har bir rasm uchun ikkita ehtimol ("5 emas" va "5"). Score sifatida "5" bo'lish ehtimolini, ya'ni [:, 1] ustunini olamiz.
Score ning shkalasi har xil bo'lishi (SGD da −33 000 dan +7000 gacha, RandomForest da 0 dan 1 gacha) muammo emas. ROC uchun faqat tartib muhim. Bu katak taxminan 1 minut ishlaydi:
from sklearn.ensemble import RandomForestClassifier

forest_clf = RandomForestClassifier(random_state=42)
y_scores_forest = cross_val_predict(forest_clf, X_train, y_train_5, cv=3, method="predict_proba", n_jobs=-1)[:, 1]
y_scores_forest[:5]
array([0.89, 0.01, 0.04, 0. , 0.01])
Birinchi rasm uchun (u 5) RandomForest 0.89 ehtimol berdi, qolganlari uchun 0 ga yaqin.
Ikkala modelning ROC curve ini bitta grafikda chizamiz. Qizil nuqta — 5-bobda tanlagan threshold imiz (precision 90%):
fpr_sgd, tpr_sgd, thr_sgd = roc_curve(y_train_5, y_scores)
fpr_rf, tpr_rf, _ = roc_curve(y_train_5, y_scores_forest)
nuqta = np.argmax(thr_sgd <= threshold_90)

plt.figure(figsize=(6, 6))
plt.plot(fpr_sgd, tpr_sgd, label=f"SGD (AUC = {roc_auc_score(y_train_5, y_scores):.3f})")
plt.plot(fpr_rf, tpr_rf, label=f"RandomForest (AUC = {roc_auc_score(y_train_5, y_scores_forest):.3f})")
plt.plot([0, 1], [0, 1], "k--", label="tasodifiy (AUC = 0.5)")
plt.plot(fpr_sgd[nuqta], tpr_sgd[nuqta], "ro", label="precision 90% bo'lgan threshold")
plt.xlabel("FPR")
plt.ylabel("TPR (recall)")
plt.legend(loc="lower right")
plt.grid(alpha=0.3)
plt.show()
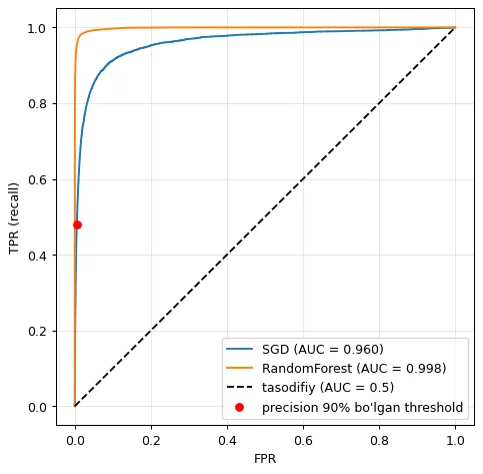
- RandomForest ning chizig'i (to'q sariq) yuqori chap burchakka deyarli yopishib turibdi: AUC 0.998. SGD (ko'k) — 0.960.
- Chiziqlar qanchalik farq qilishini bitta nuqtada aniq son bilan ko'ramiz: 5 emaslarning atigi 1% iga noto'g'ri "5" deyishga ruxsat bersak, har bir model 5 larning necha foizini topadi?
pd.Series({"SGD": np.interp(0.01, fpr_sgd, tpr_sgd), "RandomForest": np.interp(0.01, fpr_rf, tpr_rf)},
          name="FPR = 1% bo'lganda TPR")
SGD             0.601918
RandomForest    0.971103
Name: FPR = 1% bo'lganda TPR, dtype: float64
Bir xil "narx"da (FPR = 1%) SGD 5 larning 60% ini topadi, RandomForest esa 97% ini. ROC curve va AUC aynan shunday farqni ko'rsatish uchun kerak.
ROC dagi nuqta — bu threshold
Qizil nuqta ROC curve ning qayerida turibdi?
pd.Series({"threshold": thr_sgd[nuqta], "FPR": fpr_sgd[nuqta], "TPR": tpr_sgd[nuqta]})
threshold    3370.019499
FPR             0.005295
TPR             0.479985
dtype: float64
Threshold 3370 da FPR = 0.005, TPR = 0.48. Ya'ni bu threshold da 5 emaslarning atigi 0.5% iga noto'g'ri "5" deyiladi va 5 larning 48% i topiladi.
Threshold tanlash — ROC curve dagi bitta nuqtani tanlash demak. Chiziq bo'ylab chapga-pastga yursak, threshold oshadi. O'ngga-yuqoriga yursak, threshold tushadi.
Qisqacha
- ROC curve — threshold ni eng balanddan eng pastgacha surganda hosil bo'ladigan (FPR, TPR) nuqtalari. Har bir nuqta — bitta threshold, bitta confusion matrix.
- AUC — shu chiziq ostidagi yuza. Ma'nosi: tasodifiy 5 tasodifiy 5 emasdan yuqori score olish ehtimoli.
- 1.0 — mukammal, 0.5 — tasodifiy, 0.5 dan past — tartib teskari.
- AUC threshold ga bog'liq emas, shuning uchun modellarni solishtirishga qulay.
Lekin ROC ning bitta muhim kamchiligi bor: kam klass juda kam bo'lsa, ROC haddan tashqari yaxshi ko'rinadi. Buni keyingi qismda ko'ramiz.
Bu bobni bepul o'qidingiz.
Kitob o'rgatadi, lekin sizning kodingiz nega ishlamaganini ayta olmaydi. Kursda uy vazifangiz tekshiriladi.