Confusion matrix
Nega "confusion" deb ataladi?
Inglizchada to confuse — "adashtirmoq", "chalkashtirmoq" degani. Masalan: "I confused 3 with 5" — "3 ni 5 bilan adashtirdim".
Confusion matrix — model qaysi klassni qaysi klass bilan adashtirganini sanaydigan jadval. Har bir katakda bitta savolga javob bor: "haqiqatda A klass bo'lgan rasmlarning nechtasini model B deb aytdi?"
Masalan, 10 ta raqamli masalada 5 lar necha marta 3 deb aytilganini bilish uchun "haqiqat 5" qatori va "bashorat 3" ustuni kesishgan katakka qaraysiz.
Nega test set emas, cross_val_predict?
Matritsa uchun har bir rasmga bashorat kerak. Test set ni oxirigacha ochmaymiz. model.predict(X_train) ham bo'lmaydi: model bu rasmlarni o'qishda ko'rgan, natija haddan tashqari yaxshi chiqadi.
cross_val_predict cross-validation qiladi, lekin baho o'rniga bashoratlarning o'zini qaytaradi. Har bir rasmga bashoratni o'sha rasmni ko'rmagan model beradi. Shuning uchun bu bashoratlar halol: xuddi model hali ko'rmagan yangi rasmlarga bergan javoblardek.
from sklearn.model_selection import cross_val_predict
from sklearn.metrics import confusion_matrix

y_train_pred = cross_val_predict(sgd_clf, X_train, y_train_5, cv=3)
cm = confusion_matrix(y_train_5, y_train_pred)
cm
array([[53892,   687],
       [ 1891,  3530]])
Natija — 2 × 2 jadval, ichida 4 ta son. Ularni to'g'ri o'qish uchun ikkita qoidani bilish kerak.
1-qoida: qatorlar — haqiqat, ustunlar — bashorat
confusion_matrix(y_true, y_pred) da birinchi argument qatorlarga, ikkinchisi ustunlarga aylanadi. Matritsadagi cm[i, j] — haqiqiy klassi i bo'lgan va model j deb aytgan rasmlar soni.
Nega aynan shunday? sklearn hujjatida shunday belgilangan. Argumentlar tartibi (y_true, y_pred), matritsa ham shu tartibda quriladi. Buni yodlash shart emas: funksiyaga birinchi nimani bersangiz, qatorlar o'sha bo'ladi.
2-qoida: klasslar o'sish tartibida
Klasslar saralanadi: False < True (yoki 0 < 1). Shuning uchun birinchi qator va birinchi ustun — False, ya'ni "5 emas". Natijada:
                 bashorat: 5 emas   bashorat: 5
haqiqat: 5 emas        TN               FP
haqiqat: 5             FN               TP
Diqqat: ko'p kitob va Wikipedia matritsani teskari chizadi: TP ni yuqori chapga qo'yadi. Ikkalasi ham to'g'ri, faqat joylashuvi boshqa. Shuning uchun boshqa manbadan rasm ko'rsangiz, avval o'qlarga nima yozilganini o'qing, keyin raqamni talqin qiling. sklearn da TN har doim yuqori chapda turadi.
Yuqoridagi matritsani nomlar bilan chiqaramiz:
pd.DataFrame(cm, index=["haqiqat: 5 emas", "haqiqat: 5"],
             columns=["bashorat: 5 emas", "bashorat: 5"])
                 bashorat: 5 emas  bashorat: 5
haqiqat: 5 emas             53892          687
haqiqat: 5                   1891         3530
Nega TN, FP, FN, TP deb ataladi?
Har bir nom ikki so'zdan iborat va ikkalasi alohida savolga javob beradi:
- Ikkinchi so'z (Positive / Negative) — model nima dedi? Positive = "5", Negative = "5 emas".
- Birinchi so'z (True / False) — model to'g'ri aytdimi? True = to'g'ri, False = xato.
Shunda:
| Nom | Model nima dedi | To'g'rimi | Ma'nosi |
|---|---|---|---|
| TP (True Positive) | 5 | to'g'ri | 5 ni topdi |
| TN (True Negative) | 5 emas | to'g'ri | 5 bo'lmagan rasmga to'g'ri "5 emas" dedi |
| FP (False Positive) | 5 | xato | 5 bo'lmagan rasmni 5 dedi — noto'g'ri signal |
| FN (False Negative) | 5 emas | xato | haqiqiy 5 ni topmadi — o'tkazib yubordi |
Bu qoidani bilsangiz, nomlarni yodlash shart emas. "False Negative" ni eshitsangiz: "model Negative dedi, bu False (xato)" → demak haqiqatda Positive edi → o'tkazib yuborilgan.
Nega "Positive" — yaxshi degani emas?
"Positive" — biz qidirayotgan klass: 5, kasallik, firibgarlik, spam. Tibbiy tahlil "positive" chiqsa, bu kasallik topildi degani. Bemor uchun bu yomon xabar, lekin model uchun u "positive". Qaysi klass positive bo'lishini o'zimiz tanlaymiz: odatda kam uchraydigan va topish muhim bo'lgan klass.
Nega diagonal — to'g'ri javoblar?
Yuqori chapdan pastki o'ngga ketgan diagonalda qator klassi va ustun klassi bir xil: haqiqat "5 emas" — bashorat "5 emas", haqiqat "5" — bashorat "5". Diagonaldan tashqaridagi hamma narsa — xato.
To'rtta raqamni alohida o'zgaruvchilarga olamiz. ravel() matritsani qatorma-qator bitta qatorga yoyadi, shuning uchun tartib har doim TN, FP, FN, TP:
tn, fp, fn, tp = cm.ravel()
pd.Series({"TN": tn, "FP": fp, "FN": fn, "TP": tp})
TN    53892
FP      687
FN     1891
TP     3530
dtype: int64
Qator va ustun yig'indilari nima deydi?
- Qator yig'indisi — haqiqatda nechta bor. 53 892 + 687 = 54 579 ta "5 emas", 1891 + 3530 = 5421 ta "5". Bu 1-bobdagi jadval bilan bir xil. Qator yig'indisi modelga bog'liq emas, u ma'lumotning o'zi.
- Ustun yig'indisi — model nechta marta shunday dedi. Model 687 + 3530 = 4217 marta "5" dedi, 53 892 + 1891 = 55 783 marta "5 emas" dedi. Bu modelga bog'liq.
Bu farq keyin juda muhim bo'ladi: precision ustunga, recall qatorga qaraydi.
Har bir katakda qanday rasmlar bor?
Matritsadagi sonlar faqat nechta xato bo'lganini aytadi. Model qanday rasmlarda adashganini ko'rish uchun har bir katakdan 6 tadan haqiqiy rasm olamiz (kitobdagi 3-2 rasm kabi).
Har bir rasmning nomini 3-bobdagi qoida bo'yicha yasaymiz:
- birinchi harf — model to'g'ri aytdimi: haqiqat bashoratga teng bo'lsa "T", aks holda "F";
- ikkinchi harf — model nima dedi: "5" desa "P", "5 emas" desa "N".
Ikki harfni qo'shsak, har bir rasm uchun "TP", "FP", "FN" yoki "TN" chiqadi:
turi = np.where(y_train_5 == y_train_pred, "T", "F") + np.where(y_train_pred, "P", "N")

fig, axes = plt.subplots(2, 2, figsize=(9, 3.2))
for ax, nom in zip(axes.flat, ["TN", "FP", "FN", "TP"]):
    ax.imshow(np.hstack(X_train[turi == nom][:6].reshape(-1, 28, 28)), cmap="binary")
    ax.set_title(f"{nom}: {(turi == nom).sum()} ta")
    ax.axis("off")
plt.show()
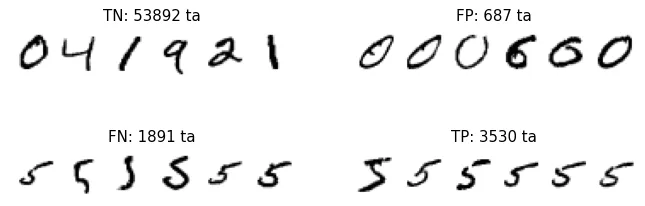
Endi har bir katakda qanday rasmlar borligini ko'rib turibmiz:
- TN — boshqa raqamlar: 0, 4, 1, 9, 2. Model ularga to'g'ri "5 emas" dedi.
- FP — model 5 dedi, lekin bular 0 va 6. Qarang: hammasi yumaloq shakllar. 5 ning pastki qismi ham yumaloq, shuning uchun model adashdi.
- FN — haqiqiy 5 lar, lekin ingichka, qiyshiq yoki g'alati yozilgan. Model ularni tanimadi.
- TP — aniq, odatdagidek yozilgan 5 lar.
Confusion matrix ning eng katta foydasi shu: u faqat "qancha xato" demaydi, qaysi xato ekanini ko'rsatadi. Har bir katakni ochib, real misollarni ko'rish mumkin.
Mukammal model qanday matritsa beradi?
Model hamma rasmga to'g'ri javob bersa, nima bo'ladi? Bashorat sifatida haqiqatning o'zini beramiz:
confusion_matrix(y_train_5, y_train_5)
array([[54579,     0],
       [    0,  5421]])
Faqat diagonalda raqam bor, FP = 0 va FN = 0. Real modelda bunday bo'lmaydi. Lekin maqsad aniq: raqamlarni diagonalga yig'ish.
Rasm ko'rinishi
ConfusionMatrixDisplay xuddi shu matritsani rangli chizadi. Qator va ustun nomlari o'qlarda yozilgan, shuning uchun adashish qiyin:
from sklearn.metrics import ConfusionMatrixDisplay

ConfusionMatrixDisplay.from_predictions(y_train_5, y_train_pred, display_labels=["5 emas", "5"], cmap="Blues")
plt.show()
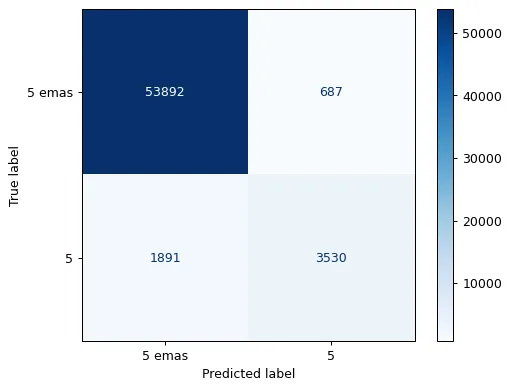
Rang raqamga mos: katta raqam — to'q rang. Diagonaldagi TN juda katta, shuning uchun u eng to'q. Bu ham nomutanosiblikning belgisi: TN qolgan uchta katakdan bir necha barobar katta.
Ko'p uchraydigan xato: argumentlar tartibini almashtirish
Agar confusion_matrix(y_pred, y_true) deb teskari yozsangiz nima bo'ladi?
confusion_matrix(y_train_pred, y_train_5)
array([[53892,  1891],
       [  687,  3530]])
Matritsa transpose bo'ldi, ya'ni qatorlar ustunlarga aylandi: 687 va 1891 joy almashdi. Python hech qanday xato chiqarmaydi, lekin endi FP o'rnida FN, FN o'rnida FP turibdi. Shuning uchun precision va recall ham joy almashib ketadi.
Qoida: har doim (y_true, y_pred) — avval haqiqat, keyin bashorat. sklearn ning barcha metrika funksiyalari shu tartibda ishlaydi.
Bu bobni bepul o'qidingiz.
Kitob o'rgatadi, lekin sizning kodingiz nega ishlamaganini ayta olmaydi. Kursda uy vazifangiz tekshiriladi.