Loyihalar — 7 ta amaliy ish, kod bilan
Loyihalar haqida
Har loyiha 11-bobdagi ocrlib.py va samples/ ustida quriladi va bu yerda to'liq ishlaydigan boshlang'ich kod bilan beriladi: talaba nol dan boshlamaydi, ishlayotgan narsani kengaytiradi. Har kod bloki ostida shu mashinada olingan haqiqiy chiqish. Shaxsiy hujjatlar (pasport, ID, tibbiy karta) hech bir loyihada ishlatilmaydi.
| # | Loyiha | Boblar | Kod | Qiyinlik | Vaqt |
|---|---|---|---|---|---|
| 1 | Skan → matn CLI + sifat o'lchagich | 3, 4, 9 | ocr_cli.py, evaluate.py | ⭐⭐ | 1 hafta |
| 2 | Chek → JSON: regex vs VLM | 4, 6, 9 | receipt.py | ⭐⭐⭐ | 1–2 hafta |
| 3 | Telegram bot: surat → matn | 3, 4, 8 | ocr_service.py, bot.py | ⭐⭐⭐ | 1–2 hafta |
| 4 | Jadval → Excel | 5, 6 | table2xlsx.py | ⭐⭐⭐ | 1–2 hafta |
| 5 | O'zbek lotin/kirill benchmark | 4, 5, 6, 9 | benchmark.py, translit.py | ⭐⭐⭐⭐ | 2 hafta |
| 6 | Eski gazeta arxivi | 3, 4, 8, 9 | archive.py | ⭐⭐⭐⭐ | 2 hafta |
| 7 | Capstone: arxiv → qidiruv | 7–10 + RAG | db.py, ingest.py, search.py, app.py | ⭐⭐⭐⭐⭐ | 3 hafta |
Tavsiya: 1-loyiha hamma uchun, 2–6 dan bittasi tanlab, 7 jamoada. Baholash har loyihada bir xil tamoyilda: ishlaydigan kod, raqamli natija (CER/WER yoki maydon aniqligi), natijani o'qigan xulosa, kod tozaligi. "Ishladi" degan gap ball emas, jadval ball.
Ground truth bepul usuli, hamma loyihada: digital PDF ning matnini
pdfplumberbilan oling (bu haqiqat), xuddi shu sahifani chop etib skanerlang yoki suratga oling. Rasm + to'g'ri matn juftligi tayyor, qo'lda terish yo'q. 11-bob 0-lab buni sun'iy qiladi; real loyihada printer bilan qilinadi.
Papka tuzilishi
ocr_book/projects/
  p1_cli/        ocr_cli.py  evaluate.py
  p2_receipt/    receipt.py
  p3_bot/        ocr_service.py  bot.py
  p4_table/      table2xlsx.py
  p5_benchmark/  benchmark.py  translit.py
  p6_archive/    archive.py
  p7_capstone/   db.py  ingest.py  search.py  app.py
Har fayl boshida:  sys.path.insert(0, ...parents[2])  ->  ocrlib.py ni topadi
1-loyiha: Skan → matn CLI + sifat o'lchagich
Maqsad. Buyruq qatori vositasi: rasm yoki PDF beriladi, matn va confidence qaytadi; yoniga ground truth ustida preprocessing variantlarini solishtiradigan evaluate.py. Bu keyingi hamma loyihaning tayanchi.
Dizayn. PDF bo'lsa sahifama-sahifa text layer tekshiruvi (7-bob), rasm bo'lsa preprocessing (3-bob) va ocr_with_confidence (10-bob), keyin clean_ocr_text (8-bob) va darvoza (8-bob). Har sahifa uchun method, confidence, gate JSON ga yoziladi: bu 7-loyihadagi metadata ning o'zi.
ocr_cli.py
# ocr_cli.py — 1-loyiha: rasm yoki PDF -> matn + confidence. Buyruq qatori vositasi.
#
#   python ocr_cli.py ../../samples/05_telefon_soya.jpg --lang uzb --preprocess adaptive --boxes
#   python ocr_cli.py ../../samples/09_aralash.pdf --lang rus+uzb
#
# Chiqish: out/<fayl>.txt (matn), out/<fayl>.json (sahifa, method, confidence, gate),
#          --boxes bo'lsa out/<fayl>_boxes.png (so'z ramkalari, qizil = conf <= 60)
import argparse
import json
import sys
import time
from pathlib import Path

import cv2

sys.path.insert(0, str(Path(__file__).resolve().parents[2]))          # ocrlib.py shu yerda
from ocrlib import clean_ocr_text, ocr_data, ocr_with_confidence, pdf_page_count, pdf_page_text, preprocess, render_pdf_page, to_gray  # noqa: E402

MIN_CHARS = 100          # text layer bor deb hisoblash chegarasi (7-bob)


def gate(method, conf):
    """8-bob quality gate."""
    if method == "text_layer":
        return "accept"
    if conf >= 80:
        return "accept"
    if conf >= 60:
        return "accept_with_flag"
    return "manual_review"


def prepare(img, args):
    if args.preprocess == "none":
        return to_gray(img)
    return preprocess(img, args.preprocess, do_deskew=not args.no_deskew)


def draw_boxes(gray, lang, psm, out_path):
    canvas = cv2.cvtColor(gray, cv2.COLOR_GRAY2BGR)
    d = ocr_data(gray, lang=lang, psm=psm)
    for x, y, w, h, c, t in zip(d["left"], d["top"], d["width"], d["height"], d["conf"], d["text"]):
        c = int(float(c))
        if c <= 0 or not t.strip():
            continue
        cv2.rectangle(canvas, (x, y), (x + w, y + h), (0, 180, 0) if c > 60 else (0, 0, 255), 3)
    cv2.imwrite(str(out_path), canvas)


def ocr_page(img, args):
    prep = prepare(img, args)
    text, conf = ocr_with_confidence(prep, lang=args.lang, psm=args.psm)
    return (clean_ocr_text(text) if not args.raw else text), conf, prep


def process_file(path, args):
    pages = []
    if path.suffix.lower() == ".pdf":
        for i in range(1, pdf_page_count(path) + 1):
            layer = pdf_page_text(path, i).strip()
            if len(layer) >= MIN_CHARS:
                pages.append({"page": i, "text": layer, "method": "text_layer", "confidence": 100.0})
                continue
            img = render_pdf_page(path, i, dpi=args.dpi)
            text, conf, _ = ocr_page(img, args)
            pages.append({"page": i, "text": text, "method": "ocr_tesseract", "confidence": round(conf, 1)})
    else:
        text, conf, prep = ocr_page(path, args)
        pages.append({"page": 1, "text": text, "method": "ocr_tesseract", "confidence": round(conf, 1)})
        if args.boxes:
            draw_boxes(prep, args.lang, args.psm, args.out / f"{path.stem}_boxes.png")
    for p in pages:
        p["gate"] = gate(p["method"], p["confidence"])
    return pages


def main():
    ap = argparse.ArgumentParser(description="OCR CLI: rasm/PDF -> matn + confidence")
    ap.add_argument("inputs", nargs="+", type=Path)
    ap.add_argument("--lang", default="rus+uzb")
    ap.add_argument("--psm", type=int, default=3)
    ap.add_argument("--preprocess", choices=["none", "otsu", "adaptive"], default="otsu")
    ap.add_argument("--no-deskew", action="store_true")
    ap.add_argument("--dpi", type=int, default=300, help="PDF sahifasini rasmga aylantirish DPI")
    ap.add_argument("--raw", action="store_true", help="clean_ocr_text qo'llanmasin")
    ap.add_argument("--boxes", action="store_true", help="so'z ramkalarini rasmga chizish")
    ap.add_argument("--out", type=Path, default=Path("out"))
    args = ap.parse_args()
    args.out.mkdir(exist_ok=True)

    for path in args.inputs:
        t0 = time.perf_counter()
        pages = process_file(path, args)
        (args.out / f"{path.stem}.txt").write_text("\n\n---\n\n".join(p["text"] for p in pages), encoding="utf-8")
        (args.out / f"{path.stem}.json").write_text(
            json.dumps([{k: v for k, v in p.items() if k != "text"} for p in pages], ensure_ascii=False, indent=1),
            encoding="utf-8")
        print(f"{path.name}: {len(pages)} sahifa, {time.perf_counter() - t0:.1f} s")
        for p in pages:
            print(f"  sahifa {p['page']}: {p['method']:14s} conf={p['confidence']:6.1f} -> {p['gate']:17s} "
                  f"'{p['text'][:50].replace(chr(10), ' ')}...'")


if __name__ == "__main__":
    main()
Chiqish: telefon surati (adaptive, ramkalar bilan) va aralash PDF
05_telefon_soya.jpg: 1 sahifa, 1.9 s
  sahifa 1: ocr_tesseract  conf=  95.8 -> accept            'SHARTNOMA М: 45 Toshkent shahri, 2024-yil 15-yanva...'
09_aralash.pdf: 3 sahifa, 2.5 s
  sahifa 1: text_layer     conf= 100.0 -> accept            'SHARTNOMA № 45 Toshkent shahri, 2024-yil 15-yanvar...'
  sahifa 2: ocr_tesseract  conf=  95.2 -> accept            'ДОГОВОР № 45 г. Ташкент, 15 января 2024 г.  ООО "Н...'
  sahifa 3: ocr_tesseract  conf=  92.7 -> accept            'ЗНАВТМОМА № 45  Toshkent shahri, 2024-yil 15-ya  "...'
05_telefon_soya.json
05_telefon_soya.txt
05_telefon_soya_boxes.png
09_aralash.json
09_aralash.txt
3-sahifadagi ЗНАВТМОМА ga e'tibor bering: --lang rus+uzb bilan Tesseract lotin sarlavhani kirill modeli bilan o'qidi. Aralash tilli PDF da har sahifa uchun til tanlash kerak, yoki o'zbek sahifalarga faqat uzb. 11-bob 4-lab A: keraksiz til qo'shmang.
evaluate.py
# evaluate.py — 1-loyiha: ground_truth/ ustida preprocessing variantlarini solishtirish.
#
#   python evaluate.py --preprocess none otsu adaptive
#   python evaluate.py --preprocess otsu --psm 6 --only chek
#
# Har rasm uchun CER/WER va o'rtacha; --csv bilan jadval faylga.
import argparse
import csv
import sys
import time
from pathlib import Path

sys.path.insert(0, str(Path(__file__).resolve().parents[2]))
from ocrlib import ocr_text, preprocess, score, to_gray  # noqa: E402

ROOT = Path(__file__).resolve().parents[2]
S, G = ROOT / "samples", ROOT / "ground_truth"


def lang_for(name):
    if "kirill" in name or "gazeta" in name:
        return "uzb_cyrl"
    if "rus" in name:
        return "rus"
    return "uzb"


def variant(path, mode, deskew):
    return to_gray(path) if mode == "none" else preprocess(path, mode, do_deskew=deskew)


def main():
    ap = argparse.ArgumentParser()
    ap.add_argument("--preprocess", nargs="+", default=["none", "otsu", "adaptive"])
    ap.add_argument("--psm", type=int, default=3)
    ap.add_argument("--no-deskew", action="store_true")
    ap.add_argument("--only", default="", help="fayl nomida shu so'z bo'lganlar")
    ap.add_argument("--csv", type=Path)
    args = ap.parse_args()

    files = sorted(p for p in S.iterdir() if p.suffix in (".png", ".jpg") and (G / (p.stem + ".txt")).exists()
                   and args.only in p.name)
    table = {p.name: {} for p in files}
    for mode in args.preprocess:
        t0, cers, wers = time.perf_counter(), [], []
        for p in files:
            truth = (G / (p.stem + ".txt")).read_text(encoding="utf-8")
            sc = score(truth, ocr_text(variant(p, mode, not args.no_deskew), lang=lang_for(p.name), psm=args.psm))
            table[p.name][mode] = sc
            cers.append(sc["cer"]); wers.append(sc["wer"])
        print(f"{mode:10s} o'rtacha CER={sum(cers)/len(cers):.3f} WER={sum(wers)/len(wers):.3f} ({time.perf_counter()-t0:.0f} s)")

    print(f"\n{'rasm':22s}" + "".join(f"{m:>14s}" for m in args.preprocess))
    for name, row in table.items():
        print(f"{name:22s}" + "".join(f"{row[m]['cer']:7.3f}/{row[m]['wer']:4.2f} " for m in args.preprocess))
    if args.csv:
        with open(args.csv, "w", newline="", encoding="utf-8") as f:
            w = csv.writer(f)
            w.writerow(["file"] + [f"{m}_{k}" for m in args.preprocess for k in ("cer", "wer")])
            for name, row in table.items():
                w.writerow([name] + [f"{row[m][k]:.4f}" for m in args.preprocess for k in ("cer", "wer")])
        print("CSV:", args.csv)


if __name__ == "__main__":
    main()
Chiqish: cheklar, PSM 6, otsu vs adaptive
otsu       o'rtacha CER=0.109 WER=0.257 (2 s)
adaptive   o'rtacha CER=0.041 WER=0.196 (2 s)

rasm                            otsu      adaptive
10_chek_1.jpg           0.022/0.14   0.045/0.22
10_chek_2.jpg           0.293/0.51   0.048/0.22
10_chek_3.jpg           0.012/0.12   0.031/0.15
CSV: out/chek.csv
Chek 2 telefon surati: otsu 0.293, adaptive 0.048. Chek 1 va 3 skaner: otsu yaxshiroq. Bitta global sozlama yo'q, shuning uchun CLI da --preprocess bayroq va evaluate da jadval.
| Mezon | Ball |
|---|---|
| CLI ishlaydi: rasm, PDF, --boxes, JSON chiqish | 40 |
| evaluate jadvali: kamida 3 variant × 10 fayl, 5 gap xulosa | 30 |
| Preprocessing tanlovi raqam bilan asoslangan | 20 |
| Kod tozaligi, README | 10 |
| Kengaytma: --deskew faqat burchak > 0.5° bo'lsa; --lang auto (kirill/lotin ni aniqlash) | +10 |
2-loyiha: Chek → JSON, regex vs VLM
Maqsad. Chek suratidan {sana, inn, summa, mahsulotlar}. Ikki yo'l yonma-yon: Tesseract + regex (arzon, tushunarli, xatosi ko'rinadi) va VLM + JSON prompt (qulay, lekin to'qishi mumkin). Baholash maydon darajasida, ground_truth/receipts.json bilan.
receipt.py
# receipt.py — 2-loyiha: chek surati -> JSON {sana, summa, inn, mahsulotlar}. Ikki usul yonma-yon:
#   A) Tesseract (PSM 6) + regex     B) VLM + JSON prompt (OLLAMA_HOST ochiq bo'lsa)
# Baholash: ground_truth/receipts.json bilan har maydon bo'yicha to'g'ri/noto'g'ri.
#
#   python receipt.py                 # 3 ta chek, ikkala usul, natija jadvali
import json
import os
import re
import sys
import time
from pathlib import Path

sys.path.insert(0, str(Path(__file__).resolve().parents[2]))
from ocrlib import ocr_text, preprocess  # noqa: E402

ROOT = Path(__file__).resolve().parents[2]
S, G = ROOT / "samples", ROOT / "ground_truth"

DATE = re.compile(r"(\d{2})[./-](\d{2})[./-](\d{4})")
INN = re.compile(r"(?:INN|ИНН|STIR)\s*[:№]?\s*(\d{9})", re.I)
TOTAL = re.compile(r"(?:JAMI|ИТОГО|ИТОГ|TOTAL)\s*[::]?\s*((?:\d[\d ]*\d)|\d)", re.I)
# "Non oq 400g 1 x 4 500": nom ichida raqam bo'lishi mumkin (400g), shuning uchun nom = .+? (eng qisqa),
# keyin miqdor, x (lotin yoki kirill х — OCR ikkalasini beradi), narx
ITEM = re.compile(r"^(?P<name>.+?)\s+(?P<qty>\d{1,2})\s*[xхX×]\s*(?P<price>\d[\d ]*\d)\s*$")


def num(s):
    return int(re.sub(r"\D", "", s))


def extract_regex(text):
    """OCR matnidan maydonlar. Topilmasa None (taxmin qilmaymiz)."""
    d = DATE.search(text)
    inn = INN.search(text)
    total = TOTAL.search(text)
    items = []
    for ln in text.splitlines():
        m = ITEM.match(ln.strip())
        if m:
            items.append([m["name"].strip(), int(m["qty"]), num(m["price"])])
    return {"sana": f"{d[1]}.{d[2]}.{d[3]}" if d else None,
            "inn": inn[1] if inn else None,
            "summa": num(total[1]) if total else None,
            "mahsulotlar": items}


def extract_vlm(image_path, model=os.environ.get("VLM_MODEL", "qwen2.5vl:7b")):
    """6-bob: prompt bilan maydon ajratish. Faqat JSON so'raymiz, topilmagan -> null, taxmin taqiqlanadi."""
    import base64
    from openai import OpenAI
    client = OpenAI(base_url=f"{os.environ.get('OLLAMA_HOST', 'http://localhost:11434')}/v1", api_key="ollama")
    b64 = base64.b64encode(Path(image_path).read_bytes()).decode()
    prompt = ('Bu do\'kon cheki. Faqat JSON qaytar: {"sana": "DD.MM.YYYY", "inn": "9 raqam", "summa": butun son, '
              '"mahsulotlar": [["nomi", miqdor, narx], ...]}. Topilmagan maydon uchun null yoz. Taxmin qilma. '
              'JSON dan boshqa hech narsa yozma.')
    r = client.chat.completions.create(model=model, temperature=0, messages=[{"role": "user", "content": [
        {"type": "text", "text": prompt},
        {"type": "image_url", "image_url": {"url": f"data:image/jpeg;base64,{b64}"}}]}])
    raw = r.choices[0].message.content
    m = re.search(r"\{.*\}", raw, re.S)
    try:
        return json.loads(m.group(0)) if m else {"_xato": raw[:120]}
    except json.JSONDecodeError:
        return {"_xato": raw[:120]}


def compare(pred, truth):
    """Har maydon: to'g'ri (1) yoki yo'q (0). Mahsulotlar: nechtasi nomi va narxi bilan mos."""
    res = {"sana": pred.get("sana") == truth["sana"],
           "inn": str(pred.get("inn")) == truth["inn"],
           "summa": pred.get("summa") == truth["summa"]}
    # mahsulotlar: qat'iy (nom + narx) va yumshoq (faqat narx) — OCR "1L" ni "IL" deb o'qisa nom mos kelmaydi, narx mos keladi
    t_items = {(n.lower(), p) for n, q, p in truth["mahsulotlar"]}
    p_items = {(str(n).lower(), p) for n, q, p in (pred.get("mahsulotlar") or []) if isinstance(p, int)}
    t_prices = sorted(p for _, p in t_items)
    p_prices = sorted(p for _, p in p_items)
    res["mahsulotlar"] = f"{len(t_items & p_items)}/{len(t_items)} (narx: {sum(1 for p in t_prices if p in p_prices)}/{len(t_prices)})"
    return res


def vlm_available(model=os.environ.get("VLM_MODEL", "qwen2.5vl:7b")):
    """Server ochiq VA model yuklangan bo'lsagina True (aks holda 404 bilan yiqilardi)."""
    try:
        import json as _json
        import urllib.request
        tags = _json.load(urllib.request.urlopen(f"{os.environ.get('OLLAMA_HOST', 'http://localhost:11434')}/api/tags", timeout=3))
        return any(m["name"] == model for m in tags["models"])
    except Exception:
        return False


if __name__ == "__main__":
    truths = json.loads((G / "receipts.json").read_text(encoding="utf-8"))
    use_vlm = vlm_available()
    print(f"VLM: {'ochiq' if use_vlm else 'yopiq (faqat regex)'}\n")
    totals = {"regex": {"sana": 0, "inn": 0, "summa": 0}, "vlm": {"sana": 0, "inn": 0, "summa": 0}}
    for t in truths:
        img = S / t["file"]
        mode = "adaptive" if "2" in t["file"] else "otsu"                # 2-chek telefon surati
        t0 = time.perf_counter()
        text = ocr_text(preprocess(img, mode, do_deskew=False), lang="uzb", psm=6)
        pr = extract_regex(text)
        cr = compare(pr, t)
        print(f"{t['file']}  [regex, {time.perf_counter()-t0:.1f} s]  sana={pr['sana']} inn={pr['inn']} summa={pr['summa']} "
              f"mahsulot={len(pr['mahsulotlar'])} -> {cr}")
        for k in ("sana", "inn", "summa"):
            totals["regex"][k] += int(cr[k])
        if use_vlm:
            t0 = time.perf_counter()
            pv = extract_vlm(img)
            cv = compare(pv, t) if "_xato" not in pv else {"xato": pv["_xato"]}
            print(f"{'':14s}  [vlm,   {time.perf_counter()-t0:.1f} s]  sana={pv.get('sana')} inn={pv.get('inn')} "
                  f"summa={pv.get('summa')} mahsulot={len(pv.get('mahsulotlar') or [])} -> {cv}")
            for k in ("sana", "inn", "summa"):
                totals["vlm"][k] += int(bool(cv.get(k)))
    print("\nMaydon aniqligi (3 chekdan):", totals["regex"], "| vlm:", totals["vlm"] if use_vlm else "-")
VLM: ochiq

10_chek_1.jpg  [regex, 0.4 s]  sana=15.01.2024 inn=302145678 summa=95800 mahsulot=5 -> {'sana': True, 'inn': True, 'summa': True, 'mahsulotlar': '4/5 (narx: 5/5)'}
                [vlm,   2.2 s]  sana=15.01.2024 inn=302145678 summa=95800 mahsulot=5 -> {'sana': True, 'inn': True, 'summa': True, 'mahsulotlar': '4/5 (narx: 5/5)'}
10_chek_2.jpg  [regex, 0.4 s]  sana=02.03.2024 inn=305987123 summa=115500 mahsulot=4 -> {'sana': True, 'inn': True, 'summa': True, 'mahsulotlar': '1/4 (narx: 4/4)'}
                [vlm,   1.4 s]  sana=02.03.2024 inn=305987123 summa=115500 mahsulot=4 -> {'sana': True, 'inn': True, 'summa': True, 'mahsulotlar': '0/4 (narx: 4/4)'}
10_chek_3.jpg  [regex, 0.3 s]  sana=27.06.2024 inn=301456789 summa=119500 mahsulot=3 -> {'sana': True, 'inn': True, 'summa': True, 'mahsulotlar': '3/3 (narx: 3/3)'}
                [vlm,   1.4 s]  sana=27.06.2024 inn=301456789 summa=119500 mahsulot=3 -> {'sana': True, 'inn': True, 'summa': True, 'mahsulotlar': '3/3 (narx: 3/3)'}

Maydon aniqligi (3 chekdan): {'sana': 3, 'inn': 3, 'summa': 3} | vlm: {'sana': 3, 'inn': 3, 'summa': 3}
- Sana, INN, summa: regex ham, VLM ham 3/3. Chek uchun asosiy maydonlar regex bilan yechiladi: JAMI, INN va sana formati barqaror.
- Mahsulotlar: bu yerda farq. Regex qatorni
nom miqdor x narxnaqshi bilan oladi; OCR "1L" ni "IL", "1 x" ni "1x" deb o'qisa nom mos kelmaydi, narx mos keladi (shuning uchun ikki ko'rsatkich: qat'iy va narx bo'yicha). VLM esa satrni tushunib ajratadi. Telefon suratida (chek 2) ikkalasi ham qiynaladi. - Talabaga topshiriq: 30 ta haqiqiy chek surati, ularning JSON haqiqati qo'lda (2 soat), keyin shu jadval. Qaysi maydonda VLM ishonch bilan noto'g'ri raqam yozdi? Shu son hisobotning eng muhim raqami (6-bob).
| Mezon | Ball |
|---|---|
| Preprocessing + PSM 6 + regex pipeline | 30 |
| Maydon aniqligi jadvali, 3 usul (regex, VLM, gibrid) | 30 |
| Hallucination tahlili: VLM ning ishonchli noto'g'ri javoblari sanalgan | 20 |
| Kod | 10 |
| Kengaytma: 30 chek → oylik xarajat Excel; [NOANIQ] bilan VLM xatosi kamaydimi | +10 |
3-loyiha: Telegram bot, surat → matn
Maqsad. Foydalanuvchi surat yuboradi, bot matn + confidence + maslahat qaytaradi. Quality gate (8-bob) foydalanuvchi tiliga tarjima qilinadi: "sifat past, qayta suratga oling: yorug'lik, parallel tuting".
Dizayn. OCR mantiqi ocr_service.py da, Telegram siz test qilinadi. bot.py faqat ulash: aiogram 3, surat → vaqtinchalik fayl → asyncio.to_thread (OCR event loop ni bloklamasin) → javob. Xavfsizlik: token faqat muhitdan, fayl ishlagach o'chadi (TemporaryDirectory), daqiqasiga 5 surat, 10 MB chegara.
ocr_service.py
# ocr_service.py — 3-loyiha: botdan ajratilgan "toza" funksiya. Telegram siz ham test qilinadi.
import sys
from pathlib import Path

sys.path.insert(0, str(Path(__file__).resolve().parents[2]))
from ocrlib import clean_ocr_text, ocr_with_confidence, preprocess  # noqa: E402

GOOD, OK = 80, 60


def process_image(path, lang="uzb"):
    """Surat -> {'text', 'conf', 'advice'}. Quality gate (8-bob) foydalanuvchi xabariga aylanadi."""
    prep = preprocess(path, "adaptive")                 # telefon surati: notekis yorug'lik
    text, conf = ocr_with_confidence(prep, lang=lang)
    text = clean_ocr_text(text)
    if not text:
        advice = "Matn topilmadi. Hujjatni to'liq kadrga oling va yorug'roq joyda suratga oling."
    elif conf < OK:
        advice = (f"Sifat past ({conf:.0f}%). Qayta suratga oling: yorug'lik bir tekis bo'lsin, "
                  "telefonni qog'ozga parallel tuting, soyadan qoching.")
    elif conf < GOOD:
        advice = f"O'rtacha sifat ({conf:.0f}%). Raqam va sanalarni tekshirib oling."
    else:
        advice = f"Yaxshi ({conf:.0f}%)."
    return {"text": text, "conf": round(conf, 1), "advice": advice, "words": len(text.split())}


if __name__ == "__main__":
    root = Path(__file__).resolve().parents[2] / "samples"
    for name in ("05_telefon_soya.jpg", "12_dogli.png", "10_chek_2.jpg"):
        r = process_image(root / name)
        print(f"{name}: conf={r['conf']} so'zlar={r['words']} -> {r['advice']}")
        print("   ", r["text"][:80].replace("\n", " "), "...")
bot.py
# bot.py — 3-loyiha: Telegram bot (aiogram 3). Surat -> matn + confidence + maslahat.
#
#   pip install aiogram
#   BOT_TOKEN=123456:ABC... python bot.py
#
# Xavfsizlik: token faqat muhit o'zgaruvchisidan; fayl vaqtinchalik papkada va ishlagach o'chadi;
# foydalanuvchi uchun daqiqasiga RATE_LIMIT surat; 10 MB dan katta fayl qabul qilinmaydi.
import asyncio
import os
import tempfile
import time
from collections import defaultdict
from pathlib import Path

from aiogram import Bot, Dispatcher, F
from aiogram.filters import Command
from aiogram.types import Message

from ocr_service import process_image

RATE_LIMIT = 5                 # surat / daqiqa / foydalanuvchi
MAX_BYTES = 10 * 1024 * 1024
LANGS = {"uz": "uzb", "ru": "rus", "uzk": "uzb_cyrl", "uzru": "rus+uzb"}

dp = Dispatcher()
user_lang = {}                              # user_id -> tesseract lang
hits = defaultdict(list)                    # user_id -> [timestamp, ...]


def rate_limited(user_id):
    now = time.time()
    hits[user_id] = [t for t in hits[user_id] if now - t < 60]
    if len(hits[user_id]) >= RATE_LIMIT:
        return True
    hits[user_id].append(now)
    return False


@dp.message(Command("start"))
async def on_start(message: Message):
    await message.answer("Hujjat suratini yuboring, matnini qaytaraman.\n"
                         "Til: /lang uz (lotin), /lang uzk (kirill), /lang ru, /lang uzru")


@dp.message(Command("lang"))
async def on_lang(message: Message):
    code = (message.text.split(maxsplit=1) + [""])[1].strip().lower()
    if code not in LANGS:
        await message.answer("Variantlar: " + ", ".join(LANGS))
        return
    user_lang[message.from_user.id] = LANGS[code]
    await message.answer(f"Til: {LANGS[code]}")


@dp.message(F.photo)
async def on_photo(message: Message, bot: Bot):
    uid = message.from_user.id
    if rate_limited(uid):
        await message.answer(f"Daqiqasiga {RATE_LIMIT} ta surat. Biroz kuting.")
        return
    photo = message.photo[-1]                             # eng katta o'lcham
    if photo.file_size and photo.file_size > MAX_BYTES:
        await message.answer("Fayl 10 MB dan katta.")
        return
    with tempfile.TemporaryDirectory() as tmp:            # chiqishda papka va fayl o'chadi
        path = Path(tmp) / "in.jpg"
        await bot.download(photo, destination=path)
        result = await asyncio.to_thread(process_image, path, user_lang.get(uid, "uzb"))   # OCR event loop ni bloklamasin
    text = result["text"][:3500] or "(bo'sh)"
    await message.answer(f"{text}\n\n— {result['advice']}")


async def main():
    token = os.environ.get("BOT_TOKEN")
    if not token:
        raise SystemExit("BOT_TOKEN muhit o'zgaruvchisi kerak")
    bot = Bot(token)
    await dp.start_polling(bot)


if __name__ == "__main__":
    asyncio.run(main())
Chiqish: ocr_service 3 ta suratda, bot.py import tekshiruvi
05_telefon_soya.jpg: conf=95.8 so'zlar=143 -> Yaxshi (96%).
    SHARTNOMA М: 45 Toshkent shahri, 2024-yil 15-yanvar  "Nihol" MChJ nomidan direkt ...
12_dogli.png: conf=83.7 so'zlar=143 -> Yaxshi (84%).
    “SHARTNOMA Ne 45 Toshkent shahri, 2024-yil.15-yanvar  "Nihol" MChJ nomidan Anvar ...
10_chek_2.jpg: conf=89.1 so'zlar=38 -> Yaxshi (89%).
    MAKRO MARKET INN 305987123  Sana: 02.03.2024 09:15  Guruch lazer 1kg Yog' IL Kar ...
bot.py import OK, handlers: 3
12_dogli da conf 84 va "Yaxshi", lekin 11-bob 3-labdan bilamiz: shu rasmda CER 0.10 (median siz). Bot preprocess("adaptive") ishlatadi, dog'li skan uchun median kerak. Talabaga birinchi topshiriq: ocr_stats ning past-conf ulushini maslahatga ulash va rasm turiga qarab preprocessing tanlash.
Ishga tushirish
pip install aiogram
export BOT_TOKEN=123456789:AAF...        # @BotFather dan
python bot.py                             # /start, /lang uz|uzk|ru|uzru, surat yuboring
| Mezon | Ball |
|---|---|
| Bot ishlaydi: surat → matn + maslahat, /lang | 30 |
| Yomon suratda to'g'ri maslahat (20 test surat jadvali) | 20 |
| Xavfsizlik ro'yxati: token, fayl o'chirish, limit, hajm | 20 |
| ocr_service testlari (Telegram siz) | 20 |
| Kod | 10 |
| Kengaytma: "qidiruvga qo'sh" tugmasi → 7-loyiha bazasi | +10 |
4-loyiha: Jadval → Excel
Maqsad. Chiziqli jadval skani → .xlsx, katak tuzilishi saqlangan holda. 11-bob 2-labda ko'rdik: Tesseract jadvalda 13 ta so'z topadi, chunki chiziqlarni harf deb o'ylaydi. Ikki yo'l: (A) chiziqlarni morfologiya bilan topib olib tashlash va ularning koordinatalari bilan so'zlarni kataklarga joylash; (B) VLM → Markdown → pandas.
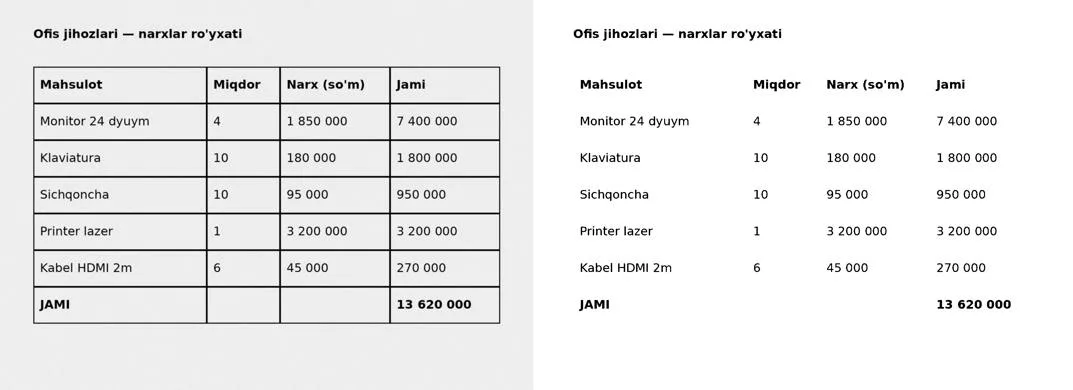
Chapda asl jadval, o'ngda chiziqlar olib tashlangan (MORPH_OPEN uzun gorizontal va vertikal yadro bilan). Chiziqlar koordinatalari katak chegaralari bo'ladi.
table2xlsx.py
# table2xlsx.py — 4-loyiha: jadvalli skan -> .xlsx. Ikki yo'l:
#   A) Tesseract so'z koordinatalari + ustun chegaralarini o'zimiz topamiz (bo'shliq bo'yicha)
#   B) VLM -> Markdown jadval -> pandas (OLLAMA_HOST ochiq bo'lsa)
# Baholash: katak aniqligi = to'g'ri kataklar / jami kataklar (ground_truth/07_jadval.txt)
import os
import re
import sys
import time
from pathlib import Path

import cv2
import numpy as np
import pandas as pd

sys.path.insert(0, str(Path(__file__).resolve().parents[2]))
from ocrlib import ocr_data, preprocess  # noqa: E402

ROOT = Path(__file__).resolve().parents[2]
S, G, OUT = ROOT / "samples", ROOT / "ground_truth", Path("out")
OUT.mkdir(exist_ok=True)


# ---------- A) Tesseract: avval jadval chiziqlarini topamiz, keyin so'zlarni kataklarga joylaymiz ----------
def grid_lines(binary, frac=12):
    """Uzun gorizontal/vertikal chiziqlar (morfologiya). Qaytaradi: chiziqlar maskasi, ustun x lari, qator y lari."""
    inv = 255 - binary                                   # matn va chiziqlar oq
    h, w = inv.shape
    horiz = cv2.morphologyEx(inv, cv2.MORPH_OPEN, cv2.getStructuringElement(cv2.MORPH_RECT, (w // frac, 1)))
    vert = cv2.morphologyEx(inv, cv2.MORPH_OPEN, cv2.getStructuringElement(cv2.MORPH_RECT, (1, h // frac)))

    def positions(profile, min_run=3):
        pos, start = [], None
        for i, v in enumerate(profile):
            if v and start is None:
                start = i
            elif not v and start is not None:
                if i - start >= min_run:
                    pos.append((start + i) // 2)
                start = None
        return pos
    xs = positions((vert.sum(axis=0) > 0.3 * 255 * h))     # ustun chiziqlari
    ys = positions((horiz.sum(axis=1) > 0.3 * 255 * w))    # qator chiziqlari
    return cv2.bitwise_or(horiz, vert), xs, ys


def tesseract_table(binary, lang="uzb"):
    """1) chiziqlarni olib tashlaymiz (Tesseract ularni harf deb o'ylaydi)  2) so'zlar -> (qator, ustun) katak."""
    grid, xs, ys = grid_lines(binary)
    no_lines = cv2.bitwise_or(binary, cv2.dilate(grid, np.ones((3, 3), np.uint8)))   # chiziq o'rni oq bo'ladi
    d = ocr_data(no_lines, lang=lang, psm=11)                   # siyrak matn: har so'z alohida
    if len(xs) < 2 or len(ys) < 2:
        return [], no_lines
    cells = {}
    for i, t in enumerate(d["text"]):
        if int(float(d["conf"][i])) <= 0 or not t.strip():
            continue
        cx, cy = d["left"][i] + d["width"][i] / 2, d["top"][i] + d["height"][i] / 2
        col = sum(1 for x in xs if cx > x) - 1
        row = sum(1 for y in ys if cy > y) - 1
        if 0 <= col < len(xs) - 1 and 0 <= row < len(ys) - 1:
            cells.setdefault((row, col), []).append((d["left"][i], t))
    table = []
    for r in range(len(ys) - 1):
        table.append([" ".join(t for _, t in sorted(cells.get((r, c), []))) for c in range(len(xs) - 1)])
    return table, no_lines


# ---------- B) VLM -> Markdown ----------
def markdown_table_to_rows(md):
    rows = []
    for ln in md.splitlines():
        ln = ln.strip()
        if not ln.startswith("|") or re.match(r"^\|?\s*:?-{2,}", ln):
            continue
        rows.append([c.strip() for c in ln.strip("|").split("|")])
    return rows


def vlm_table(image_path, model=os.environ.get("VLM_MODEL", "qwen2.5vl:7b")):
    import base64
    from openai import OpenAI
    client = OpenAI(base_url=f"{os.environ.get('OLLAMA_HOST', 'http://localhost:11434')}/v1", api_key="ollama")
    b64 = base64.b64encode(Path(image_path).read_bytes()).decode()
    r = client.chat.completions.create(model=model, temperature=0, messages=[{"role": "user", "content": [
        {"type": "text", "text": "Rasmdagi jadvalni Markdown jadval qilib qaytar. Sarlavha qatorini ham. Boshqa hech narsa yozma."},
        {"type": "image_url", "image_url": {"url": f"data:image/png;base64,{b64}"}}]}])
    return r.choices[0].message.content


# ---------- umumiy ----------
def rows_to_xlsx(rows, path):
    width = max(len(r) for r in rows)
    rows = [r + [""] * (width - len(r)) for r in rows]
    pd.DataFrame(rows[1:], columns=[c or f"col{i}" for i, c in enumerate(rows[0])]).to_excel(path, index=False)


def norm(s):
    return re.sub(r"\s+", "", str(s)).lower().replace("'", "").replace("’", "")


def cell_accuracy(pred, truth):
    """Har haqiqiy katak bashoratda (o'z qatorida) bormi. Raqamli kataklar alohida sanaladi."""
    total = num_total = hit = num_hit = 0
    for i, trow in enumerate(truth):
        prow = pred[i] if i < len(pred) else []
        pcells = {norm(c) for c in prow}
        for c in trow:
            if not c:
                continue
            total += 1
            is_num = bool(re.fullmatch(r"[\d ]+", c))
            num_total += is_num
            if norm(c) in pcells:
                hit += 1
                num_hit += is_num
    return hit, total, num_hit, num_total


if __name__ == "__main__":
    truth = [ln.split(" | ") for ln in (G / "07_jadval.txt").read_text(encoding="utf-8").splitlines()]
    img = preprocess(S / "07_jadval.png", "otsu", do_deskew=False)

    t0 = time.perf_counter()
    rows_a, no_lines = tesseract_table(img)
    cv2.imwrite(str(OUT / "jadval_chiziqsiz.png"), no_lines)
    rows_to_xlsx(rows_a, OUT / "jadval_tesseract.xlsx")
    h, t, nh, nt = cell_accuracy(rows_a, truth)
    print(f"A) Tesseract + chiziqlar bo'yicha kataklar: {len(rows_a)} qator, kataklar {h}/{t}, raqamli {nh}/{nt}  ({time.perf_counter()-t0:.1f} s)")
    for r in rows_a[:4]:
        print("   ", r)

    try:
        import urllib.request
        urllib.request.urlopen(f"{os.environ.get('OLLAMA_HOST', 'http://localhost:11434')}/api/tags", timeout=3)
        t0 = time.perf_counter()
        md = vlm_table(S / "07_jadval.png")
        rows_b = markdown_table_to_rows(md)
        rows_to_xlsx(rows_b, OUT / "jadval_vlm.xlsx")
        h, t, nh, nt = cell_accuracy(rows_b, truth)
        print(f"B) VLM Markdown:               {len(rows_b)} qator, kataklar {h}/{t}, raqamli {nh}/{nt}  ({time.perf_counter()-t0:.1f} s)")
        for r in rows_b[:4]:
            print("   ", r)
    except Exception as e:
        print(f"B) VLM o'tkazib yuborildi: {type(e).__name__}")
    print("Excel fayllar:", sorted(p.name for p in OUT.glob("*.xlsx")))
A) Tesseract + chiziqlar bo'yicha kataklar: 7 qator, kataklar 24/26, raqamli 14/16  (0.2 s)
    ['Mahsulot', 'Miqdor', "Narx (so'm)", 'Jami']
    ['Monitor 24 dyuym', '4', '1850 000', '7 400 000']
    ['Klaviatura', '10', '180 000', '1800 000']
    ['Sichqoncha', '10', '95 000', '950 000']
B) VLM Markdown:               7 qator, kataklar 26/26, raqamli 16/16  (3.4 s)
    ['Mahsulot', 'Miqdor', "Narx (so'm)", 'Jami']
    ['Monitor 24 dyuym', '4', '1 850 000', '7 400 000']
    ['Klaviatura', '10', '180 000', '1 800 000']
    ['Sichqoncha', '10', '95 000', '950 000']
Excel fayllar: ['jadval_tesseract.xlsx', 'jadval_vlm.xlsx']
- A yo'li 0/26 dan (bo'shliq bo'yicha ustun ajratish, birinchi urinish) 24/26 ga chiqdi. Ikki xato:
1 850 000→1850 000(raqam ichidagi bo'shliq). Raqamli kataklar 14/16. Bu Tesseract ning haqiqiy imkoniyati: jadval chiziqlarini olib tashlasangiz, u jadvalni o'qiydi. - B yo'li 26/26, 3.4 s (GPU). Jadval VLM ning kuchli tomoni (6-bob). Lekin: confidence yo'q; 20 ta jadvaldan bittasida raqam to'qilsa, buni faqat ground truth topadi.
- Talabaga: 15 jadval (chiziqli, chiziqsiz, telefon surati). Chiziqsiz jadvalda A yo'li ishlamaydi: ustunlarni so'z x-koordinatalarini klasterlab topish kerak (proyeksiya, 6-loyihadagi kabi).
| Mezon | Ball |
|---|---|
| Ikki yo'l ishlaydi, Excel to'g'ri | 30 |
| Katak aniqligi jadvali, 15 sahifa × 2 yo'l | 30 |
| Raqamli kataklar alohida tahlili | 20 |
| Chiziqsiz jadval uchun ustun klasterlash | 10 |
| Kod | 10 |
| Kengaytma: birlashgan kataklar (merged cells) | +10 |
5-loyiha: O'zbek lotin / kirill benchmark
Maqsad. O'zbek matni uchun qaysi dvigatel yaxshi, raqam bilan: Tesseract (uzb, uzb_cyrl), EasyOCR (en/ru, o'zbek yo'q), Qwen2.5-VL. Yoniga belgi darajasidagi xato tahlili (qaysi harf qaysi harfga almashadi) va kirill → lotin transliteratsiya.
translit.py
# translit.py — 5-loyiha: o'zbek kirill -> lotin. Qoidaga asoslangan, lug'atsiz.
# Nozik joylar: е so'z boshida/unlidan keyin "ye", ц -> "ts", ъ -> ' (tutuq belgisi), ь tashlanadi.
import re

VOWELS = "аеёиоуўэюяАЕЁИОУЎЭЮЯ"
MAP = {
    "а": "a", "б": "b", "в": "v", "г": "g", "д": "d", "ё": "yo", "ж": "j", "з": "z", "и": "i", "й": "y",
    "к": "k", "л": "l", "м": "m", "н": "n", "о": "o", "п": "p", "р": "r", "с": "s", "т": "t", "у": "u",
    "ф": "f", "х": "x", "ц": "ts", "ч": "ch", "ш": "sh", "щ": "sh", "ъ": "'", "ь": "", "э": "e", "ю": "yu",
    "я": "ya", "ў": "o'", "қ": "q", "ғ": "g'", "ҳ": "h",
}


IOTATED = "еёюяЕЁЮЯ"


def _one(ch, prev, nxt):
    lower = ch.lower()
    if lower == "е":
        # so'z boshida, unlidan keyin va ъ/ь dan keyin "ye": етти -> yetti, объект -> obyekt
        out = "ye" if (prev is None or prev in VOWELS or prev.lower() in "ъь" or not prev.isalpha()) else "e"
    elif lower == "ъ" and nxt is not None and nxt in IOTATED:
        out = ""                       # объект -> obyekt: tutuq belgisi yozilmaydi, е o'zi "ye" bo'ladi
    else:
        out = MAP.get(lower, ch)
    return out.capitalize() if ch.isupper() and out else out


def cyr2lat(text):
    out = []
    for i, ch in enumerate(text):
        prev = text[i - 1] if i > 0 else None
        nxt = text[i + 1] if i + 1 < len(text) else None
        out.append(_one(ch, prev, nxt))
    return "".join(out)


if __name__ == "__main__":
    tests = [("Тошкент шаҳри", "Toshkent shahri"), ("ўзбек тили", "o'zbek tili"), ("Ғафур Ғулом", "G'afur G'ulom"),
             ("етказиб бериш", "yetkazib berish"), ("шартнома", "shartnoma"), ("Қуйидагилар ҳақида", "Quyidagilar haqida"),
             ("объект", "obyekt"), ("санъат", "san'at"), ("цирк", "tsirk"), ("Ёзилган", "Yozilgan")]
    for src, want in tests:
        got = cyr2lat(src)
        print(("OK " if got == want else "!! ") + f"{src} -> {got}" + ("" if got == want else f"  (kutilgan: {want})"))
Chiqish: translit testlari
OK Тошкент шаҳри -> Toshkent shahri
OK ўзбек тили -> o'zbek tili
OK Ғафур Ғулом -> G'afur G'ulom
OK етказиб бериш -> yetkazib berish
OK шартнома -> shartnoma
OK Қуйидагилар ҳақида -> Quyidagilar haqida
OK объект -> obyekt
OK санъат -> san'at
OK цирк -> tsirk
OK Ёзилган -> Yozilgan
benchmark.py
# benchmark.py — 5-loyiha: o'zbek lotin va kirill uchun uch dvigatelni raqam bilan solishtirish.
#   Tesseract (uzb / uzb_cyrl), EasyOCR (en / ru — o'zbek yo'q), VLM (OLLAMA_HOST ochiq bo'lsa)
# Chiqish: CER/WER/vaqt matritsasi, eng ko'p adashadigan belgilar, kirill OCR + translit tajribasi.
import difflib
import os
import sys
import time
from collections import Counter
from pathlib import Path

sys.path.insert(0, str(Path(__file__).resolve().parents[2]))
from ocrlib import normalize, ocr_text, preprocess, score  # noqa: E402
from translit import cyr2lat  # noqa: E402

ROOT = Path(__file__).resolve().parents[2]
S, G = ROOT / "samples", ROOT / "ground_truth"

LATIN = ["03_uzb_lotin.png", "05_telefon_soya.jpg", "06_qiyshiq.png", "11_past_dpi.png", "12_dogli.png"]
CYRIL = ["04_uzb_kirill.png", "14_gazeta_1.png", "14_gazeta_3.png"]


def truth_of(name):
    return (G / (Path(name).stem + ".txt")).read_text(encoding="utf-8")


def mode_for(name):
    return "adaptive" if "telefon" in name else "otsu"


# ---------- dvigatellar ----------
def tesseract_engine(script):
    lang = "uzb" if script == "lotin" else "uzb_cyrl"
    return lambda name: ocr_text(preprocess(S / name, mode_for(name)), lang=lang)


def easyocr_engine(script):
    import easyocr
    reader = easyocr.Reader(["en"] if script == "lotin" else ["ru"], gpu=False, verbose=False)
    return lambda name: "\n".join(r[1] for r in reader.readtext(str(S / name)) if r[2] > 0.3)


def vlm_engine(model=os.environ.get("VLM_MODEL", "qwen2.5vl:7b")):
    import base64
    import io
    from openai import OpenAI
    from PIL import Image
    client = OpenAI(base_url=f"{os.environ.get('OLLAMA_HOST', 'http://localhost:11434')}/v1", api_key="ollama")

    def run(name):
        im = Image.open(S / name).convert("RGB")
        im.thumbnail((1600, 1600))
        buf = io.BytesIO()
        im.save(buf, format="PNG")
        b64 = base64.b64encode(buf.getvalue()).decode()
        # 11-bob 6-lab: yumshoq prompt bilan model lotinni kirillga o'giradi. Qat'iy prompt + ``` qavslarni olib tashlash.
        prompt = ("Rasmdagi matnni AYNAN yozilganidek ko'chir: qaysi alifboda bo'lsa (lotin yoki kirill) shu alifboda, "
                  "tarjima qilma, alifboni o'zgartirma, imloni tuzatma. Qatorlarni saqla. Markdown, ``` qavslar, izoh qo'shma.")
        r = client.chat.completions.create(model=model, temperature=0, messages=[{"role": "user", "content": [
            {"type": "text", "text": prompt},
            {"type": "image_url", "image_url": {"url": f"data:image/png;base64,{b64}"}}]}])
        import re as _re
        return _re.sub(r"^```[a-z]*\s*|\s*```$", "", r.choices[0].message.content.strip(), flags=_re.M)
    return run


def confusions(truth, pred, top=8):
    """Qaysi belgi qaysi belgiga almashgan (SequenceMatcher 'replace' bloklari, 1-2 belgili)."""
    t, p = normalize(truth), normalize(pred)
    c = Counter()
    for tag, i1, i2, j1, j2 in difflib.SequenceMatcher(None, t, p, autojunk=False).get_opcodes():
        if tag == "replace" and i2 - i1 <= 2 and j2 - j1 <= 2:
            c[(t[i1:i2], p[j1:j2])] += 1
    return c.most_common(top)


def evaluate(engine, files, label):
    cers, wers, t0, conf = [], [], time.perf_counter(), Counter()
    for name in files:
        pred = engine(name)
        sc = score(truth_of(name), pred)
        cers.append(sc["cer"]); wers.append(sc["wer"])
        for k, v in confusions(truth_of(name), pred):
            conf[k] += v
    dt = (time.perf_counter() - t0) / len(files)
    print(f"  {label:22s} CER={sum(cers)/len(cers):.3f}  WER={sum(wers)/len(wers):.3f}  {dt:5.1f} s/sahifa   "
          f"xatolar: {', '.join(f'{a}->{b}({n})' for (a, b), n in conf.most_common(4))}")
    print("  " + " " * 22 + "sahifalar: " + "  ".join(f"{n[:12]}={c:.3f}" for n, c in zip(files, cers)))
    return cers


def available(kind):
    if kind == "easyocr":
        try:
            import easyocr  # noqa: F401
            return True
        except ImportError:
            return False
    if kind == "vlm":
        try:
            import json
            import urllib.request
            tags = json.load(urllib.request.urlopen(f"{os.environ.get('OLLAMA_HOST', 'http://localhost:11434')}/api/tags", timeout=3))
            return any(m["name"] == os.environ.get("VLM_MODEL", "qwen2.5vl:7b") for m in tags["models"])
        except Exception:
            return False


if __name__ == "__main__":
    for script, files in (("lotin", LATIN), ("kirill", CYRIL)):
        print(f"\n== {script} ({len(files)} sahifa)")
        evaluate(tesseract_engine(script), files, "Tesseract")
        if available("easyocr"):
            evaluate(easyocr_engine(script), files, "EasyOCR (en/ru)")
        if available("vlm"):
            evaluate(vlm_engine(), files, "VLM")

    print("\n== Translit tajribasi: kirill OCR -> lotin, lotin haqiqat bilan solishtirish")
    # 04_uzb_kirill va 03_uzb_lotin bir xil shartnoma: kirill OCR ni lotinga o'girib, lotin haqiqatga solishtiramiz
    pred = cyr2lat(ocr_text(preprocess(S / "04_uzb_kirill.png", "otsu"), lang="uzb_cyrl"))
    truth_lat = truth_of("03_uzb_lotin.png")
    sc = score(truth_lat, pred)
    print(f"  kirill OCR + translit vs lotin haqiqat: CER={sc['cer']:.3f} WER={sc['wer']:.3f}")
    sc2 = score(truth_lat, ocr_text(preprocess(S / "03_uzb_lotin.png", "otsu"), lang="uzb"))
    print(f"  to'g'ridan-to'g'ri lotin OCR:           CER={sc2['cer']:.3f} WER={sc2['wer']:.3f}")
    print("  farq: imlo (йил/yil, 2024 йил/2024-yil) va translit qoidalari, OCR emas —", confusions(truth_lat, pred, 5))
  w_ih = torch.quantize_per_tensor(

== lotin (5 sahifa)
  Tesseract              CER=0.017  WER=0.083    1.0 s/sahifa   xatolar: .->:(4),  ->-(3), .->,(3), №->Ne(2)
                        sahifalar: 03_uzb_lotin=0.002  05_telefon_s=0.002  06_qiyshiq.p=0.003  11_past_dpi.=0.002  12_dogli.png=0.076
  EasyOCR (en/ru)        CER=0.120  WER=0.273    5.9 s/sahifa   xatolar: .->:(21), o->0(16), №->Ne(4), ,->;(4)
                        sahifalar: 03_uzb_lotin=0.024  05_telefon_s=0.036  06_qiyshiq.p=0.465  11_past_dpi.=0.015  12_dogli.png=0.060
  VLM                    CER=0.394  WER=0.432    5.0 s/sahifa   xatolar: o->о(5), ji->жи(3), va->ва(2), z->з(2)
                        sahifalar: 03_uzb_lotin=0.013  05_telefon_s=0.004  06_qiyshiq.p=0.001  11_past_dpi.=1.087  12_dogli.png=0.863

== kirill (3 sahifa)
  Tesseract              CER=0.225  WER=0.290    0.8 s/sahifa   xatolar: ·->:(2), №->М(1), ь->ъ(1)
                        sahifalar: 04_uzb_kiril=0.002  14_gazeta_1.=0.015  14_gazeta_3.=0.657
  EasyOCR (en/ru)        CER=0.502  WER=0.712    6.8 s/sahifa   xatolar: қ->к(11), ҳ->х(11), ў->у(11), ў->й(3)
                        sahifalar: 04_uzb_kiril=0.055  14_gazeta_1.=0.736  14_gazeta_3.=0.715
  VLM                    CER=0.171  WER=0.345    3.9 s/sahifa   xatolar: ҳ->х(8), ў->у(7), қ->к(6), ў->ү(4)
                        sahifalar: 04_uzb_kiril=0.264  14_gazeta_1.=0.162  14_gazeta_3.=0.086

== Translit tajribasi: kirill OCR -> lotin, lotin haqiqat bilan solishtirish
  kirill OCR + translit vs lotin haqiqat: CER=0.174 WER=0.245
  to'g'ridan-to'g'ri lotin OCR:           CER=0.002 WER=0.007
  farq: imlo (йил/yil, 2024 йил/2024-yil) va translit qoidalari, OCR emas — [(('-', ' '), 4), (('H', 'h'), 1), (('№', 'M'), 1)]
- Lotin, o'rtacha: Tesseract 0.017, EasyOCR 0.120, VLM 0.394. Lekin o'rtacha aldaydi, sahifalar qatoriga qarang. VLM toza skan, telefon surati va hatto 3° qiyshiq sahifada 0.001–0.013 (Tesseract darajasida, deskew siz). ~50 DPI (11) va dog'li (12) sahifalarda esa 1.09 va 0.86: matn kirillga o'tib ketadi (
o→о,ji→жи) yoki to'qiladi. Qat'iy prompt toza rasmda ishladi, buzilgan rasmda ishlamadi. VLM past sifatli rasmni "taxmin" qiladi, 6-bob aynan shuni aytgan edi. EasyOCR ning o'z zaif joyi: qiyshiq sahifa (06) 0.465, deskew siz neyron detection ham adashadi. - Kirill, o'rtacha: Tesseract 0.225, EasyOCR 0.502, VLM 0.171. Yana sahifalarga qarang: toza kirill skanda (04) Tesseract 0.002, VLM 0.264 (ў қ ғ ҳ → у к х, rus harflariga), EasyOCR 0.055 (ў қ ғ ҳ hammasi yo'q). Gazeta 3-sahifada esa teskari: Tesseract 0.657 (ustunlar birlashgan), VLM 0.086, chunki VLM layout ni tushunadi. Xulosa: o'zbek kirill harflari uchun Tesseract
uzb_cyrl, murakkab layout uchun VLM yoki 6-loyihadagi ustun ajratish. - Translit. Kirill OCR + translit ni lotin haqiqat bilan solishtirganda CER 0.17, lekin xatolar OCR emas: imlo (
2024 йил/2024-yil,№). Xulosa: transliteratsiya alifbo almashtirish, imlo emas; lotin hujjat kerak bo'lsa lotin OCR.
| Mezon | Ball |
|---|---|
| Ground truth to'plami (20 lotin + 20 kirill) va evaluate | 25 |
| 3 dvigatel × 2 alifbo × (skan/surat) jadvali | 25 |
| Belgi xatolari tahlili (confusion) | 20 |
| Translit tajribasi va xulosa | 15 |
| 2 sahifalik hisobot | 15 |
| Kengaytma: Tesseract ni uzb uchun fine-tune (tesstrain), CER qancha tushdi | +10 |
6-loyiha: Eski gazeta arxivi
Maqsad. Sarg'aygan, ikki ustunli, orqa tomoni ko'rinadigan gazeta sahifalari → toza, qidiriladigan matn. Uch muammo: og'ir preprocessing, ustunli layout, takrorlanadigan kolontitul.
Dizayn. (1) Preprocessing zanjiri, har qadamdan keyin CER: qaysi qadam foyda, qaysi zarar. (2) Tesseract avtomatik layout ni tekshirish: 11-bob 9-labda 3 sahifadan 2 tasida ikki ustun bitta bo'lib o'qilgan (CER 0.61, 0.66). Yechim: vertikal proyeksiya (har x da nechta qora piksel) bilan ustunlar orasidagi eng keng oq bo'shliqni topib, sahifani sarlavha + chap + o'ng ga bo'lish, har bo'lakni PSM 6 bilan. (3) Sahifalar orasida takrorlangan qatorlar = kolontitul.
archive.py
# archive.py — 6-loyiha: eski gazeta (sarg'aygan, ikki ustun, orqa tomon ko'rinadi) -> toza matn.
#   1) preprocessing zanjiri, har qadamdan keyin CER    2) ustunlarni o'zimiz ajratamiz (proyeksiya)
#   3) sahifalar orasida takrorlangan qatorlar (kolontitul) olib tashlanadi   4) txt + metadata.json
import json
import re
import sys
from pathlib import Path

import cv2
import numpy as np

sys.path.insert(0, str(Path(__file__).resolve().parents[2]))
from ocrlib import clean_ocr_text, deskew, ocr_text, ocr_with_confidence, score, to_gray  # noqa: E402

ROOT = Path(__file__).resolve().parents[2]
S, G, OUT = ROOT / "samples", ROOT / "ground_truth", Path("out")
OUT.mkdir(exist_ok=True)
LANG = "uzb_cyrl"
PAGES = ["14_gazeta_1.png", "14_gazeta_2.png", "14_gazeta_3.png"]


# ---------- 1) zanjir ----------
def chain(gray):
    """Har qadam (nom, rasm) qaytaradi — qaysi qadam foyda berganini o'lchash uchun."""
    steps = [("kulrang", gray)]
    med = cv2.medianBlur(gray, 3)
    steps.append(("+ medianBlur(3)", med))
    _, otsu = cv2.threshold(med, 0, 255, cv2.THRESH_BINARY + cv2.THRESH_OTSU)
    steps.append(("+ Otsu", otsu))
    kernel = cv2.getStructuringElement(cv2.MORPH_RECT, (2, 2))
    opened = cv2.morphologyEx(otsu, cv2.MORPH_CLOSE, kernel)     # oq fon ichidagi mayda qora nuqtalar (bleed qoldig'i)
    steps.append(("+ morph CLOSE 2x2", opened))
    steps.append(("+ deskew", deskew(opened)))
    return steps


# ---------- 2) ustunlar ----------
def split_columns(binary, min_gap=40, margin=0.15, header=0.08, footer=0.92):
    """Sahifa: sarlavha tasmasi (ikki ustunga cho'zilgan) + tana (ustunlar) + sahifa raqami.
    Tana uchun vertikal proyeksiya: har x da nechta qora piksel; o'rtadagi eng keng oq bo'shliq = ustunlar orasi.
    Qaytaradi: [sarlavha, chap ustun, o'ng ustun] (yoki ustun topilmasa [sarlavha, tana])."""
    h, w = binary.shape
    head, body = binary[:int(h * header), :], binary[int(h * header):int(h * footer), :]
    ink = (body < 128).sum(axis=0)
    lo, hi = int(w * margin), int(w * (1 - margin))
    cur_start, gaps = None, []
    for x in range(lo, hi):
        if ink[x] == 0:
            cur_start = x if cur_start is None else cur_start
        elif cur_start is not None:
            gaps.append((x - cur_start, cur_start, x))
            cur_start = None
    if not gaps or max(gaps)[0] < min_gap:
        return [head, body]
    _, a, b = max(gaps)
    mid = (a + b) // 2
    return [head, body[:, :mid], body[:, mid:]]


def ocr_columns(binary):
    parts = split_columns(binary)
    texts = [ocr_text(p, lang=LANG, psm=6) for p in parts]          # har bo'lak: bitta yaxlit blok
    return "\n\n".join(t.strip() for t in texts if t.strip()), len(parts) - 1


# ---------- 3) kolontitul ----------
def remove_repeated_lines(pages_text, min_pages=2):
    norm = lambda s: re.sub(r"\W+", "", s).lower()
    count = {}
    for text in pages_text:
        for ln in {norm(l) for l in text.splitlines() if l.strip()}:
            count[ln] = count.get(ln, 0) + 1
    repeated = {k for k, v in count.items() if v >= min_pages and len(k) > 10}
    out = []
    for text in pages_text:
        kept = [l for l in text.splitlines() if norm(l) not in repeated]
        out.append("\n".join(kept))
    return out, repeated


if __name__ == "__main__":
    print("1) Preprocessing zanjiri, har qadamdan keyingi CER (PSM 3, avtomatik layout):")
    print(f"   {'qadam':20s}" + "".join(f"{p[:-4]:>14s}" for p in PAGES) + "    o'rtacha")
    chains = {p: chain(to_gray(S / p)) for p in PAGES}
    means = []
    for i, (name, _) in enumerate(chains[PAGES[0]]):
        row = [score((G / (p[:-4] + ".txt")).read_text(encoding="utf-8"), ocr_text(chains[p][i][1], lang=LANG))["cer"]
               for p in PAGES]
        means.append(sum(row) / len(row))
        print(f"   {name:20s}" + "".join(f"{c:14.3f}" for c in row) + f"{means[-1]:12.3f}")
    best = min(range(len(means)), key=means.__getitem__)
    print(f"   -> eng yaxshi qadam: '{chains[PAGES[0]][best][0]}'. Undan keyingi qadamlar zarar qildi, ularni tashlaymiz.")
    finals = {p: chains[p][best][1] for p in PAGES}

    print("\n2) Ustunlarni proyeksiya bilan ajratish (PSM 6 har ustunga) vs avtomatik (PSM 3):")
    pages_text, meta = [], []
    for p in PAGES:
        truth = (G / (p[:-4] + ".txt")).read_text(encoding="utf-8")
        auto = ocr_text(finals[p], lang=LANG)
        manual, ncol = ocr_columns(finals[p])
        _, conf = ocr_with_confidence(finals[p], lang=LANG)
        print(f"   {p}: auto CER={score(truth, auto)['cer']:.3f}   ustunlar={ncol} CER={score(truth, manual)['cer']:.3f}   conf={conf:.1f}")
        pages_text.append(manual)
        meta.append({"file": p, "columns": ncol, "confidence": round(conf, 1)})

    print("\n3) Takrorlangan qatorlar (kolontitul) va sahifa raqamlari:")
    cleaned, repeated = remove_repeated_lines(pages_text)
    print("   olib tashlandi:", [r[:40] for r in repeated])
    for p, text, m in zip(PAGES, cleaned, meta):
        final = clean_ocr_text(text)
        (OUT / (p[:-4] + ".txt")).write_text(final, encoding="utf-8")
        m["chars"] = len(final)
    (OUT / "metadata.json").write_text(json.dumps(meta, ensure_ascii=False, indent=1), encoding="utf-8")
    print("   yozildi:", sorted(f.name for f in OUT.iterdir()))
    print("   1-sahifa boshi:", repr(clean_ocr_text(cleaned[0])[:100]))
1) Preprocessing zanjiri, har qadamdan keyingi CER (PSM 3, avtomatik layout):
   qadam                  14_gazeta_1   14_gazeta_2   14_gazeta_3    o'rtacha
   kulrang                      0.022         0.615         0.663       0.433
   + medianBlur(3)              0.023         0.617         0.663       0.434
   + Otsu                       0.017         0.610         0.657       0.428
   + morph CLOSE 2x2            0.046         0.612         0.659       0.439
   + deskew                     0.046         0.612         0.659       0.439
   -> eng yaxshi qadam: '+ Otsu'. Undan keyingi qadamlar zarar qildi, ularni tashlaymiz.

2) Ustunlarni proyeksiya bilan ajratish (PSM 6 har ustunga) vs avtomatik (PSM 3):
   14_gazeta_1.png: auto CER=0.017   ustunlar=2 CER=0.017   conf=94.0
   14_gazeta_2.png: auto CER=0.610   ustunlar=2 CER=0.024   conf=93.7
   14_gazeta_3.png: auto CER=0.657   ustunlar=2 CER=0.026   conf=93.5

3) Takrorlangan qatorlar (kolontitul) va sahifa raqamlari:
   olib tashlandi: ['тошкентоқшоми1994йил12мартм2481123']
   yozildi: ['14_gazeta_1.txt', '14_gazeta_2.txt', '14_gazeta_3.txt', 'metadata.json']
   1-sahifa boshi: 'Шаҳар ҳокимлиги янги йўл қурилиши тўғрисида қарор қабул қилди. Чилонзор туманидаги марказий кўчалард'
- Zanjir. Otsu eng yaxshi qadam. Undan keyingi
morphologyExzarar qildi (0.017 → 0.046): 2×2 yadro mayda dog'lar bilan birga harf chiziqlarini ham yeydi. Kitob 3-bobda "orqa tomon ko'rinishi → morph OPEN" deydi; bu sahifada median + Otsu bleed-through ni o'zi yo'qotgan, morph ortiqcha. Har qadamni o'lchash shuning uchun. - Ustunlar. 1-sahifa: auto 0.017 = manual 0.017. 2- va 3-sahifa: auto 0.61 va 0.66, manual 0.024 va 0.026. Bir xil dizayn, uch sahifa, Tesseract ikkitasida adashdi. Ustunlarni o'zingiz ajratsangiz natija barqaror.
- Kolontitul. Faqat sarlavha qatori ("ТОШКЕНТ ОҚШОМИ · 1994 йил...") takrorlangan va olib tashlangan. Birinchi versiyada 3 sahifa bir xil maqolalar bilan yasalgan edi va detektor butun matnni "kolontitul" deb o'chirdi: test ma'lumoti real bo'lishi kerak.
| Mezon | Ball |
|---|---|
| Zanjir tajribasi jadvali, har qadam CER bilan | 30 |
| Ustun ajratish: auto vs manual, 3+ sahifa | 20 |
| Kolontitul detektori | 15 |
| Chiqish: txt + metadata.json | 15 |
| VLM bilan eng yomon 3 sahifa solishtiruvi | 10 |
| Kod | 10 |
| Kengaytma: 1990-yillar imlosi uchun lug'at post-processing | +10 |
7-loyiha: Capstone, skanerlangan arxiv → qidiruv tizimi
Maqsad. Aralash hujjatlar to'plami (digital PDF, skan, telefon surati, jadval, gazeta) → 10-bob pipeline → SQLite (matn + metadata + FTS5 indeks) → qidiruv interfeysi. Javobda manba sahifa, extraction_method va confidence belgisi. Admin uchun "ko'rib chiqish" navbati. Bu butun kitobning amaldagi ko'rinishi.
Dizayn. To'rt fayl, har biri bitta vazifa. db.py: sxema, FTS5 (unicode61 tokenizer kirill va lotinni bir xil ishlaydi), snippet() va bm25(). ingest.py: har fayl → sahifalar → Otsu, past bo'lsa adaptive, darvoza manual_review desa va VLM bor bo'lsa VLM (asl rasm bilan) → gate bilan bazaga. search.py: buyruq qatori. app.py: Streamlit, ikki tab.
db.py
# db.py — 7-loyiha: SQLite + FTS5. pages jadvali (matn + metadata) va to'liq matnli indeks.
import sqlite3
from datetime import datetime

SCHEMA = """
CREATE TABLE IF NOT EXISTS documents (
    id INTEGER PRIMARY KEY, filename TEXT UNIQUE, pages INTEGER, created TEXT);
CREATE TABLE IF NOT EXISTS pages (
    id INTEGER PRIMARY KEY, doc_id INTEGER REFERENCES documents(id), page_num INTEGER,
    text TEXT, method TEXT, confidence REAL, gate TEXT, review_status TEXT DEFAULT 'none');
CREATE VIRTUAL TABLE IF NOT EXISTS pages_fts USING fts5(
    text, content='pages', content_rowid='id', tokenize='unicode61 remove_diacritics 0');
CREATE TRIGGER IF NOT EXISTS pages_ai AFTER INSERT ON pages BEGIN
    INSERT INTO pages_fts(rowid, text) VALUES (new.id, new.text); END;
CREATE TRIGGER IF NOT EXISTS pages_ad AFTER DELETE ON pages BEGIN
    INSERT INTO pages_fts(pages_fts, rowid, text) VALUES ('delete', old.id, old.text); END;
"""


def connect(path="archive.db"):
    con = sqlite3.connect(path)
    con.row_factory = sqlite3.Row
    con.executescript(SCHEMA)
    return con


def add_document(con, filename, n_pages):
    con.execute("DELETE FROM pages WHERE doc_id IN (SELECT id FROM documents WHERE filename=?)", (filename,))
    con.execute("DELETE FROM documents WHERE filename=?", (filename,))
    cur = con.execute("INSERT INTO documents(filename, pages, created) VALUES (?,?,?)",
                      (filename, n_pages, datetime.now().isoformat(timespec="seconds")))
    return cur.lastrowid


def add_page(con, doc_id, page_num, text, method, confidence, gate):
    con.execute("INSERT INTO pages(doc_id, page_num, text, method, confidence, gate) VALUES (?,?,?,?,?,?)",
                (doc_id, page_num, text, method, confidence, gate))


def search(con, query, limit=10, min_conf=0):
    """FTS5 MATCH + snippet. min_conf: faqat ishonchli sahifalar (8-bob: filtering)."""
    sql = """SELECT p.id, d.filename, p.page_num, p.method, p.confidence, p.gate,
                    snippet(pages_fts, 0, '[', ']', '…', 12) AS snip, bm25(pages_fts) AS rank
             FROM pages_fts JOIN pages p ON p.id = pages_fts.rowid JOIN documents d ON d.id = p.doc_id
             WHERE pages_fts MATCH ? AND p.confidence >= ? ORDER BY rank LIMIT ?"""
    return con.execute(sql, (query, min_conf, limit)).fetchall()


def flagged(con):
    return con.execute("""SELECT p.id, d.filename, p.page_num, p.method, p.confidence, p.gate, p.review_status, substr(p.text, 1, 300) AS preview
                          FROM pages p JOIN documents d ON d.id = p.doc_id
                          WHERE p.gate != 'accept' ORDER BY p.confidence""").fetchall()


def set_review(con, page_id, status):
    con.execute("UPDATE pages SET review_status=? WHERE id=?", (status, page_id))
    con.commit()


def stats(con):
    return con.execute("""SELECT COUNT(*) AS pages, SUM(method='text_layer') AS text_layer,
                                 SUM(method LIKE 'ocr%') AS ocr, SUM(gate!='accept') AS flagged FROM pages""").fetchone()
ingest.py
# ingest.py — 7-loyiha: samples/ dagi PDF va rasmlar -> 10-bob pipeline -> SQLite.
#   python ingest.py                 # hamma faylni qayta o'qiydi, archive.db ni yangilaydi
import base64
import io
import json
import os
import sys
import time
import urllib.request
from pathlib import Path

sys.path.insert(0, str(Path(__file__).resolve().parents[2]))
from ocrlib import clean_ocr_text, ocr_stats, pdf_page_count, pdf_page_text, preprocess, quality_gate, render_pdf_page  # noqa: E402
import db  # noqa: E402

ROOT = Path(__file__).resolve().parents[2]
S = ROOT / "samples"
MIN_CHARS = 100
HOST = os.environ.get("OLLAMA_HOST", "http://localhost:11434")
VLM_MODEL = os.environ.get("VLM_MODEL", "qwen2.5vl:7b")
VLM_PROMPT = ("Rasmdagi matnni AYNAN yozilganidek ko'chir: qaysi alifboda bo'lsa shu alifboda, tarjima qilma, "
              "imloni tuzatma. Qator va paragraflarni saqla. Markdown, ``` qavslar, izoh qo'shma. "
              "Aniq o'qiy olmagan joyni [NOANIQ] deb belgila, taxmin qilma.")


def vlm_ready():
    try:
        tags = json.load(urllib.request.urlopen(f"{HOST}/api/tags", timeout=3))
        return any(m["name"] == VLM_MODEL for m in tags["models"])
    except Exception:
        return False


def vlm_ocr(img):
    """10-bob vlm_ocr: asl rasm (binar emas) VLM ga."""
    from openai import OpenAI
    client = OpenAI(base_url=f"{HOST}/v1", api_key="ollama")
    im = img if hasattr(img, "save") else __import__("PIL.Image").Image.open(img)
    im = im.convert("RGB")
    im.thumbnail((1600, 1600))
    buf = io.BytesIO()
    im.save(buf, format="PNG")
    b64 = base64.b64encode(buf.getvalue()).decode()
    r = client.chat.completions.create(model=VLM_MODEL, temperature=0, messages=[{"role": "user", "content": [
        {"type": "text", "text": VLM_PROMPT},
        {"type": "image_url", "image_url": {"url": f"data:image/png;base64,{b64}"}}]}])
    text = r.choices[0].message.content.strip()
    return text.strip("`").removeprefix("markdown").strip()


def lang_for(name):
    if "kirill" in name or "gazeta" in name:
        return "uzb_cyrl"
    if "rus" in name:
        return "rus"
    return "uzb"


def ocr_image(img, lang, use_vlm):
    """Otsu -> (past bo'lsa) adaptive -> (darvoza 'manual_review' desa va VLM bo'lsa) VLM. 7- va 10-boblar."""
    best = None
    for mode in ("otsu", "adaptive"):
        text, st = ocr_stats(preprocess(img, mode), lang=lang)
        if best is None or st["low_ratio"] < best[1]["low_ratio"]:
            best = (text, st, mode)
        if quality_gate("ocr_tesseract", st) == "accept":
            break
    text, st, mode = best
    g = quality_gate("ocr_tesseract", st)
    # qaytish tartibi extract() bilan bir xil: (text, method, conf, gate, stats)
    if g == "manual_review" and use_vlm:
        return clean_ocr_text(vlm_ocr(img)), "ocr_vlm", -1.0, "accept_with_flag", st
    return clean_ocr_text(text), "ocr_tesseract", st["conf"], g, st


def extract(path, use_vlm):
    """Fayl -> [(page_num, text, method, conf, gate, stats)] — 10-bob extract_pdf, rasmlar bilan."""
    lang = lang_for(path.name)
    if path.suffix.lower() == ".pdf":
        out = []
        for i in range(1, pdf_page_count(path) + 1):
            layer = pdf_page_text(path, i).strip()
            if len(layer) >= MIN_CHARS:
                out.append((i, layer, "text_layer", 100.0, "accept", {}))
            else:
                out.append((i, *ocr_image(render_pdf_page(path, i, dpi=200), "rus" if i == 2 else lang, use_vlm)))
        return out
    from PIL import Image
    return [(1, *ocr_image(Image.open(path), lang, use_vlm))]


if __name__ == "__main__":
    use_vlm = vlm_ready()
    print("VLM fallback: " + (f"yoqilgan ({VLM_MODEL})" if use_vlm else "yo'q"))
    con = db.connect("archive.db")
    files = sorted(p for p in S.iterdir() if p.suffix.lower() in (".pdf", ".png", ".jpg"))
    t0 = time.perf_counter()
    for path in files:
        pages = extract(path, use_vlm)
        doc_id = db.add_document(con, path.name, len(pages))
        for page_num, text, method, conf, g, st in pages:
            if text.strip():
                db.add_page(con, doc_id, page_num, text, method, round(conf, 1), g)
        con.commit()
        desc = ", ".join(f"{m}({c:.0f}, low={st.get('low_ratio', 0):.0%}, {g})" for _, _, m, c, g, st in pages)
        print(f"  {path.name:22s} {desc}")
    s = db.stats(con)
    print(f"\nJami {time.perf_counter()-t0:.0f} s: {s['pages']} sahifa, text_layer={s['text_layer']}, ocr={s['ocr']}, flagged={s['flagged']}")
search.py
# search.py — 7-loyiha: buyruq qatoridan qidiruv (FTS5: bir nechta so'z = hammasi bo'lishi shart, OR ham bo'ladi).
#   python search.py "ofis jihozlari"             python search.py "ҳокимлиги" --min-conf 70
#   python search.py "Nestle OR Kartoshka"        python search.py "shartn*"      (prefiks)
import argparse

import db

if __name__ == "__main__":
    ap = argparse.ArgumentParser()
    ap.add_argument("query")
    ap.add_argument("--min-conf", type=float, default=0)
    ap.add_argument("--limit", type=int, default=5)
    args = ap.parse_args()
    con = db.connect("archive.db")
    rows = db.search(con, args.query, args.limit, args.min_conf)
    print(f"'{args.query}': {len(rows)} natija (min_conf={args.min_conf})")
    for r in rows:
        badge = "✅" if r["gate"] == "accept" else "⚠️"
        print(f"  {badge} {r['filename']} sahifa {r['page_num']}  [{r['method']}, conf={r['confidence']:.0f}]")
        print(f"     …{r['snip']}…")
    print("\nFlagged (admin ko'rigi):", [(f['filename'], f['page_num'], f['confidence']) for f in db.flagged(con)][:6])
app.py
# app.py — 7-loyiha: Streamlit interfeys. Qidiruv (confidence belgisi bilan) + Admin (flagged sahifalar).
#   streamlit run app.py
from pathlib import Path

import streamlit as st

import db

ROOT = Path(__file__).resolve().parents[2]
con = db.connect("archive.db")
st.set_page_config(page_title="Skanerlangan arxiv", layout="wide")
st.title("Skanerlangan arxiv — qidiruv")

tab_search, tab_admin = st.tabs(["Qidiruv", "Admin: ko'rib chiqish"])

with tab_search:
    q = st.text_input("So'rov", placeholder="masalan: shartnoma summa")
    min_conf = st.slider("Minimal confidence", 0, 100, 0, help="8-bob: faqat ishonchli manbalar")
    if q:
        rows = db.search(con, q, limit=10, min_conf=min_conf)
        st.caption(f"{len(rows)} natija")
        for r in rows:
            badge = "🟢" if r["gate"] == "accept" else "🟡" if r["gate"] == "accept_with_flag" else "🔴"
            st.markdown(f"{badge} **{r['filename']}**, sahifa {r['page_num']} · `{r['method']}` · conf {r['confidence']:.0f}")
            st.write("…" + r["snip"] + "…")
            if r["method"] != "text_layer":
                st.caption("Skanerlangan hujjatdan olindi, xato bo'lishi mumkin.")

with tab_admin:
    s = db.stats(con)
    st.write(f"Sahifalar: {s['pages']} · text layer: {s['text_layer']} · OCR: {s['ocr']} · ko'rib chiqish kerak: {s['flagged']}")
    for f in db.flagged(con):
        with st.expander(f"{f['filename']} sahifa {f['page_num']} — {f['gate']} (conf {f['confidence']:.0f}) [{f['review_status']}]"):
            col1, col2 = st.columns(2)
            img = ROOT / "samples" / f["filename"]
            if img.suffix.lower() in (".png", ".jpg"):
                col1.image(str(img), width=350)
            col2.text(f["preview"])
            c1, c2 = col2.columns(2)
            if c1.button("Tasdiqlash", key=f"ok{f['id']}"):
                db.set_review(con, f["id"], "approved")
                st.rerun()
            if c2.button("Qayta skanerlash kerak", key=f"re{f['id']}"):
                db.set_review(con, f["id"], "rescan")
                st.rerun()
Chiqish: ingest (VLM fallback bilan) va uchta qidiruv
VLM fallback: yoqilgan (qwen2.5vl:7b)
  01_digital.pdf         text_layer(100, low=0%, accept)
  02_skan_rus.pdf        ocr_tesseract(95, low=0%, accept)
  02_skan_rus.png        ocr_tesseract(95, low=0%, accept)
  03_uzb_lotin.png       ocr_tesseract(95, low=1%, accept)
  04_uzb_kirill.png      ocr_tesseract(94, low=1%, accept)
  05_telefon_soya.jpg    ocr_tesseract(96, low=0%, accept)
  06_qiyshiq.png         ocr_tesseract(95, low=1%, accept)
  07_jadval.png          ocr_tesseract(91, low=5%, accept_with_flag)
  09_aralash.pdf         text_layer(100, low=0%, accept), ocr_tesseract(95, low=0%, accept), ocr_tesseract(93, low=3%, accept)
  10_chek_1.jpg          ocr_tesseract(94, low=0%, accept)
  10_chek_2.jpg          ocr_tesseract(93, low=0%, accept)
  10_chek_3.jpg          ocr_tesseract(94, low=0%, accept)
  11_past_dpi.png        ocr_tesseract(95, low=0%, accept)
  12_dogli.png           ocr_vlm(-1, low=12%, accept_with_flag)
  13_xira_raqam.png      ocr_tesseract(95, low=1%, accept)
  14_gazeta_1.png        ocr_tesseract(94, low=3%, accept)
  14_gazeta_2.png        ocr_tesseract(94, low=3%, accept_with_flag)
  14_gazeta_3.png        ocr_tesseract(94, low=0%, accept)
  15_juda_xira.jpg       ocr_vlm(-1, low=12%, accept_with_flag)

Jami 33 s: 21 sahifa, text_layer=2, ocr=19, flagged=4
'ofis jihozlari': 1 natija (min_conf=0)
  ⚠️ 07_jadval.png sahifa 1  [ocr_tesseract, conf=91]
     …[Ofis] [jihozlari] — narxlar ro'yxati

Monitor 24 dyuym 1 850 000 7……

Flagged (admin ko'rigi): [('12_dogli.png', 1, -1.0), ('15_juda_xira.jpg', 1, -1.0), ('07_jadval.png', 1, 91.4), ('14_gazeta_2.png', 1, 93.9)]
'ҳокимлиги': 1 natija (min_conf=70.0)
  ✅ 14_gazeta_1.png sahifa 1  [ocr_tesseract, conf=94]
     ……Ме 48 (1123)

Шаҳар [ҳокимлиги] янги йўл қурилиши тўғрисида қарор қабул қилди……

Flagged (admin ko'rigi): [('12_dogli.png', 1, -1.0), ('15_juda_xira.jpg', 1, -1.0), ('07_jadval.png', 1, 91.4), ('14_gazeta_2.png', 1, 93.9)]
'Nestle OR Kartoshka': 2 natija (min_conf=0)
  ✅ 10_chek_2.jpg sahifa 1  [ocr_tesseract, conf=93]
     ……02.03.2024 69

Guruch lazer 1Кд Yog' IL [Kartoshka] 1Кд

Sabzi……
  ✅ 10_chek_1.jpg sahifa 1  [ocr_tesseract, conf=94]
     ……x 4 500 Sut IL [Nestle] 2 х 14 900 Tuxum 10……

Flagged (admin ko'rigi): [('12_dogli.png', 1, -1.0), ('15_juda_xira.jpg', 1, -1.0), ('07_jadval.png', 1, 91.4), ('14_gazeta_2.png', 1, 93.9)]
- Darvoza ishlayapti. 21 sahifadan 4 tasi belgilandi. Juda xira surat (15) va dog'li skan (12) past-conf ulushi 12% bilan
manual_reviewga tushdi va VLM bilan qayta o'qildi (ocr_vlm, har doimaccept_with_flag, admin navbatida). Jadval (07, past-conf 5%) va gazeta 2 (3%)accept_with_flag: qidiruv natijasida ⚠️ bilan chiqadi. Toza skanlar va cheklaraccept. - Darvoza ushlamaydigan narsa. Gazeta 3: conf 94, past-conf 0%,
accept, matni esa ikki ustun aralashgan holda (11-bob 9-lab: CER 0.66). Xira band tashlab yuborilgan sahifa (13): conf 95,accept, 16 ta so'z yo'q. Confidence layout xatosini va yo'qolgan matnni ko'rmaydi. Yechim: hujjat turini bilish (jadval → 4-loyiha yo'li, gazeta → 6-loyiha yo'li), so'zlar sonini kutilgan bilan solishtirish, yoki VLM bilan ikkinchi o'qish. Bu capstone ning ochiq vazifasi. - FTS5. Bir nechta so'z = hammasi shu sahifada bo'lishi shart ("shartnoma summa" 0 natija berdi, chunki matnda "summa" so'zi yo'q, "qiymati" bor).
ORva prefiks (shartn*) bor. Embedding qidiruv (RAG kursi) shu yerga ulanadi: "summa" so'rovi "qiymati" ni topadi. - Streamlit ilovasi bu mashinada
--server.headlessbilan ishga tushdi (HTTP 200, healthok). Admin tabida flagged sahifalar rasm va matn bilan, ikkita tugma: tasdiqlash / qayta skanerlash.
Ishga tushirish
cd projects/p7_capstone
python ingest.py                          # samples/ -> archive.db (VLM: OLLAMA_HOST, VLM_MODEL muhitdan)
python search.py "ofis jihozlari"
streamlit run app.py                      # http://localhost:8501
| Hafta | Ish | Natija |
|---|---|---|
| 1 | ingest: sahifama-sahifa, PageResult → SQLite, flagged jadvali; 20 sahifa ground truth da CER | archive.db, CER hisoboti |
| 2 | qidiruv: FTS5 (yoki pgvector, RAG kursi); tozalangan matnda chunking; natijada method + conf | search.py |
| 3 | interfeys: qidiruv sahifasi, admin navbati, min-conf filtri; 20 savol → recall@5, skan sahifalar bilan va ularsiz | app.py, hisobot |
| Mezon | Ball |
|---|---|
| Pipeline to'liq, sahifama-sahifa, VLM fallback | 25 |
| Qidiruv ishlaydi, metadata ko'rinadi | 25 |
| Admin review oqimi | 15 |
| CER va recall hisoboti | 20 |
| Kod tuzilishi, README | 15 |
| Kengaytma: VLM sahifalarini ikki marta o'qitib solishtirish; 3-loyiha boti shu bazaga yozadi | +10 |
Hamma loyiha uchun umumiy talablar
- README: nima qiladi, qanday ishga tushiriladi, qaysi bob qaysi funksiyada.
- Kod alohida fayllarda (
preprocess,ocr,evaluate,main), 800 qatorli bitta fayl emas. - Har raqam qayta hisoblanadigan:
python evaluate.pybitta buyruq bilan jadvalni chiqarsin. - Maxfiylik: shaxsiy hujjat repo ga kirmaydi,
.gitignoredasamples/private/. - Himoya 10 daqiqa: istalgan funksiyani tushuntirish, jonli ishga tushirish, bitta parametrni o'zgartirib natijani bashorat qilish.
Xulosa
| Loyiha | Eng muhim raqam |
|---|---|
| 1 CLI | Chek 2: otsu 0.29, adaptive 0.05 — bitta global sozlama yo'q |
| 2 Chek | Sana/INN/summa: regex 3/3; mahsulotlar: VLM yaxshi, lekin confidence siz |
| 3 Bot | conf 84 va CER 0.10 bir vaqtda: maslahat past-conf ulushiga qarasin |
| 4 Jadval | Chiziqlar olib tashlangach Tesseract 24/26; VLM 26/26 |
| 5 Benchmark | Kirill: EasyOCR va VLM ў қ ғ ҳ ni yo'qotadi; Tesseract uzb_cyrl saqlaydi |
| 6 Gazeta | Auto layout 3 dan 2 sahifada adashdi (0.61, 0.66); o'z column-split 0.02 |
| 7 Capstone | Darvoza xira sahifani ushladi, jadval va ustun xatosini ushlamadi |
Bu bobni bepul o'qidingiz.
Kitob o'rgatadi, lekin sizning kodingiz nega ishlamaganini ayta olmaydi. Kursda uy vazifangiz tekshiriladi.