Laboratoriya — har bob uchun jonli tajriba (o'qituvchi uchun)
Bu bob nima va qanday ishlatiladi
1–10-boblar nima va nega ni tushuntirdi. Bu bob ko'rsatadi: har bob uchun bitta laboratoriya ishi, to'liq kod bilan, va kodning haqiqiy chiqishi bilan. Quyidagi barcha chiqishlar 2026-09-08 kuni shu muhitda ishga tushirilgan: WSL Ubuntu 22.04, Python 3.10, Tesseract 4.1.1 (tessdata_fast: rus, uzb, uzb_cyrl), OpenCV 5.0, PyMuPDF 1.28, EasyOCR (CPU), Ollama 0.30 + qwen2.5vl:7b (NVIDIA RTX 5070 Ti). Raqamlar sizning mashinangizda biroz farq qilishi mumkin, xulosalar farq qilmaydi.
Dars kitobni o'qib berish emas. Har lab uchun bir xil ritm: muammo (2 min, ishlamaydigan holat) → jonli demo (7 min, siz kodni yozasiz) → buzish (3 min, yomon rasm yoki noto'g'ri parametr) → tuzatish (3 min) → talaba ishi (5 min, bitta parametrni o'zgartirib qayta ishga tushiradi) → xulosa jadvali (2 min). Beshinchi qadam majburiy: talaba o'zi 5 daqiqa kod ishga tushirmasa, bob esda qolmaydi.
| Dars | Lablar | Boblar | Asosiy lahza |
|---|---|---|---|
| 1 | 0, 1, 2, 3 | 1–3 | Bo'sh extract_text(); ramkalar; adaptive threshold soyani yengadi |
| 2 | 4, 5 | 4–5 | Noto'g'ri til = 79% xato; PSM 11 chekni buzadi; EasyOCR ў қ ғ ҳ ni yo'qotadi |
| 3 | 6, 7 | 6–7 | VLM jadvalni 27/28 o'qiydi, lekin lotinni kirillga o'giradi; sahifama-sahifa PDF |
| 4 | 8, 9 | 8–10 | Tozalash; conf 85 bilan CER 0.31; hamma variantni bitta jadvalda o'lchash |
| 5+ | 12-bob | loyihalar | 7 ta loyiha, kod bilan |
Fayllar tuzilishi (hammasi bitta papkada, ocrlib.py yonida):
Papka tuzilishi
ocr_book/
  ocrlib.py                 3, 4, 8, 9, 10-boblardagi funksiyalar bitta faylda (quyida)
  tessdata/                 rus, uzb, uzb_cyrl, eng, osd .traineddata (apt siz ishlatish uchun)
  lab00_make_samples.py     samples/ va ground_truth/ ni sun'iy yasaydi
  lab01_check_env.py        muhit tekshiruvi (darsdan oldin)
  lab02_boxes.py ... lab09_evaluate.py
  samples/                  17 ta test fayl (PDF, PNG, JPG)
  ground_truth/             har rasm uchun to'g'ri matn (.txt) + receipts.json
  out/                      chiqishlar, ramkali rasmlar, jadvallar
  projects/                 12-bob loyihalari
ocrlib.py — umumiy funksiyalar
Har lab bitta faylni import qiladi. Undagi funksiyalar 3-bob (deskew, preprocess), 4-bob (ocr_text, ocr_data), 10-bob (ocr_with_confidence), 8-bob (clean_ocr_text), 9-bob (score) va 7-bob (render_pdf_page, PyMuPDF bilan, poppler shart emas) dan olingan. Ikki joy kitobdan farq qiladi, ikkalasi ham laboratoriyada topilgan:
- Bo'g'in ko'chirish regexi
([\w'])-\n(\w): o'zbekchada apostrofdan keyin ham ko'chiriladi (to'-\nliq). Kitobdagi(\w)-\n(\w)uni tuzatmasdi (8-lab). ocr_statsvaquality_gate: o'rtacha confidence yolg'iz yetarli emas. Juda xira suratda o'rtacha 85, haqiqiy CER 0.31 (4-lab, 7-lab). Past-conf so'zlar ulushi va so'zlar soni qo'shildi.
ocrlib.py
# ocrlib.py — 3, 4, 8, 10-boblardagi funksiyalar bitta faylda.
# 11-bob laboratoriyalari va 12-bob loyihalari shu faylni import qiladi.
import os
import re
from pathlib import Path

import cv2
import numpy as np
import pytesseract
from PIL import Image
from jiwer import cer, wer

HERE = Path(__file__).parent

# Til fayllari apt orqali emas, alohida papkada bo'lsa (Windows yoki root siz Linux):
# tessdata/ papkasi shu fayl yonida bo'lsa, Tesseract ga shu yerdan o'qishni aytamiz.
if (HERE / "tessdata").exists():
    os.environ["TESSDATA_PREFIX"] = str(HERE / "tessdata")


# ---------- rasm yuklash ----------
def to_gray(img):
    """Yo'l, PIL rasm yoki numpy massiv -> kulrang numpy massiv."""
    if isinstance(img, (str, Path)):
        img = cv2.imread(str(img))
        return cv2.cvtColor(img, cv2.COLOR_BGR2GRAY)
    if isinstance(img, Image.Image):
        return cv2.cvtColor(np.array(img.convert("RGB")), cv2.COLOR_RGB2GRAY)
    if img.ndim == 3:
        return cv2.cvtColor(img, cv2.COLOR_BGR2GRAY)
    return img


# ---------- 3-bob: preprocessing ----------
def deskew(binary):
    """Qiyshiq sahifani to'g'rilash. OpenCV 4.5+ va eski versiyalarda bir xil ishlaydi."""
    coords = cv2.findNonZero(255 - binary)           # matn (qora) piksellari, (x, y)
    if coords is None:
        return binary
    angle = cv2.minAreaRect(coords)[-1]
    if angle > 45:                                    # yangi OpenCV: [0, 90)
        angle -= 90
    elif angle < -45:                                 # eski OpenCV: [-90, 0)
        angle += 90
    (h, w) = binary.shape
    M = cv2.getRotationMatrix2D((w // 2, h // 2), angle, 1.0)
    return cv2.warpAffine(binary, M, (w, h), flags=cv2.INTER_CUBIC,
                          borderMode=cv2.BORDER_REPLICATE)


def skew_angle(binary):
    """Faqat burchakni qaytaradi (laboratoriya uchun)."""
    coords = cv2.findNonZero(255 - binary)
    angle = cv2.minAreaRect(coords)[-1]
    if angle > 45:
        angle -= 90
    elif angle < -45:
        angle += 90
    return angle


def preprocess(img, mode="otsu", denoise=True, upscale=True, do_deskew=True):
    """Kulrang -> (kattalashtirish) -> (denoise) -> threshold -> (deskew).

    mode: "none" (faqat kulrang), "otsu" (skaner), "adaptive" (telefon surati)
    """
    gray = to_gray(img)
    if upscale and gray.shape[0] < 1000:
        gray = cv2.resize(gray, None, fx=2, fy=2, interpolation=cv2.INTER_CUBIC)
    if mode == "none":
        return gray
    if denoise:
        gray = cv2.fastNlMeansDenoising(gray, h=10)
    if mode == "otsu":
        _, binary = cv2.threshold(gray, 0, 255, cv2.THRESH_BINARY + cv2.THRESH_OTSU)
    elif mode == "adaptive":
        binary = cv2.adaptiveThreshold(gray, 255, cv2.ADAPTIVE_THRESH_GAUSSIAN_C,
                                       cv2.THRESH_BINARY, 31, 15)
    else:
        raise ValueError(mode)
    return deskew(binary) if do_deskew else binary


# ---------- 4-bob: Tesseract ----------
def ocr_text(img, lang="rus+uzb", psm=3):
    """Oddiy matn (image_to_string)."""
    return pytesseract.image_to_string(img, lang=lang, config=f"--psm {psm}")


def ocr_data(img, lang="rus+uzb", psm=3):
    """So'z darajasidagi jadval: koordinata + confidence (image_to_data)."""
    return pytesseract.image_to_data(img, lang=lang, config=f"--psm {psm}",
                                     output_type=pytesseract.Output.DICT)


def ocr_with_confidence(img, lang="rus+uzb", psm=3):
    """Matn (qator/paragraf tuzilishi bilan) + o'rtacha confidence. 10-bob."""
    data = ocr_data(img, lang, psm)
    lines, confs = {}, []
    for i, word in enumerate(data["text"]):
        conf = int(float(data["conf"][i]))           # "95.2" kabi satr ham keladi
        if conf <= 0 or not word.strip():            # -1 = bo'sh blok
            continue
        key = (data["block_num"][i], data["par_num"][i], data["line_num"][i])
        lines.setdefault(key, []).append(word)
        confs.append(conf)
    if not confs:
        return "", 0.0
    out, prev_par = [], None
    for key, words in lines.items():
        if prev_par is not None and key[:2] != prev_par:
            out.append("")                            # paragraf chegarasi -> \n\n
        out.append(" ".join(words))
        prev_par = key[:2]
    return "\n".join(out), sum(confs) / len(confs)


def ocr_stats(img, lang="rus+uzb", psm=3, low=60):
    """Matn + uchta sifat signali: o'rtacha conf, past-conf so'zlar ulushi, so'zlar soni.
    O'rtacha conf yolg'iz yetarli emas (11-bob, 4-lab): xira sahifada o'rtacha 85, CER 0.31.
    Past-conf ulushi (>10%) va so'zlar soni (juda kam) buzilgan sahifani ushlaydi."""
    data = ocr_data(img, lang, psm)
    lines, confs = {}, []
    for i, word in enumerate(data["text"]):
        conf = int(float(data["conf"][i]))
        if conf <= 0 or not word.strip():
            continue
        key = (data["block_num"][i], data["par_num"][i], data["line_num"][i])
        lines.setdefault(key, []).append(word)
        confs.append(conf)
    if not confs:
        return "", {"conf": 0.0, "low_ratio": 1.0, "words": 0}
    out, prev_par = [], None
    for key, words in lines.items():
        if prev_par is not None and key[:2] != prev_par:
            out.append("")
        out.append(" ".join(words))
        prev_par = key[:2]
    stats = {"conf": sum(confs) / len(confs), "low_ratio": sum(c < low for c in confs) / len(confs), "words": len(confs)}
    return "\n".join(out), stats


def quality_gate(method, stats, min_words=10):
    """8-bob darvozasi + 11-bob tuzatishi: o'rtacha conf, past-conf ulushi va so'zlar soni birga.
    min_words kichik (10): chek kabi qisqa hujjatlar ham bor. Layout xatosini (jadval, ustunlar) bu darvoza ushlamaydi."""
    if method == "text_layer":
        return "accept"
    if method == "ocr_vlm":
        return "accept_with_flag"
    if stats["words"] < min_words or stats["low_ratio"] > 0.10 or stats["conf"] < 60:
        return "manual_review"
    if stats["conf"] < 80 or stats["low_ratio"] > 0.03:
        return "accept_with_flag"
    return "accept"


# ---------- 8-bob: tozalash ----------
def clean_ocr_text(text):
    # bo'g'in ko'chirish: "zimma-\nsiga" -> "zimmasiga". O'zbekchada apostrofdan keyin ham
    # ko'chiriladi ("to'-\nliq"), shuning uchun \w bilan birga ' ham qabul qilinadi
    text = re.sub(r"([\w'])-\n(\w)", r"\1\2", text)
    text = re.sub(r"(?<!\n)\n(?!\n)", " ", text)              # yolg'iz \n -> bo'shliq
    text = re.sub(r"[ \t]{2,}", " ", text)                    # ortiqcha bo'shliq
    text = re.sub(r"^\s*-?\s*\d+\s*-?\s*$", "", text, flags=re.MULTILINE)   # sahifa raqami
    return text.strip()


# ---------- 9-bob: o'lchash ----------
def normalize(text):
    """CER/WER dan oldin: bo'shliqlarni bir xil qilish, bo'g'in ko'chirishni yopish."""
    text = re.sub(r"([\w'])-\n(\w)", r"\1\2", text)
    return re.sub(r"\s+", " ", text).strip()


def score(truth, pred):
    """CER va WER (jiwer). Bo'sh bashoratda 1.0."""
    t, p = normalize(truth), normalize(pred)
    if not p:
        return {"cer": 1.0, "wer": 1.0}
    return {"cer": cer(t, p), "wer": wer(t, p)}


# ---------- 7-bob: PDF ----------
def render_pdf_page(pdf_path, page_no, dpi=300):
    """PDF sahifasi -> PIL rasm. PyMuPDF bilan (poppler kerak emas).

    pdf2image + poppler bo'lsa 7-bobdagi convert_from_path(first_page=i, last_page=i) ham bo'ladi.
    """
    import pymupdf
    with pymupdf.open(pdf_path) as doc:
        page = doc[page_no - 1]
        pix = page.get_pixmap(dpi=dpi)
        return Image.frombytes("RGB", (pix.width, pix.height), pix.samples)


def pdf_page_text(pdf_path, page_no):
    """Sahifaning matn qatlami (bo'lmasa bo'sh satr)."""
    import pymupdf
    with pymupdf.open(pdf_path) as doc:
        return doc[page_no - 1].get_text() or ""


def pdf_page_count(pdf_path):
    import pymupdf
    with pymupdf.open(pdf_path) as doc:
        return len(doc)
TESSDATA_PREFIXqatori: apt bilan o'rnatilgan tillar bo'lsa kerak emas. Windows da yoki root siz Linux da til fayllarinitessdata/papkaga qo'yib, shu o'zgaruvchini bersangiz Tesseract ularni topadi. Fayllar:github.com/tesseract-ocr/tessdata_fast.
0-lab: samples/ ni sun'iy yasash
Darsga printer va skaner kerak emas. Matn rasmga chiziladi (DejaVu Sans, lotin va kirill), keyin "skaner", "telefon", "qiyshiq", "past DPI", "dog'li", "eski gazeta" buzilishlari qo'llanadi. To'g'ri matn ground_truth/ ga yoziladi, shuning uchun CER/WER birinchi daqiqadan o'lchanadi. Bitta narsa sun'iy yasab bo'lmaydi: qo'lyozma. Uni o'zingiz suratga oling.
lab00_make_samples.py
# lab00_make_samples.py — samples/ va ground_truth/ ni sun'iy yasash.
# Printer va skaner shart emas: matn rasmga chiziladi, keyin "skaner", "telefon",
# "qiyshiq", "past DPI" kabi buzilishlar qo'llanadi. To'g'ri matn yonida saqlanadi,
# shuning uchun CER/WER birinchi daqiqadan o'lchanadi.
import textwrap
from pathlib import Path

import cv2
import numpy as np
import pymupdf
from PIL import Image, ImageDraw, ImageFont, ImageFilter

HERE = Path(__file__).parent
OUT = HERE / "samples"
GT = HERE / "ground_truth"
OUT.mkdir(exist_ok=True)
GT.mkdir(exist_ok=True)

FONT = "/usr/share/fonts/truetype/dejavu/DejaVuSans.ttf"        # lotin + kirill
MONO = "/usr/share/fonts/truetype/dejavu/DejaVuSansMono.ttf"
W, H = 1654, 2339                                               # A4, 200 DPI

# ---------------- matnlar (ground truth) ----------------
UZ_LATIN = """SHARTNOMA № 45

Toshkent shahri, 2024-yil 15-yanvar

"Nihol" MChJ nomidan direktor Karimov Anvar Rustamovich, bundan buyon "Buyurtmachi" deb ataladi, bir tomondan, va "Barakat Servis" MChJ nomidan direktor Yusupova Dilnoza Baxtiyorovna, bundan buyon "Ijrochi" deb ataladi, ikkinchi tomondan, quyidagilar haqida ushbu shartnomani tuzdilar.

1. Shartnoma predmeti

1.1. Ijrochi Buyurtmachiga ofis jihozlarini yetkazib berish va o'rnatish xizmatini ko'rsatadi.
1.2. Xizmatlarning umumiy qiymati 17 500 000 (o'n yetti million besh yuz ming) so'mni tashkil etadi.
1.3. To'lov ish topshirilgan kundan boshlab 10 (o'n) bank kuni ichida amalga oshiriladi.

2. Tomonlarning majburiyatlari

2.1. Ijrochi jihozlarni 2024-yil 1-martgacha yetkazib berishga majbur.
2.2. Buyurtmachi qabul qilingan jihozlar uchun o'z vaqtida to'lovni amalga oshiradi.
2.3. Shartnoma tomonlari o'z zimmasiga olgan majburiyatlarni to'liq bajarishga kafolat beradi.

3. Yakuniy qoidalar

3.1. Ushbu shartnoma ikki nusxada tuzildi va imzolangan kundan kuchga kiradi.
3.2. Nizolar muzokaralar yo'li bilan, kelishuvga erishilmasa sud tartibida hal qilinadi."""

UZ_CYRILLIC = """ШАРТНОМА № 45

Тошкент шаҳри, 2024 йил 15 январь

"Ниҳол" МЧЖ номидан директор Каримов Анвар Рустамович, бундан буён "Буюртмачи" деб аталади, бир томондан, ва "Баракат Сервис" МЧЖ номидан директор Юсупова Дилноза Бахтиёровна, бундан буён "Ижрочи" деб аталади, иккинчи томондан, қуйидагилар ҳақида ушбу шартномани туздилар.

1. Шартнома предмети

1.1. Ижрочи Буюртмачига офис жиҳозларини етказиб бериш ва ўрнатиш хизматини кўрсатади.
1.2. Хизматларнинг умумий қиймати 17 500 000 (ўн етти миллион беш юз минг) сўмни ташкил этади.
1.3. Тўлов иш топширилган кундан бошлаб 10 (ўн) банк куни ичида амалга оширилади.

2. Томонларнинг мажбуриятлари

2.1. Ижрочи жиҳозларни 2024 йил 1 мартгача етказиб беришга мажбур.
2.2. Буюртмачи қабул қилинган жиҳозлар учун ўз вақтида тўловни амалга оширади.
2.3. Шартнома томонлари ўз зиммасига олган мажбуриятларни тўлиқ бажаришга кафолат беради."""

RUSSIAN = """ДОГОВОР № 45

г. Ташкент, 15 января 2024 г.

ООО "Нихол" в лице директора Каримова Анвара Рустамовича, именуемое в дальнейшем "Заказчик", с одной стороны, и ООО "Баракат Сервис" в лице директора Юсуповой Дилнозы Бахтиёровны, именуемое в дальнейшем "Исполнитель", с другой стороны, заключили настоящий договор о нижеследующем.

1. Предмет договора

1.1. Исполнитель обязуется поставить и установить офисное оборудование для Заказчика.
1.2. Общая стоимость услуг составляет 17 500 000 (семнадцать миллионов пятьсот тысяч) сум.
1.3. Оплата производится в течение 10 (десяти) банковских дней со дня подписания акта.

2. Обязанности сторон

2.1. Исполнитель обязуется поставить оборудование до 1 марта 2024 года.
2.2. Заказчик обязуется своевременно оплатить принятое оборудование.
2.3. Стороны гарантируют полное исполнение принятых на себя обязательств.

3. Заключительные положения

3.1. Настоящий договор составлен в двух экземплярах и вступает в силу со дня подписания.
3.2. Споры разрешаются путём переговоров, а при недостижении согласия — в судебном порядке."""

RECEIPTS = [
    {"shop": "KORZINKA SUPERMARKET", "inn": "302145678", "date": "15.01.2024", "time": "18:42",
     "items": [("Non oq 400g", 1, 4500), ("Sut 1L Nestle", 2, 14900), ("Tuxum 10 dona", 1, 21000),
               ("Shakar 1kg", 1, 12500), ("Choy Ahmad 100g", 1, 28000)], "total": 95800},
    {"shop": "MAKRO MARKET", "inn": "305987123", "date": "02.03.2024", "time": "09:15",
     "items": [("Guruch lazer 1kg", 3, 22000), ("Yog' 1L", 1, 32000), ("Kartoshka 1kg", 2, 6000),
               ("Sabzi 1kg", 1, 5500)], "total": 115500},
    {"shop": "HAVAS GOURMET", "inn": "301456789", "date": "27.06.2024", "time": "20:03",
     "items": [("Pishloq 200g", 1, 38500), ("Kofe 250g", 1, 65000), ("Suv 1.5L", 4, 4000)], "total": 119500},
]

TABLE = [["Mahsulot", "Miqdor", "Narx (so'm)", "Jami"],
         ["Monitor 24 dyuym", "4", "1 850 000", "7 400 000"],
         ["Klaviatura", "10", "180 000", "1 800 000"],
         ["Sichqoncha", "10", "95 000", "950 000"],
         ["Printer lazer", "1", "3 200 000", "3 200 000"],
         ["Kabel HDMI 2m", "6", "45 000", "270 000"],
         ["JAMI", "", "", "13 620 000"]]

NEWSPAPER_HEADER = "ТОШКЕНТ ОҚШОМИ · 1994 йил 12 март · № 48 (1123)"
NEWSPAPER_COLS = [
    """Шаҳар ҳокимлиги янги йўл қурилиши тўғрисида қарор қабул қилди. Чилонзор туманидаги марказий кўчаларда таъмирлаш ишлари апрель ойида бошланади.

Мутахассисларнинг фикрича, янги йўл транспорт оқимини сезиларли даражада камайтиради. Қурилиш учун бюджетдан зарур маблағ ажратилган.

Аҳоли вакиллари йиғилишда ўз таклифларини билдирдилар. Кўпчилик пиёдалар учун алоҳида йўлаклар қурилишини сўради.""",
    """Пойтахт мактабларида баҳорги таътил бошланди. Ўқувчилар учун маданият саройларида турли тўгараклар ташкил этилган.

Таълим бўлими маълумотига кўра, бу йил тўгаракларга уч мингдан ортиқ бола ёзилган. Энг оммабоп йўналишлар — расм ва шахмат.

Ота-оналар учун ҳам бепул маслаҳат хоналари очилган. Улар ҳар куни соат ўндан ўн саккизгача ишлайди.""",
]

NEWSPAPER_COLS_2 = [
    """Самарқанд йўналишида янги тезюрар поезд қатнови йўлга қўйилди. Йўл вақти икки соатга қисқарди.

Темир йўл идораси маълумотига кўра, чипталар нархи ўзгармайди. Кунига икки рейс режалаштирилган.""",
    """Шаҳар кутубхонаси ўқувчилар учун ёзги ўқиш дастурини эълон қилди. Ҳар ҳафта янги китоблар муҳокамаси бўлади.

Дастурда қатнашиш бепул. Рўйхатдан ўтиш учун кутубхонанинг биринчи қаватига мурожаат қилинади.""",
]

NEWSPAPER_COLS_3 = [
    """Чорсу бозорида баҳорги савдо ярмаркаси очилди. Вилоятлардан келган деҳқонлар ўз маҳсулотларини бевосита харидорларга сотмоқда.

Бозор маъмурияти нархлар ўтган йилга нисбатан ўн фоизга арзонлаганини маълум қилди. Ярмарка икки ҳафта давом этади.""",
    """Пойтахт театрида янги спектакль премьераси бўлиб ўтди. Асар ёш драматургнинг илк йирик ишидир.

Томошабинлар спектаклни илиқ кутиб олди. Кейинги намойишлар шанба ва якшанба кунлари кечки соат еттида бўлади.""",
]

# ---------------- chizish ----------------
def render_page(text, font_path=FONT, size=40, margin=140, line_gap=14, width=W, height=H, wrap=62):
    img = Image.new("L", (width, height), 255)
    d = ImageDraw.Draw(img)
    font = ImageFont.truetype(font_path, size)
    y = margin
    for para in text.split("\n"):
        lines = textwrap.wrap(para, wrap) if para.strip() else [""]
        for ln in lines:
            d.text((margin, y), ln, fill=0, font=font)
            y += size + line_gap
    return img


def render_receipt(r):
    lines = [r["shop"], f"INN {r['inn']}", f"Sana: {r['date']}  {r['time']}", "-" * 30]
    for name, qty, price in r["items"]:
        lines.append(f"{name[:18]:<18}{qty:>3} x {price:>7,}".replace(",", " "))
    lines += ["-" * 30, f"JAMI:{r['total']:>25,}".replace(",", " "), "Naqd:{:>25,}".format(r["total"]).replace(",", " "),
              "", "RAHMAT! Yana keling"]
    img = Image.new("L", (760, 80 + 46 * len(lines)), 255)
    d = ImageDraw.Draw(img)
    font = ImageFont.truetype(MONO, 30)
    for i, ln in enumerate(lines):
        d.text((40, 40 + 46 * i), ln, fill=0, font=font)
    # Ground truth ga dekorativ "------" chiziqlar kirmaydi: ular matn emas, OCR ularni
    # tashlab yuborsa xato emas (9-bob: nimani o'lchayotganingizni bilib oling)
    truth = "\n".join(ln for ln in lines if set(ln.strip()) != {"-"})
    return img, truth


def render_table(rows, col_w=(520, 220, 330, 330), row_h=110, x0=100, y0=200):
    width = x0 * 2 + sum(col_w)
    img = Image.new("L", (width, y0 * 2 + row_h * len(rows)), 255)
    d = ImageDraw.Draw(img)
    font = ImageFont.truetype(FONT, 36)
    bold = ImageFont.truetype(FONT.replace("Sans.ttf", "Sans-Bold.ttf"), 36)
    d.text((x0, 80), "Ofis jihozlari — narxlar ro'yxati", fill=0, font=bold)
    for r, row in enumerate(rows):
        x = x0
        for c, cell in enumerate(row):
            d.rectangle([x, y0 + r * row_h, x + col_w[c], y0 + (r + 1) * row_h], outline=0, width=3)
            d.text((x + 20, y0 + r * row_h + 32), cell, fill=0, font=bold if r in (0, len(rows) - 1) else font)
            x += col_w[c]
    return img


def render_newspaper(cols, header, page_no):
    img = Image.new("L", (W, H), 255)
    d = ImageDraw.Draw(img)
    font = ImageFont.truetype(FONT, 34)
    bold = ImageFont.truetype(FONT.replace("Sans.ttf", "Sans-Bold.ttf"), 30)
    d.text((140, 80), header, fill=0, font=bold)
    d.line([140, 140, W - 140, 140], fill=0, width=3)
    col_w = (W - 280 - 60) // 2
    for c, text in enumerate(cols):
        x = 140 + c * (col_w + 60)
        y = 190
        for para in text.split("\n"):
            for ln in (textwrap.wrap(para, 30) if para.strip() else [""]):
                d.text((x, y), ln, fill=0, font=font)
                y += 46
    d.text((W // 2 - 20, H - 120), f"- {page_no} -", fill=0, font=font)
    return img


# ---------------- buzilishlar ----------------
def scan_look(img, noise=8, blur=0.7, bg=238):
    """Skaner: engil shovqin, biroz xiralik, oq emas kulrang-oq fon."""
    a = np.array(img).astype(np.float32)
    a = np.where(a > 200, bg, a)
    a += np.random.normal(0, noise, a.shape)
    a = np.clip(a, 0, 255).astype(np.uint8)
    return Image.fromarray(a).filter(ImageFilter.GaussianBlur(blur))


def phone_look(img):
    """Telefon: bir tomoni soyada (gradient), engil xiralik, JPEG artefaktlari (saqlashda q=55)."""
    a = np.array(img).astype(np.float32)
    h, w = a.shape
    grad = np.linspace(1.0, 0.45, w)[None, :]                 # chapdan o'ngga qorayadi
    vign = 1 - 0.25 * ((np.linspace(-1, 1, h)[:, None]) ** 2)  # tepada-pastda biroz qorong'i
    a = a * grad * vign
    a += np.random.normal(0, 6, a.shape)
    a = np.clip(a, 0, 255).astype(np.uint8)
    return Image.fromarray(a).filter(ImageFilter.GaussianBlur(1.0))


def skew(img, deg):
    return img.rotate(deg, resample=Image.BICUBIC, fillcolor=255)


def salt_pepper(img, amount=0.01):
    a = np.array(img).copy()
    m = np.random.rand(*a.shape)
    a[m < amount / 2] = 0
    a[m > 1 - amount / 2] = 255
    return Image.fromarray(a)


def yellowed_bleed(img):
    """Eski gazeta: sarg'aygan fon, orqa tomon matni xira ko'rinadi, donachalar."""
    a = np.array(img).astype(np.float32)
    a = np.where(a > 200, 205, a)                             # sarg'aygan (kulrang) fon
    back = np.array(img.transpose(Image.FLIP_LEFT_RIGHT)).astype(np.float32)
    bleed = np.where(back < 128, 165, 205)                    # teskari matn xira (bleed-through)
    a = np.minimum(a, bleed)
    a += np.random.normal(0, 12, a.shape)
    a = np.clip(a, 0, 255).astype(np.uint8)
    return Image.fromarray(a).filter(ImageFilter.GaussianBlur(0.8))


def blur_box(img, box, radius=6):
    region = img.crop(box).filter(ImageFilter.GaussianBlur(radius))
    out = img.copy()
    out.paste(region, box)
    return out


def para_box(text, prefix, size=40, margin=140, line_gap=14, wrap=62):
    """render_page bilan bir xil hisob: `prefix` bilan boshlanadigan paragrafning barcha qatorlari qayerda?"""
    y, step = margin, size + line_gap
    for para in text.split("\n"):
        lines = textwrap.wrap(para, wrap) if para.strip() else [""]
        if para.startswith(prefix):
            return (margin - 10, y - 6, W - margin, y + step * len(lines) - 6)
        y += step * len(lines)
    raise ValueError(prefix)


# ---------------- PDF ----------------
def digital_pdf(text, path):
    doc = pymupdf.open()
    page = doc.new_page(width=595, height=842)
    page.insert_font(fontname="dj", fontfile=FONT)
    page.insert_textbox(pymupdf.Rect(50, 50, 545, 800), text, fontname="dj", fontsize=10.5)
    doc.save(path)
    doc.close()


def image_pdf(images, path):
    doc = pymupdf.open()
    for im in images:
        page = doc.new_page(width=595, height=842)
        tmp = OUT / "_tmp.png"
        im.save(tmp)
        page.insert_image(page.rect, filename=str(tmp))
    doc.save(path)
    doc.close()
    (OUT / "_tmp.png").unlink(missing_ok=True)


def mixed_pdf(text, scan_img, phone_img, path):
    """1-sahifa digital (matn qatlami bor), 2-sahifa skan, 3-sahifa telefon surati."""
    doc = pymupdf.open()
    p = doc.new_page(width=595, height=842)
    p.insert_font(fontname="dj", fontfile=FONT)
    p.insert_textbox(pymupdf.Rect(50, 50, 545, 800), text, fontname="dj", fontsize=10.5)
    for im in (scan_img, phone_img):
        p = doc.new_page(width=595, height=842)
        tmp = OUT / "_tmp.png"
        im.convert("L").save(tmp)
        p.insert_image(p.rect, filename=str(tmp))
    doc.save(path)
    doc.close()
    (OUT / "_tmp.png").unlink(missing_ok=True)


# ---------------- asosiy ----------------
def save(name, img, truth=None, quality=None):
    path = OUT / name
    if quality:
        img.save(path, quality=quality)
    else:
        img.save(path)
    if truth is not None:
        (GT / (Path(name).stem + ".txt")).write_text(truth, encoding="utf-8")
    print(f"  {name:28s} {img.size[0]}x{img.size[1]}")


if __name__ == "__main__":
    np.random.seed(0)
    print("samples/ yasalmoqda:")
    lat, cyr, rus = render_page(UZ_LATIN), render_page(UZ_CYRILLIC), render_page(RUSSIAN)

    digital_pdf(UZ_LATIN, OUT / "01_digital.pdf")
    (GT / "01_digital.txt").write_text(UZ_LATIN, encoding="utf-8")
    print("  01_digital.pdf               matn qatlami bor")

    scan_rus = scan_look(rus)
    save("02_skan_rus.png", scan_rus, RUSSIAN)
    image_pdf([scan_rus], OUT / "02_skan_rus.pdf")
    print("  02_skan_rus.pdf              faqat rasm")

    save("03_uzb_lotin.png", scan_look(lat), UZ_LATIN)
    save("04_uzb_kirill.png", scan_look(cyr), UZ_CYRILLIC)
    phone = phone_look(lat)
    save("05_telefon_soya.jpg", phone, UZ_LATIN, quality=55)
    save("06_qiyshiq.png", skew(scan_look(lat), 3), UZ_LATIN)
    save("07_jadval.png", scan_look(render_table(TABLE), noise=4), "\n".join(" | ".join(r) for r in TABLE))
    receipts_truth = []
    for i, r in enumerate(RECEIPTS, 1):
        rimg, rtxt = render_receipt(r)
        save(f"10_chek_{i}.jpg", phone_look(rimg) if i == 2 else scan_look(rimg), rtxt, quality=60)
        receipts_truth.append({"file": f"10_chek_{i}.jpg", "sana": r["date"], "inn": r["inn"], "summa": r["total"],
                               "mahsulotlar": [[n, q, p] for n, q, p in r["items"]]})
    import json
    (GT / "receipts.json").write_text(json.dumps(receipts_truth, ensure_ascii=False, indent=1), encoding="utf-8")
    low = scan_look(lat).resize((W // 2, H // 2), Image.BILINEAR)          # ~100 DPI skan
    save("11_past_dpi.png", low, UZ_LATIN)
    save("12_dogli.png", salt_pepper(scan_look(lat), 0.02), UZ_LATIN)
    # 1.2-band: summa raqami HAM, so'z bilan yozilgani HAM xiralashtiriladi (ikki qator) —
    # aks holda VLM raqamni so'zlardan "tiklab" beradi (VLM hallucination demo, 6-bob)
    save("13_xira_raqam.png", blur_box(scan_look(lat), para_box(UZ_LATIN, "1.2."), 10), UZ_LATIN)
    # 15: juda xira, past kontrastli surat — Tesseract conf < 60, VLM fallback uchun (7, 10-boblar)
    faint = np.array(phone_look(lat).filter(ImageFilter.GaussianBlur(2.2))).astype(np.float32)
    faint = np.clip(120 + (faint - 120) * 0.55 + np.random.normal(0, 10, faint.shape), 0, 255).astype(np.uint8)
    save("15_juda_xira.jpg", Image.fromarray(faint), UZ_LATIN, quality=45)
    for i, cols in enumerate([NEWSPAPER_COLS, NEWSPAPER_COLS_2, NEWSPAPER_COLS_3], 1):
        truth = NEWSPAPER_HEADER + "\n\n" + "\n\n".join(cols) + f"\n\n- {i} -"
        save(f"14_gazeta_{i}.png", yellowed_bleed(render_newspaper(cols, NEWSPAPER_HEADER, i)), truth)
    mixed_pdf(UZ_LATIN, scan_rus, phone, OUT / "09_aralash.pdf")
    (GT / "09_aralash.txt").write_text(UZ_LATIN + "\n\n" + RUSSIAN + "\n\n" + UZ_LATIN, encoding="utf-8")
    print("  09_aralash.pdf               3 sahifa: digital + skan + telefon")
    print(f"\nground_truth/: {len(list(GT.glob('*.txt')))} ta fayl")
samples/ yasalmoqda:
  01_digital.pdf               matn qatlami bor
  02_skan_rus.png              1654x2339
  02_skan_rus.pdf              faqat rasm
  03_uzb_lotin.png             1654x2339
  04_uzb_kirill.png            1654x2339
  05_telefon_soya.jpg          1654x2339
  06_qiyshiq.png               1654x2339
  07_jadval.png                1600x1170
  10_chek_1.jpg                760x724
  10_chek_2.jpg                760x678
  10_chek_3.jpg                760x632
  11_past_dpi.png              827x1169
  12_dogli.png                 1654x2339
  13_xira_raqam.png            1654x2339
  15_juda_xira.jpg             1654x2339
  14_gazeta_1.png              1654x2339
  14_gazeta_2.png              1654x2339
  14_gazeta_3.png              1654x2339
  09_aralash.pdf               3 sahifa: digital + skan + telefon

ground_truth/: 18 ta fayl
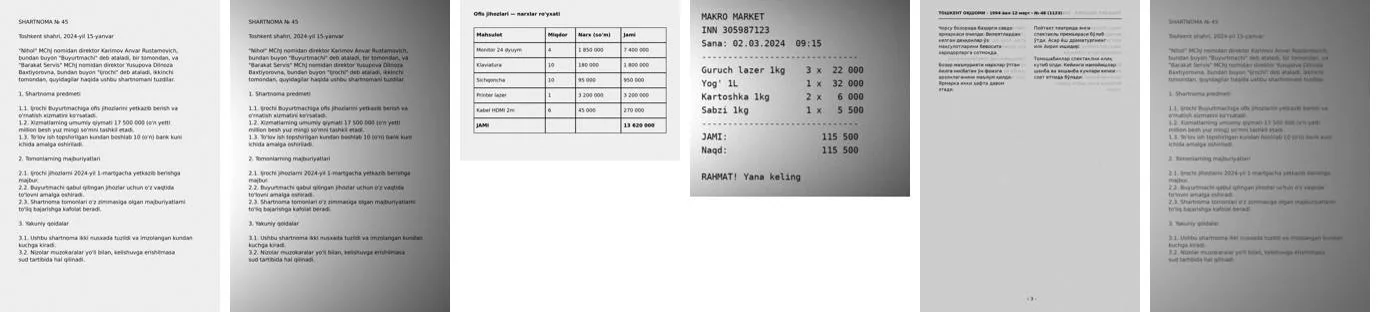
Chapdan o'ngga: 03 toza skan, 05 telefon surati (soya), 07 jadval, 10 chek (telefon), 14 gazeta (bleed-through), 15 juda xira
| Fayl | Nima uchun | Qaysi lab |
|---|---|---|
| 01_digital.pdf | matn qatlami bor | 7 |
| 02_skan_rus.png / .pdf | toza skan, ruscha | 4, 5, 7 |
| 03_uzb_lotin.png | toza skan, o'zbek lotin | 2, 4, 6, 8, 9 |
| 04_uzb_kirill.png | toza skan, kirill (ў қ ғ ҳ) | 4, 5 |
| 05_telefon_soya.jpg | bir tomoni soyada, JPEG | 2, 3, 5, 6 |
| 06_qiyshiq.png | 3° burilgan | 3 |
| 07_jadval.png | chiziqli jadval | 2, 6, 12-bob |
| 09_aralash.pdf | digital + skan + telefon, 3 sahifa | 7 |
| 10_chek_1..3.jpg | chek, 2-si telefon surati | 4, 12-bob |
| 11_past_dpi.png | ~100 DPI | 3 |
| 12_dogli.png | tuz-qalampir shovqin | 3 |
| 13_xira_raqam.png | 1.2-band xiralashtirilgan | 6 |
| 14_gazeta_1..3.png | sarg'aygan, 2 ustun, orqa tomon ko'rinadi | 9, 12-bob |
| 15_juda_xira.jpg | juda xira telefon surati | 7, 12-bob |
Ground truth haqida (9-bob): chekdagi
------chiziqlar haqiqiy matnga kirmaydi. Birinchi versiyada kirgan edi, Tesseract ularni tashlab yuboradi va CER 0.24 chiqdi. Chiziqlar olib tashlangach xuddi shu OCR uchun CER 0.03. Nimani o'lchayotganingizni bilib oling.
1-lab: muhitni tekshirish
Jonli demo buzilsa, dars buziladi. Har darsdan oldin bitta buyruq. Har qator: OK yoki !! va tuzatish. Ollama uchun qaysi model rasmni "ko'rishi" nomdan emas, /api/show dagi capabilities dan aniqlanadi: qwen3.5:9b nomida "vl" yo'q, lekin vision bor; qwen2.5:7b da yo'q.
lab01_check_env.py
# lab01_check_env.py — darsdan oldin muhitni tekshirish. Har bir qator: OK yoki !! va tuzatish maslahati.
import json
import os
import shutil
import subprocess
import urllib.request
from pathlib import Path

HERE = Path(__file__).parent
if (HERE / "tessdata").exists():
    os.environ["TESSDATA_PREFIX"] = str(HERE / "tessdata")


def ok(name, cond, hint=""):
    print(("OK  " if cond else "!!  ") + name + ("" if cond else f"  -> {hint}"))
    return bool(cond)


results = []
results.append(ok("tesseract binary", shutil.which("tesseract"), "sudo apt install tesseract-ocr"))
if results[-1]:
    out = subprocess.run(["tesseract", "--list-langs"], capture_output=True, text=True)
    langs = (out.stdout + out.stderr).split()
    for l in ("rus", "uzb", "uzb_cyrl"):
        results.append(ok(f"tesseract lang {l}", l in langs,
                          f"sudo apt install tesseract-ocr-{l.replace('_', '-')}  yoki tessdata_fast dan {l}.traineddata"))

for mod, pipname in (("cv2", "opencv-python-headless"), ("pytesseract", "pytesseract"), ("pymupdf", "pymupdf"),
                     ("pdfplumber", "pdfplumber"), ("jiwer", "jiwer"), ("openai", "openai"), ("pandas", "pandas")):
    try:
        __import__(mod)
        results.append(ok(f"import {mod}", True))
    except ImportError:
        results.append(ok(f"import {mod}", False, f"pip install {pipname}"))

try:
    import easyocr  # noqa: F401
    results.append(ok("import easyocr (5-bob, ixtiyoriy)", True))
except ImportError:
    ok("import easyocr (5-bob, ixtiyoriy)", False, "pip install easyocr  (torch bilan, ~1 GB)")

host = os.environ.get("OLLAMA_HOST", "http://localhost:11434")
try:
    tags = json.load(urllib.request.urlopen(f"{host}/api/tags", timeout=3))
    names = [m["name"] for m in tags["models"]]
    results.append(ok(f"ollama server ({host})", True))
    # Qaysi model rasmni "ko'radi"? Nomdan emas, /api/show dagi capabilities dan bilamiz
    vision = []
    for n in names:
        req = urllib.request.Request(f"{host}/api/show", data=json.dumps({"model": n}).encode(),
                                     headers={"Content-Type": "application/json"})
        info = json.load(urllib.request.urlopen(req, timeout=5))
        if "vision" in info.get("capabilities", []):
            vision.append(n)
    vision_str = ", ".join(vision) or "yo'q"
    results.append(ok(f"vision model: {vision_str}", vision, "ollama pull qwen2.5vl:7b"))
except Exception as e:
    results.append(ok(f"ollama server ({host})", False, f"ollama serve  ({type(e).__name__})"))

results.append(ok("samples/ papkasi", (HERE / "samples").exists(), "python lab00_make_samples.py"))
results.append(ok("ground_truth/ papkasi", (HERE / "ground_truth").exists(), "python lab00_make_samples.py"))
print(f"\n{sum(results)}/{len(results)} tekshiruv o'tdi")
Chiqish (ushbu mashinada)
OK  tesseract binary
OK  tesseract lang rus
OK  tesseract lang uzb
OK  tesseract lang uzb_cyrl
OK  import cv2
OK  import pytesseract
OK  import pymupdf
OK  import pdfplumber
OK  import jiwer
OK  import openai
OK  import pandas
OK  import easyocr (5-bob, ixtiyoriy)
OK  ollama server (http://192.168.240.1:11435)
OK  vision model: qwen2.5vl:7b, qwen3.5:9b
OK  samples/ papkasi
OK  ground_truth/ papkasi

16/16 tekshiruv o'tdi
2-lab: detection va confidence ramkalari
2-bobdagi "detection" mavhum tushuncha. image_to_data uni ko'rinadigan qiladi: har so'z uchun ramka va confidence. Yashil = conf > 60, qizil = shubhali. Bitta rasmda talaba ikkala tushunchani ko'radi.
lab02_boxes.py
# lab02_boxes.py — 2-bob: detection va confidence ni ko'z bilan ko'rish.
# image_to_data har so'z uchun ramka (left, top, width, height) va conf beradi.
# Ramkalarni rasmga chizamiz: yashil = conf > 60, qizil = shubhali so'z.
import sys
from pathlib import Path

import cv2

from ocrlib import ocr_data, preprocess, to_gray

HERE = Path(__file__).parent
OUT = HERE / "out"
OUT.mkdir(exist_ok=True)


def draw_boxes(image, lang, out_name, psm=3):
    gray = to_gray(image)
    canvas = cv2.cvtColor(gray, cv2.COLOR_GRAY2BGR)
    d = ocr_data(gray, lang=lang, psm=psm)
    total = good = bad = 0
    confs = []
    for x, y, w, h, c, t in zip(d["left"], d["top"], d["width"], d["height"], d["conf"], d["text"]):
        c = int(float(c))
        if c <= 0 or not t.strip():
            continue                                   # -1: bo'sh blok, so'z emas
        total += 1
        confs.append(c)
        if c > 60:
            good += 1
            color = (0, 180, 0)
        else:
            bad += 1
            color = (0, 0, 255)
        cv2.rectangle(canvas, (x, y), (x + w, y + h), color, 3)
    cv2.imwrite(str(OUT / out_name), canvas)
    avg = sum(confs) / max(1, len(confs))
    print(f"{out_name:32s} so'zlar={total:3d}  yashil(>60)={good:3d}  qizil(<=60)={bad:3d}  o'rtacha conf={avg:5.1f}")
    return d


if __name__ == "__main__":
    print("Detection + confidence ramkalari (out/ papkasiga yoziladi):")
    # 1) toza skan, o'zbek lotin — deyarli hammasi yashil bo'lishi kerak
    draw_boxes(HERE / "samples/03_uzb_lotin.png", "uzb", "lab02_boxes_03_toza.png")
    # 2) telefon surati, preprocessing SIZ — soyali qismda qizil ko'payadi
    draw_boxes(HERE / "samples/05_telefon_soya.jpg", "uzb", "lab02_boxes_05_raw.png")
    # 3) o'sha surat, adaptive threshold dan keyin — qizil kamayadi
    draw_boxes(preprocess(HERE / "samples/05_telefon_soya.jpg", "adaptive"), "uzb", "lab02_boxes_05_adaptive.png")
    # 4) jadval — Tesseract ramkalarni topadi, lekin qatorlar tartibi buziladi (2-bob: layout)
    d = draw_boxes(HERE / "samples/07_jadval.png", "uzb", "lab02_boxes_07_jadval.png", psm=6)
    lines = {}
    for i, t in enumerate(d["text"]):
        if int(float(d["conf"][i])) > 0 and t.strip():
            lines.setdefault(d["line_num"][i], []).append(t)
    print("\nJadvalni Tesseract qanday 'o'qidi' (birinchi 4 qator, PSM 6):")
    for k in list(lines)[:4]:
        print("  ", " ".join(lines[k]))
Detection + confidence ramkalari (out/ papkasiga yoziladi):
lab02_boxes_03_toza.png          so'zlar=143  yashil(>60)=142  qizil(<=60)=  1  o'rtacha conf= 95.5
lab02_boxes_05_raw.png           so'zlar=114  yashil(>60)=110  qizil(<=60)=  4  o'rtacha conf= 93.4
lab02_boxes_05_adaptive.png      so'zlar=143  yashil(>60)=143  qizil(<=60)=  0  o'rtacha conf= 95.8
lab02_boxes_07_jadval.png        so'zlar= 13  yashil(>60)=  7  qizil(<=60)=  6  o'rtacha conf= 61.9

Jadvalni Tesseract qanday 'o'qidi' (birinchi 4 qator, PSM 6):
   Ofis jihozlari — narxlar ro'yxati Sn,
   orani fo Jamo — Jamo —
   omai
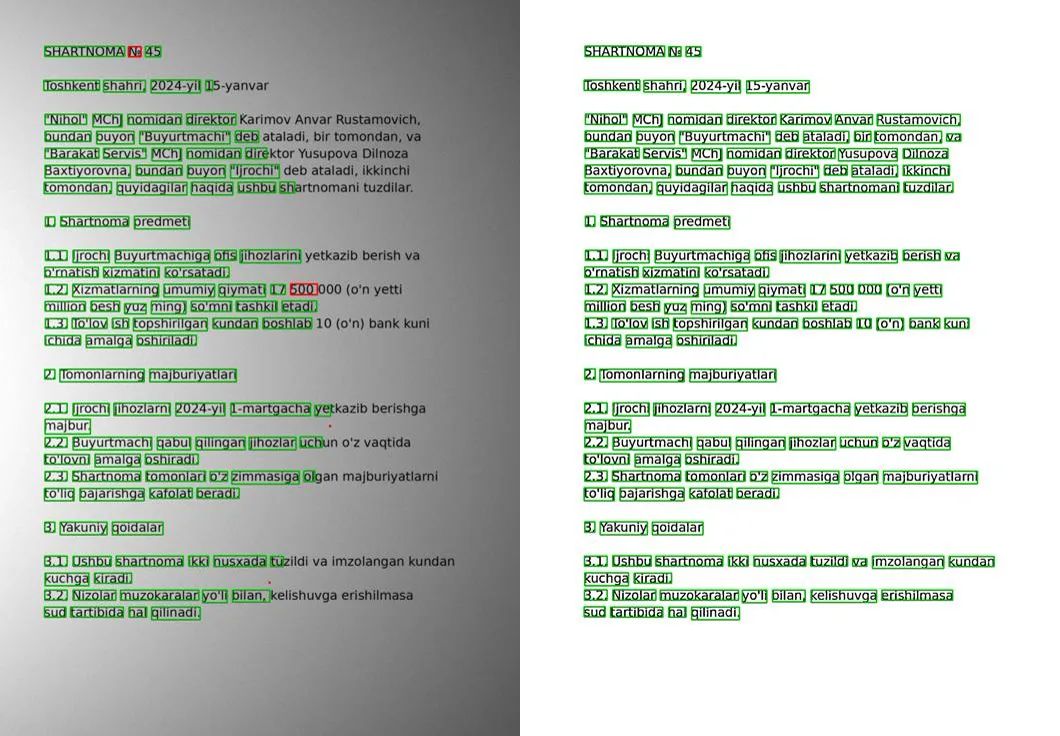
05_telefon_soya.jpg: chapda preprocessing siz (soyali qismda so'zlar yo'qolgan: 114 ta), o'ngda adaptive threshold dan keyin (143 ta, hammasi yashil)
O'qish: toza skanda 143 so'zning 142 tasi yashil. Telefon suratida preprocessing siz Tesseract 29 ta so'zni umuman topmaydi (soyali qism fonga qo'shilib ketadi), topganlarining 4 tasi qizil. Adaptive threshold dan keyin 143/143. Jadvalda esa 13 ta so'z va o'rtacha conf 62: layout analysis jadval chiziqlarini matn deb o'ylaydi, qatorlar buziladi. Bu 6-lab (VLM) va 12-bob 4-loyiha (chiziqlarni olib tashlash) uchun asos.
Talabaga savol. Nega soyali qismda so'zlar "qizil" emas, umuman yo'q? (Detection bosqichi ularni matn deb topmadi, recognition gacha yetib bormadi. 2-bob: 4 bosqich.)
3-lab: preprocessing — taxmin emas, CER
3-bobning har bir qoidasi raqam bilan tekshiriladi: threshold turi, deskew, DPI, shovqin. Va bitta muhim savol: toza rasmga preprocessing zarar qilmaydimi?
lab03_preprocess.py
# lab03_preprocess.py — 3-bob: preprocessing foyda beradimi? Taxmin emas, CER bilan.
# 4 ta tajriba: threshold turi (telefon surati), deskew (qiyshiq), DPI (past sifat), shovqin (dog'li).
import time
from pathlib import Path

import cv2

from ocrlib import deskew, ocr_text, preprocess, score, skew_angle, to_gray

HERE = Path(__file__).parent
S, G, OUT = HERE / "samples", HERE / "ground_truth", HERE / "out"
OUT.mkdir(exist_ok=True)


def run(img, lang, truth, label):
    t = time.perf_counter()
    text = ocr_text(img, lang=lang)
    dt = time.perf_counter() - t
    sc = score(truth, text)
    print(f"  {label:34s} CER={sc['cer']:6.3f}  WER={sc['wer']:6.3f}  ({dt:4.1f} s)")
    return sc


truth_lat = (G / "03_uzb_lotin.txt").read_text(encoding="utf-8")

print("A) Telefon surati (05_telefon_soya.jpg): threshold turi")
img = S / "05_telefon_soya.jpg"
run(to_gray(img), "uzb", truth_lat, "faqat kulrang (none)")
otsu = preprocess(img, "otsu", do_deskew=False)
run(otsu, "uzb", truth_lat, "Otsu (bitta chegara)")
adap = preprocess(img, "adaptive", do_deskew=False)
run(adap, "uzb", truth_lat, "Adaptive (hudud bo'yicha)")
cv2.imwrite(str(OUT / "lab03_05_otsu.png"), otsu)
cv2.imwrite(str(OUT / "lab03_05_adaptive.png"), adap)

print("\nB) Qiyshiq skan (06_qiyshiq.png, 3 daraja): deskew")
img = S / "06_qiyshiq.png"
binary = preprocess(img, "otsu", do_deskew=False)
print(f"  o'lchangan burchak: {skew_angle(binary):+.2f} daraja")
run(binary, "uzb", truth_lat, "deskew siz")
fixed = deskew(binary)
print(f"  deskew dan keyingi burchak: {skew_angle(fixed):+.2f} daraja")
run(fixed, "uzb", truth_lat, "deskew bilan")
cv2.imwrite(str(OUT / "lab03_06_deskewed.png"), fixed)

print("\nC) Past DPI: qachon kattalashtirish kerak?")
img = S / "11_past_dpi.png"                                    # ~100 DPI, belgi balandligi ~15 px
run(preprocess(img, "otsu", upscale=False), "uzb", truth_lat, "~100 DPI, asl o'lcham")
run(preprocess(img, "otsu", upscale=True), "uzb", truth_lat, "~100 DPI, 2x INTER_CUBIC")
tiny = cv2.resize(to_gray(img), None, fx=0.5, fy=0.5, interpolation=cv2.INTER_AREA)   # ~50 DPI, ~8 px
for k in (1, 2, 3):
    up = cv2.resize(tiny, None, fx=k, fy=k, interpolation=cv2.INTER_CUBIC) if k > 1 else tiny
    _, b = cv2.threshold(up, 0, 255, cv2.THRESH_BINARY + cv2.THRESH_OTSU)
    run(b, "uzb", truth_lat, f"~50 DPI, {k}x INTER_CUBIC")

print("\nD) Dog'li skan (12_dogli.png, tuz-qalampir): denoise")
img = S / "12_dogli.png"
run(preprocess(img, "otsu", denoise=False), "uzb", truth_lat, "denoise siz")
run(preprocess(img, "otsu", denoise=True), "uzb", truth_lat, "fastNlMeansDenoising")
med = cv2.medianBlur(to_gray(img), 3)
_, med = cv2.threshold(med, 0, 255, cv2.THRESH_BINARY + cv2.THRESH_OTSU)
run(med, "uzb", truth_lat, "medianBlur(3) + Otsu")

print("\nE) Toza skan (03_uzb_lotin.png): preprocessing zarar qilmaydimi?")
img = S / "03_uzb_lotin.png"
run(to_gray(img), "uzb", truth_lat, "faqat kulrang")
run(preprocess(img, "otsu"), "uzb", truth_lat, "to'liq zanjir (otsu+deskew)")
A) Telefon surati (05_telefon_soya.jpg): threshold turi
  faqat kulrang (none)               CER= 0.251  WER= 0.301  ( 0.8 s)
  Otsu (bitta chegara)               CER= 0.200  WER= 0.266  ( 0.9 s)
  Adaptive (hudud bo'yicha)          CER= 0.003  WER= 0.007  ( 0.7 s)

B) Qiyshiq skan (06_qiyshiq.png, 3 daraja): deskew
  o'lchangan burchak: -3.10 daraja
  deskew siz                         CER= 0.006  WER= 0.035  ( 0.7 s)
  deskew dan keyingi burchak: +0.04 daraja
  deskew bilan                       CER= 0.003  WER= 0.007  ( 0.8 s)

C) Past DPI: qachon kattalashtirish kerak?
  ~100 DPI, asl o'lcham              CER= 0.002  WER= 0.007  ( 0.5 s)
  ~100 DPI, 2x INTER_CUBIC           CER= 0.002  WER= 0.007  ( 0.5 s)
  ~50 DPI, 1x INTER_CUBIC            CER= 0.062  WER= 0.175  ( 0.5 s)
  ~50 DPI, 2x INTER_CUBIC            CER= 0.017  WER= 0.063  ( 0.7 s)
  ~50 DPI, 3x INTER_CUBIC            CER= 0.013  WER= 0.056  ( 0.7 s)

D) Dog'li skan (12_dogli.png, tuz-qalampir): denoise
  denoise siz                        CER= 0.061  WER= 0.385  ( 1.0 s)
  fastNlMeansDenoising               CER= 0.076  WER= 0.385  ( 1.0 s)
  medianBlur(3) + Otsu               CER= 0.003  WER= 0.014  ( 0.7 s)

E) Toza skan (03_uzb_lotin.png): preprocessing zarar qilmaydimi?
  faqat kulrang                      CER= 0.002  WER= 0.007  ( 1.1 s)
  to'liq zanjir (otsu+deskew)        CER= 0.002  WER= 0.007  ( 0.8 s)
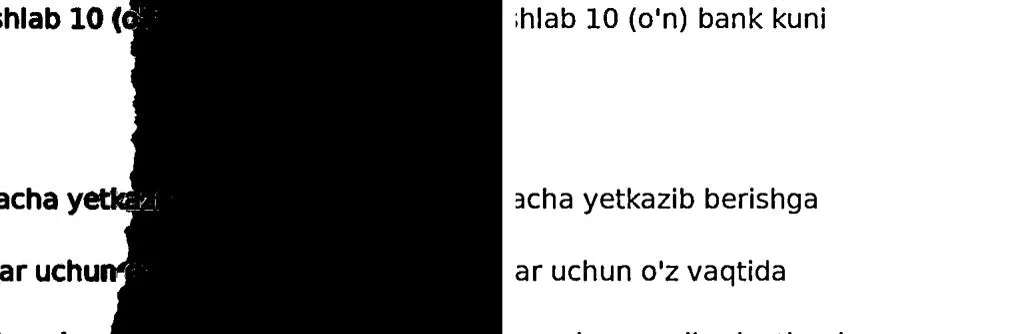
Soyali hudud: chapda Otsu (bitta chegara, matn fonga singib ketgan), o'ngda adaptive threshold
O'qish, qadam-baqadam:
- A, telefon surati. Kulrang: CER 0.25. Otsu: 0.20, deyarli foyda yo'q, chunki bitta chegara soyali va yorug' qismga birdek to'g'ri kelmaydi. Adaptive: 0.003. 3-bobdagi "skaner → Otsu, telefon → adaptive" qoidasining isboti.
- B, deskew. Burchak −3.10° o'lchandi, tuzatilgach +0.04°. CER 0.006 → 0.003, WER 0.035 → 0.007. Tesseract 4 ning LSTM modeli 3° ga chidamli, shuning uchun farq kichik; 5–7° da farq katta bo'ladi. Muhimi: funksiya to'g'ri yo'nalishga buradi (kitobning eski versiyasi teskari burardi, 3-bobdagi izohga qarang).
- C, DPI. ~100 DPI (belgi ~15 px) da 2x kattalashtirish hech narsa bermadi: 0.002 ikkalasida. ~50 DPI (belgi ~8 px) da esa 0.062 → 0.017 (2x) → 0.013 (3x). Qoida aniqlashdi: belgi balandligi 15 px dan past bo'lsagina kattalashtiring.
- D, shovqin. Kutilmagan natija:
fastNlMeansDenoisingtuz-qalampir shovqinda zarar qildi (0.061 → 0.076),medianBlur(3)esa uni yo'q qildi (0.003). NL-means gauss shovqini uchun, median esa alohida nuqtalar uchun. 3-bob jadvalidagi "yoki medianBlur(3)" bejiz emas. - E, toza skan. To'liq zanjir zarar qilmadi (0.002 = 0.002). Demak, zanjirni hamma rasmga qo'llash mumkin.
Talaba ishi. adaptiveThreshold da blockSize ni 11 va 71, C ni 5 va 25 qilib ko'rsin. Qaysi birida harflar "yeyiladi", qaysi birida fon qora dog'ga aylanadi?
4-lab: Tesseract — til, PSM, confidence
lab04_tesseract.py
# lab04_tesseract.py — 4-bob: til, PSM, confidence. Har biri CER bilan.
import re
import time
from pathlib import Path

from ocrlib import ocr_data, ocr_text, ocr_with_confidence, preprocess, score, to_gray

HERE = Path(__file__).parent
S, G = HERE / "samples", HERE / "ground_truth"


def cer_of(img, lang, truth, psm=3):
    t = time.perf_counter()
    text = ocr_text(img, lang=lang, psm=psm)
    return score(truth, text), text, time.perf_counter() - t


print("A) Til tanlash — o'zbek lotin (03_uzb_lotin.png)")
truth = (G / "03_uzb_lotin.txt").read_text(encoding="utf-8")
n_apos = len(re.findall(r"[og]'", truth))                    # haqiqiy matnda nechta o' va g' bor
img = to_gray(S / "03_uzb_lotin.png")
for lang in ("eng", "rus", "uzb", "rus+uzb", "eng+rus+uzb"):
    sc, text, dt = cer_of(img, lang, truth)
    apos = len(re.findall(r"[og]'", text))
    print(f"  lang={lang:12s} CER={sc['cer']:6.3f} WER={sc['wer']:6.3f}  o'/g' topildi={apos:2d}/{n_apos}  ({dt:4.1f} s)")

print("\nB) Til tanlash — o'zbek kirill (04_uzb_kirill.png)")
truth_c = (G / "04_uzb_kirill.txt").read_text(encoding="utf-8")
n_special = sum(truth_c.count(ch) for ch in "ўқғҳЎҚҒҲ")
img = to_gray(S / "04_uzb_kirill.png")
for lang in ("rus", "uzb_cyrl", "rus+uzb_cyrl"):
    sc, text, dt = cer_of(img, lang, truth_c)
    special = sum(text.count(ch) for ch in "ўқғҳЎҚҒҲ")
    print(f"  lang={lang:12s} CER={sc['cer']:6.3f} WER={sc['wer']:6.3f}  ўқғҳ topildi={special:2d}/{n_special}  ({dt:4.1f} s)")

print("\nC) PSM — chek (10_chek_1.jpg): bitta ustunli, lekin qatorlar orasi keng")
truth_r = (G / "10_chek_1.txt").read_text(encoding="utf-8")
img = preprocess(S / "10_chek_1.jpg", "otsu", do_deskew=False)
for psm in (3, 4, 6, 11):
    sc, text, dt = cer_of(img, "uzb", truth_r, psm=psm)
    jami = "JAMI" in text and "95 800" in text
    print(f"  psm={psm:2d}  CER={sc['cer']:6.3f} WER={sc['wer']:6.3f}  'JAMI: 95 800' o'qildi={jami}")
sc, text, _ = cer_of(img, "uzb", truth_r, psm=11)
print("  psm=11 chiqishining boshi:", repr(" ".join(text.split())[:90]))

print("\nD) Confidence — model o'ziga qanchalik ishonadi (05_telefon_soya.jpg, adaptive)")
img = preprocess(S / "05_telefon_soya.jpg", "adaptive", do_deskew=False)
d = ocr_data(img, lang="uzb")
words = [(t, int(float(c))) for t, c in zip(d["text"], d["conf"]) if int(float(c)) > 0 and t.strip()]
avg = sum(c for _, c in words) / len(words)
low = sorted(words, key=lambda w: w[1])[:8]
print(f"  so'zlar: {len(words)}, o'rtacha conf: {avg:.1f}")
print("  eng shubhali 8 ta:", ", ".join(f"{t}({c})" for t, c in low))

print("\nE) Confidence va haqiqiy xato (CER) — bog'liq, lekin bir xil o'lchov emas")
print(f"  {'rasm':22s} {'lang':9s} {'conf':>6s} {'CER':>7s}")
cases = (("03_uzb_lotin.png", "uzb", "otsu"), ("03_uzb_lotin.png", "rus", "otsu"),
         ("04_uzb_kirill.png", "uzb_cyrl", "otsu"), ("04_uzb_kirill.png", "rus", "otsu"),
         ("05_telefon_soya.jpg", "uzb", "otsu"), ("05_telefon_soya.jpg", "uzb", "adaptive"),
         ("12_dogli.png", "uzb", "otsu"), ("07_jadval.png", "uzb", "otsu"))
for name, lang, mode in cases:
    truth = (G / (Path(name).stem + ".txt")).read_text(encoding="utf-8")
    text, conf = ocr_with_confidence(preprocess(S / name, mode), lang=lang, psm=6 if "jadval" in name else 3)
    print(f"  {name:22s} {lang:9s} {conf:6.1f} {score(truth, text)['cer']:7.3f}   ({mode})")
A) Til tanlash — o'zbek lotin (03_uzb_lotin.png)
  lang=eng          CER= 0.012 WER= 0.084  o'/g' topildi=10/11  ( 0.8 s)
  lang=rus          CER= 0.786 WER= 0.916  o'/g' topildi= 0/11  ( 0.9 s)
  lang=uzb          CER= 0.002 WER= 0.007  o'/g' topildi=11/11  ( 1.1 s)
  lang=rus+uzb      CER= 0.008 WER= 0.007  o'/g' topildi=11/11  ( 1.2 s)
  lang=eng+rus+uzb  CER= 0.002 WER= 0.007  o'/g' topildi=11/11  ( 1.2 s)

B) Til tanlash — o'zbek kirill (04_uzb_kirill.png)
  lang=rus          CER= 0.026 WER= 0.172  ўқғҳ topildi= 0/23  ( 0.7 s)
  lang=uzb_cyrl     CER= 0.005 WER= 0.033  ўқғҳ topildi=23/23  ( 1.0 s)
  lang=rus+uzb_cyrl CER= 0.005 WER= 0.033  ўқғҳ topildi=21/23  ( 1.1 s)

C) PSM — chek (10_chek_1.jpg): bitta ustunli, lekin qatorlar orasi keng
  psm= 3  CER= 0.031 WER= 0.180  'JAMI: 95 800' o'qildi=True
  psm= 4  CER= 0.031 WER= 0.180  'JAMI: 95 800' o'qildi=True
  psm= 6  CER= 0.022 WER= 0.140  'JAMI: 95 800' o'qildi=True
  psm=11  CER= 0.522 WER= 1.120  'JAMI: 95 800' o'qildi=True
  psm=11 chiqishining boshi: 'KORZINKA SUPERMARKET INN 302145678 Sana: 15.01.2024 18:42 - m — a a a a a – – – – – –- – ш'

D) Confidence — model o'ziga qanchalik ishonadi (05_telefon_soya.jpg, adaptive)
  so'zlar: 143, o'rtacha conf: 95.4
  eng shubhali 8 ta: N2:(66), Ijrochi(86), MChJ(89), Ijrochi(91), Shartnoma(92), jihozlarini(94), yetkazib(94), 2024-yil(95)

E) Confidence va haqiqiy xato (CER) — bog'liq, lekin bir xil o'lchov emas
  rasm                   lang        conf     CER
  03_uzb_lotin.png       uzb         95.5   0.002   (otsu)
  03_uzb_lotin.png       rus         50.7   0.808   (otsu)
  04_uzb_kirill.png      uzb_cyrl    94.2   0.002   (otsu)
  04_uzb_kirill.png      rus         91.9   0.026   (otsu)
  05_telefon_soya.jpg    uzb         91.6   0.200   (otsu)
  05_telefon_soya.jpg    uzb         95.8   0.002   (adaptive)
  12_dogli.png           uzb         80.3   0.097   (otsu)
  07_jadval.png          uzb         50.5   0.891   (otsu)
- A, til.
uzb: CER 0.002, 11 tao'/g'ning hammasi.eng: 0.012, bittasini yo'qotdi.ruslotin matnda: 0.786, ya'ni chiqish deyarli to'liq bema'ni (kirill modeli lotin harflarni kirillga "o'xshatadi").rus+uzb: 0.008, faqatuzbdan yomonroq. 4-bob: keraksiz til qo'shmang. - B, kirill.
rusmodeli o'zbek kirill matnini 0.026 bilan o'qiydi, lekin 23 ta ў қ ғ ҳ ning birortasini saqlamaydi, hammasi rus harfiga aylanadi.uzb_cyrl: 0.005, 23/23. Bu 5-bobdagi EasyOCR muammosi bilan bir xil (5-lab). - C, PSM. Chek bitta ustun, lekin qatorlar orasi keng. PSM 6 (yaxlit blok) eng yaxshi: 0.022. PSM 11 (siyrak matn) esa 0.522 va WER 1.12: har ustunni alohida blok qilib, so'zlar tartibini buzadi. 4-bobdagi PSM jadvali shunga ko'ra tuzatildi: 11 sochilgan yozuvlar uchun (forma, ID karta), tartibli chek uchun 4 yoki 6. Qoida o'zgarmadi: g'alati natija → avval PSM ni o'zgartiring, lekin qaysi tomonga ekanini CER aytadi.
- D, confidence. Eng shubhali so'z
№belgisi (66): Tesseract uniNeyokiМ:deb o'qiydi. Bu barcha o'zbek va rus hujjatlarida uchraydigan doimiy xato, post-processing qoidasi uchun nomzod. - E, confidence va CER. Noto'g'ri tilda conf 50.7 va CER 0.81: bu yerda model halol. Lekin telefon suratida Otsu bilan conf 91.6, CER esa 0.20. Model topgan so'zlariga ishonadi, topmagan 29 ta so'z esa hisobga kirmaydi. Confidence "model qanchalik ishonchli" degani, "matn qanchalik to'g'ri" degani emas. Shuning uchun 9-bob (ground truth) kerak va shuning uchun
ocr_statsso'zlar sonini ham qaytaradi.
5-lab: EasyOCR vs Tesseract
EasyOCR birinchi chaqiruvda detection (CRAFT) va recognition modellarini yuklab oladi. Bu mashinada yuklash 10 daqiqadan oshdi. Darsdan oldin bir marta ishga tushiring, aks holda auditoriyada internetga qarab o'tirasiz.
lab05_easyocr.py
# lab05_easyocr.py — 5-bob: EasyOCR vs Tesseract. Surat rejimida kim kuchli, o'zbek tilida nima bo'ladi.
# EasyOCR birinchi chaqiruvda modelni yuklab oladi (~100 MB) — darsdan oldin bir marta ishga tushiring.
import time
from pathlib import Path

import easyocr

from ocrlib import ocr_text, preprocess, score, to_gray

HERE = Path(__file__).parent
S, G = HERE / "samples", HERE / "ground_truth"


def easy(reader, path):
    t = time.perf_counter()
    res = reader.readtext(str(path), paragraph=False)   # [(bbox, text, conf), ...]
    text = "\n".join(r[1] for r in res if r[2] > 0.3)
    return text, time.perf_counter() - t, res


print("A) Telefon surati, lotin (05_telefon_soya.jpg) — preprocessing SIZ")
truth = (G / "03_uzb_lotin.txt").read_text(encoding="utf-8")
t = time.perf_counter()
text = ocr_text(to_gray(S / "05_telefon_soya.jpg"), lang="uzb")
print(f"  Tesseract uzb (kulrang)         CER={score(truth, text)['cer']:.3f}  ({time.perf_counter() - t:4.1f} s)")
t = time.perf_counter()
text = ocr_text(preprocess(S / "05_telefon_soya.jpg", "adaptive"), lang="uzb")
print(f"  Tesseract uzb (adaptive)        CER={score(truth, text)['cer']:.3f}  ({time.perf_counter() - t:4.1f} s)")
reader_en = easyocr.Reader(["en"], gpu=False, verbose=False)   # o'zbek yo'q -> en modeli
text, dt, res = easy(reader_en, S / "05_telefon_soya.jpg")
print(f"  EasyOCR ['en'] (asl surat)      CER={score(truth, text)['cer']:.3f}  ({dt:4.1f} s, {len(res)} ta ramka)")
print("  EasyOCR birinchi 3 qator:", [r[1] for r in res[:3]])

print("\nB) O'zbek kirill (04_uzb_kirill.png): ў қ ғ ҳ harflari")
truth_c = (G / "04_uzb_kirill.txt").read_text(encoding="utf-8")
text = ocr_text(preprocess(S / "04_uzb_kirill.png", "otsu"), lang="uzb_cyrl")
print(f"  Tesseract uzb_cyrl              CER={score(truth_c, text)['cer']:.3f}  ўқғҳ={sum(text.count(c) for c in 'ўқғҳЎҚҒҲ')}")
reader_ru = easyocr.Reader(["ru"], gpu=False, verbose=False)
text, dt, res = easy(reader_ru, S / "04_uzb_kirill.png")
print(f"  EasyOCR ['ru']                  CER={score(truth_c, text)['cer']:.3f}  ўқғҳ={sum(text.count(c) for c in 'ўқғҳЎҚҒҲ')}  ({dt:4.1f} s)")
print("  EasyOCR 'шаҳри' so'zini qanday o'qidi:", [r[1] for r in res if "ша" in r[1].lower()][:2])

print("\nC) Toza rus skan (02_skan_rus.png): ikkalasi ham yaxshi, farq tezlikda")
truth_r = (G / "02_skan_rus.txt").read_text(encoding="utf-8")
t = time.perf_counter()
text = ocr_text(preprocess(S / "02_skan_rus.png", "otsu"), lang="rus")
print(f"  Tesseract rus                   CER={score(truth_r, text)['cer']:.3f}  ({time.perf_counter() - t:4.1f} s)")
text, dt, res = easy(reader_ru, S / "02_skan_rus.png")
print(f"  EasyOCR ['ru']                  CER={score(truth_r, text)['cer']:.3f}  ({dt:4.1f} s)")
Downloading detection model, please wait. This may take several minutes depending upon your network connection.
Downloading recognition model, please wait. This may take several minutes depending upon your network connection.
  w_ih = torch.quantize_per_tensor(
Downloading recognition model, please wait. This may take several minutes depending upon your network connection.
A) Telefon surati, lotin (05_telefon_soya.jpg) — preprocessing SIZ
  Tesseract uzb (kulrang)         CER=0.251  ( 0.9 s)
  Tesseract uzb (adaptive)        CER=0.002  ( 1.2 s)
  EasyOCR ['en'] (asl surat)      CER=0.036  ( 7.2 s, 29 ta ramka)
  EasyOCR birinchi 3 qator: ['SHARTNOMA Ne 45', 'Toshkent shahri, 2024-yil 15-yanvar', '"Nihol" MChJ nomidan direktor Karimov Anvar Rustamovich,']

B) O'zbek kirill (04_uzb_kirill.png): ў қ ғ ҳ harflari
  Tesseract uzb_cyrl              CER=0.002  ўқғҳ=23
  EasyOCR ['ru']                  CER=0.055  ўқғҳ=0  ( 8.8 s)
  EasyOCR 'шаҳри' so'zini qanday o'qidi: ['ШАРТНОМА &: 45', 'Тошкент шахри, 2024 йил 15 январь']

C) Toza rus skan (02_skan_rus.png): ikkalasi ham yaxshi, farq tezlikda
  Tesseract rus                   CER=0.000  ( 0.8 s)
  EasyOCR ['ru']                  CER=0.018  ( 7.8 s)
- Telefon surati, preprocessing siz. Tesseract 0.251, EasyOCR 0.036. Neyron detection soyani yengadi, 5-bob to'g'ri. Lekin Tesseract + adaptive threshold 0.002 va 7 marta tez. Xulosa: surat uchun yo EasyOCR, yo Tesseract + to'g'ri preprocessing; ikkinchisi arzon.
- Kirill. EasyOCR
rumodeli 23 ta ў қ ғ ҳ ning birortasini bermadi ("шаҳри" → "шахри"). O'zbek kirill uchun Tesseractuzb_cyrlyoki VLM. 5-bobdagi "O'zbek tili muammosi" ning raqamli isboti. - Toza rus skan. Tesseract 0.000 va 0.8 s, EasyOCR 0.018 va 7.8 s. Toza skanda EasyOCR hech narsa qo'shmaydi.
6-lab: VLM — Qwen2.5-VL bilan
Kod 6-bobdagi bilan bir xil: Ollama ning OpenAI-compatible API si, temperature=0. Model bu mashinada GPU da ishladi (sahifaga 2–10 s). GPU siz laptopda 7B model sahifaga bir necha daqiqa oladi: darsda oldindan saqlangan chiqishni ko'rsating yoki qwen2.5vl:3b oling. Rasmlar 1600 px gacha kichraytiriladi: katta rasm sekin va tokenlarni ko'paytiradi.
lab06_vlm.py
# lab06_vlm.py — 6-bob: VLM bilan OCR. Ollama + OpenAI-compatible API (kitobdagi kod bilan bir xil).
# Muhit: OLLAMA_HOST (default http://localhost:11434), VLM_MODEL (default qwen2.5vl:7b).
# 5 ta tajriba: (A) surat -> matn va CER, (B) jadval -> Markdown va katak aniqligi,
# (C) maydon ajratish -> JSON, (D) hallucination: xira raqam, (E) [NOANIQ] himoyasi.
import base64
import io
import json
import os
import re
import time
from pathlib import Path

from openai import OpenAI
from PIL import Image

from ocrlib import ocr_text, ocr_with_confidence, preprocess, score

HERE = Path(__file__).parent
S, G, OUT = HERE / "samples", HERE / "ground_truth", HERE / "out"
OUT.mkdir(exist_ok=True)
HOST = os.environ.get("OLLAMA_HOST", "http://localhost:11434")
MODEL = os.environ.get("VLM_MODEL", "qwen2.5vl:7b")
client = OpenAI(base_url=f"{HOST}/v1", api_key="ollama")


def b64(path, max_side=1600):
    """Rasmni base64 ga. Juda katta rasm sekin va tokenlarni ko'paytiradi: 1600 px gacha kichraytiramiz."""
    im = Image.open(path).convert("RGB")
    im.thumbnail((max_side, max_side))
    buf = io.BytesIO()
    im.save(buf, format="PNG")
    return base64.b64encode(buf.getvalue()).decode()


def ask(image_path, prompt, model=MODEL, clean=True):
    t = time.perf_counter()
    r = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": [
            {"type": "text", "text": prompt},
            {"type": "image_url", "image_url": {"url": f"data:image/png;base64,{b64(image_path)}"}},
        ]}],
        temperature=0,
    )
    text = r.choices[0].message.content.strip()
    return (strip_fences(text) if clean else text), time.perf_counter() - t


# Birinchi urinishdagi prompt (kitob, 6-bob). Natija: model o'zbek LOTIN matnini KIRILLGA o'girib berdi
# va ```markdown qavsiga o'radi -> CER 0.41. Shuning uchun quyidagi qat'iy variant:
OCR_PROMPT_V1 = ("Rasmdagi barcha matnni o'qib ber. Tuzilishini saqla: sarlavhalar, ro'yxatlar. "
                 "Jadvallarni Markdown formatida qaytar. O'zingdan hech narsa qo'shma, izoh yozma.")
OCR_PROMPT = ("Rasmdagi matnni AYNAN yozilganidek ko'chir: qaysi alifboda bo'lsa (lotin yoki kirill) shu alifboda, "
              "tarjima qilma, alifboni o'zgartirma, imloni tuzatma. Qatorlar va paragraflarni saqla. "
              "Markdown belgilari, ``` qavslar, izoh yoki sarlavha qo'shma. Faqat rasmdagi matn.")


def strip_fences(text):
    """Model ```markdown ... ``` bilan o'rasa, qavslarni olib tashlaymiz (post-processing)."""
    return re.sub(r"^```[a-z]*\s*|\s*```$", "", text.strip(), flags=re.I | re.M).strip()


print(f"Model: {MODEL}  ({HOST})")

print("\nA0) Prompt intizomi (03_uzb_lotin.png, toza skan): kitobdagi prompt vs qat'iy prompt")
truth = (G / "03_uzb_lotin.txt").read_text(encoding="utf-8")
for label, p in (("kitob prompti", OCR_PROMPT_V1), ("qat'iy prompt", OCR_PROMPT)):
    text, dt = ask(S / "03_uzb_lotin.png", p)
    cyr = sum(ch.isalpha() and "Ѐ" <= ch <= "ӿ" for ch in text)
    print(f"  {label:14s} CER={score(truth, strip_fences(text))['cer']:.3f}  kirill harflar={cyr:4d}  ``` bormi={'```' in text}  ({dt:.1f} s)")
    print("     boshi:", repr(text[:70]))

print("\nA) Telefon surati (05_telefon_soya.jpg) — asl surat, preprocessing siz")
text, dt = ask(S / "05_telefon_soya.jpg", OCR_PROMPT)
(OUT / "lab06_A_vlm.txt").write_text(text, encoding="utf-8")
print(f"  VLM:                 CER={score(truth, text)['cer']:.3f}  WER={score(truth, text)['wer']:.3f}  ({dt:.1f} s)")
t = time.perf_counter()
tess = ocr_text(preprocess(S / "05_telefon_soya.jpg", "adaptive"), lang="uzb")
print(f"  Tesseract+adaptive:  CER={score(truth, tess)['cer']:.3f}  WER={score(truth, tess)['wer']:.3f}  ({time.perf_counter() - t:.1f} s)")
print("  VLM birinchi 2 qator:", text.splitlines()[:2])

print("\nB) Jadval (07_jadval.png) -> Markdown")
md, dt = ask(S / "07_jadval.png", "Rasmdagi jadvalni Markdown jadval qilib qaytar. Boshqa hech narsa yozma.")
(OUT / "lab06_B_table.md").write_text(md, encoding="utf-8")
rows = [[c.strip() for c in ln.strip().strip("|").split("|")] for ln in md.splitlines() if ln.strip().startswith("|") and not re.match(r"^\|?\s*:?-+", ln.strip())]
truth_rows = [ln.split(" | ") for ln in (G / "07_jadval.txt").read_text(encoding="utf-8").splitlines()]
flat_t = [c for r in truth_rows for c in r]
flat_p = [c for r in rows for c in r]
hits = sum(1 for c in flat_t if c in flat_p)
print(f"  {len(rows)} qator, katak aniqligi: {hits}/{len(flat_t)}  ({dt:.1f} s)")
print("  " + "\n  ".join(md.splitlines()[:4]))

print("\nC) Maydon ajratish -> JSON (03_uzb_lotin.png)")
js, dt = ask(S / "03_uzb_lotin.png",
             "Bu shartnoma. Faqat quyidagilarni JSON qilib qaytar: shartnoma_raqami, sana, buyurtmachi, ijrochi, summa. "
             "Topilmagan maydon uchun null yoz. Faqat JSON, boshqa matn yozma.")
m = re.search(r"\{.*\}", js, re.S)
try:
    data = json.loads(m.group(0)) if m else None
except json.JSONDecodeError:
    data = None
print(f"  ({dt:.1f} s) JSON to'g'ri o'qildi: {data is not None}")
print("  ", data if data else js[:200])

def clause_12(text):
    """1.1-band tugagandan 1.3-band boshlangungacha nima bor? Xiralashtirilgan 1.2-band shu oraliqda bo'lishi kerak."""
    flat = " ".join(text.split())
    a, b = flat.find("1.1."), flat.find("1.3.")
    if a < 0 or b < 0:
        return "(1.1/1.3 topilmadi)"
    seg = flat[a:b]
    seg = seg[seg.find("ko'rsatadi.") + len("ko'rsatadi."):].strip() if "ko'rsatadi." in seg else seg
    return seg[:170] if seg else "(bo'sh: 1.2-band butunlay tashlab yuborilgan)"


print("\nD) Hallucination: 1.2-band butunlay xira (13_xira_raqam.png) — raqam ham, so'z bilan yozilgani ham")
tess, tconf = ocr_with_confidence(preprocess(S / "13_xira_raqam.png", "otsu"), lang="uzb")
print("  Tesseract shu joyda:", repr(clause_12(tess)), f"(o'rtacha conf {tconf:.0f}; xira so'zlar past conf yoki tashlab yuborilgan)")
text, dt = ask(S / "13_xira_raqam.png", OCR_PROMPT)
(OUT / "lab06_D_blur.txt").write_text(text, encoding="utf-8")
print(f"  ({dt:.1f} s) VLM shu joyda:      {clause_12(text)!r}")
print("  Haqiqat: '17 500 000 (o'n yetti million besh yuz ming) so'm'. Ogohlantirish bordimi:",
      any(w in text.lower() for w in ("noaniq", "o'qib bo'lmadi", "aniq emas", "[?]", "...")))

print("\nE) Himoya: promptga [NOANIQ] taqiqi")
text2, dt = ask(S / "13_xira_raqam.png", OCR_PROMPT + " Aniq o'qiy olmagan joyni [NOANIQ] deb belgila, taxmin qilma.")
(OUT / "lab06_E_blur_noaniq.txt").write_text(text2, encoding="utf-8")
print(f"  ({dt:.1f} s) VLM shu joyda:      {clause_12(text2)!r}")
print("  [NOANIQ] ishlatildi:", "[NOANIQ]" in text2)

print("\nF) Toza skan (03_uzb_lotin.png): VLM ga isrofmi?")
text, dt = ask(S / "03_uzb_lotin.png", OCR_PROMPT)
t = time.perf_counter()
tess = ocr_text(preprocess(S / "03_uzb_lotin.png", "otsu"), lang="uzb")
dt_t = time.perf_counter() - t
print(f"  VLM       CER={score(truth, text)['cer']:.3f}  ({dt:.1f} s)")
print(f"  Tesseract CER={score(truth, tess)['cer']:.3f}  ({dt_t:.1f} s)")
Chiqish (qwen2.5vl:7b, RTX 5070 Ti)
Model: qwen2.5vl:7b  (http://192.168.240.1:11435)

A0) Prompt intizomi (03_uzb_lotin.png, toza skan): kitobdagi prompt vs qat'iy prompt
  kitob prompti  CER=0.469  kirill harflar= 485  ``` bormi=False  (5.0 s)
     boshi: '# Шартнома № 45\n\n**Ташкент шаҳри, 2024-йил 15-январ**\n\n"Нибол" МЧЖ ном'
  qat'iy prompt  CER=0.013  kirill harflar=   0  ``` bormi=False  (4.1 s)
     boshi: 'SHARTNOMA № 45\n\nToshkent shahri, 2024-yil 15-yanvar\n\n"NIHOL" MChJ nomi'

A) Telefon surati (05_telefon_soya.jpg) — asl surat, preprocessing siz
  VLM:                 CER=0.004  WER=0.007  (3.9 s)
  Tesseract+adaptive:  CER=0.002  WER=0.007  (1.1 s)
  VLM birinchi 2 qator: ['SHARTNOMA № 45', '']

B) Jadval (07_jadval.png) -> Markdown
  7 qator, katak aniqligi: 27/28  (2.0 s)
  | Mahsulot           | Miqdor | Narx (so'm) | Jami |
  |--------------------|--------|-------------|------|
  | Monitor 24 dyuym   | 4      | 1 850 000   | 7 400 000 |
  | Klaviatura         | 10     | 180 000     | 1 800 000 |

C) Maydon ajratish -> JSON (03_uzb_lotin.png)
  (1.1 s) JSON to'g'ri o'qildi: True
   {'shartnoma_raqami': '45', 'sana': '2024-yil 15-yanvar', 'buyurtmachi': None, 'ijrochi': None, 'summa': '17 500 000'}

D) Hallucination: 1.2-band butunlay xira (13_xira_raqam.png) — raqam ham, so'z bilan yozilgani ham
  Tesseract shu joyda: "(bo'sh: 1.2-band butunlay tashlab yuborilgan)" (o'rtacha conf 95; xira so'zlar past conf yoki tashlab yuborilgan)
  (4.0 s) VLM shu joyda:      "(bo'sh: 1.2-band butunlay tashlab yuborilgan)"
  Haqiqat: '17 500 000 (o'n yetti million besh yuz ming) so'm'. Ogohlantirish bordimi: False

E) Himoya: promptga [NOANIQ] taqiqi
  (3.8 s) VLM shu joyda:      "(bo'sh: 1.2-band butunlay tashlab yuborilgan)"
  [NOANIQ] ishlatildi: True

F) Toza skan (03_uzb_lotin.png): VLM ga isrofmi?
  VLM       CER=0.013  (4.1 s)
  Tesseract CER=0.002  (1.1 s)
Bu labning eng muhim natijasi kitobda yo'q edi:
- A0, prompt intizomi. Kitobdagi prompt bilan model o'zbek lotin shartnomasini o'z xohishi bilan kirillga o'girib berdi (485 ta kirill harf, Markdown sarlavha va qalin shrift bilan): CER 0.469 (oldingi ishga tushirishda 0.453:
temperature=0bo'lsa ham GPU da natija so'zma-so'z takrorlanmaydi, shuning uchun VLM ni bir marta emas, bir necha marta o'lchang). Xatosi ko'rinmasdi: matn ravon, tuzilishi to'g'ri, faqat alifbo boshqa. Qat'iy prompt ("qaysi alifboda bo'lsa shu alifboda, tarjima qilma, alifboni o'zgartirma, Markdown qo'shma") bilan: CER 0.013, kirill 0. 6-bobdagi "O'zingdan hech narsa qo'shma" yetarli emas: model alifbo almashtirishni "qo'shish" deb hisoblamaydi. Har yangi model bilan A0 ni qayta o'tkazing. - A, telefon surati. Asl surat, preprocessing siz: VLM CER 0.004. Tesseract + adaptive 0.002, lekin 5 marta tez. VLM soyani o'zi yengadi, bu uning kuchi; narxi vaqt va GPU.
- B, jadval. Tesseract 13 ta so'z topgan jadvalni VLM Markdown jadval qilib qaytardi, 28 katakdan 27 tasi to'g'ri, 3.4 sekund. Jadval VLM ning maydoni.
- C, JSON. Raqam, sana, summa topildi; buyurtmachi va ijrochi
null, garchi matnda bor. Prompt "topilmagan maydon uchun null" degan edi, model ehtiyot bo'ldi. Bu yaxshi xatti-harakat: to'qib yozmadi. Maydon nomlarini aniqroq ta'riflash ("buyurtmachi: birinchi tomon tashkiloti nomi") natijani yaxshilaydi. - D, xira band. Birinchi urinishda faqat raqam xiralashtirilgan edi, so'z bilan yozilgani ("o'n yetti million") ochiq qolgan: model raqamni so'zlardan tikladi va to'g'ri chiqdi. Bu hallucination emas, kontekst. Shuning uchun 0-lab ikkala qatorni xiralashtiradi. Endi natija: Tesseract ham, VLM ham 1.2-bandni butunlay tashlab yubordi. 1.1 dan keyin darhol 1.3. Tesseract: so'zlar soni 143 dan 127 ga tushdi, o'rtacha conf esa 95 (topilgan so'zlar yaxshi o'qilgan). VLM: hech qanday ogohlantirishsiz, matn ravon. Shartnomada summa bandi yo'qoldi va buni hech kim sezmaydi. To'qib yozishdan kam xavfli emas.
- E, [NOANIQ]. Taqiq qo'shilgan prompt bilan model
[NOANIQ]belgisini qo'ydi, lekin band o'rniga emas, hujjatning eng oxiriga: 1.1 dan keyin yana darhol 1.3, belgi esa oxirgi qatorda. Ya'ni "nimadir o'qilmadi" degan signal bor, "qayerda" degani yo'q. Bu ham foydali: post-processing belgini topsa, sahifa odamga boradi. Ikkinchi himoya esa promptga bog'liq emas: Tesseract topgan so'zlar soni (127) ni toza sahifa bilan (143) solishtirish, 16 ta so'z yo'q. 10-bobdagi VLM promptiga[NOANIQ]qoidasi shuning uchun kiritilgan, lekin unga yolg'iz ishonmang. - F, toza skan. Tesseract 0.002 va 1 s. VLM sekinroq va (prompt to'g'ri bo'lsa ham) aniqroq emas. Oddiy matnga VLM isrof.
Qaysi model: bu mashinada
qwen2.5vl:7b(kitobdagi) ishlatildi.ollama listdaqwen3.5:9bham vision bilan bor; u "thinking" rejimida ishlaydi, OCR uchunthink: falsebilan chaqirish kerak (Ollama native API). Modelni almashtirish:VLM_MODEL=qwen3.5:9b python lab06_vlm.py, va A0 ni qayta o'qing: har model har xil "o'zboshimchalik" qiladi.
7-lab: PDF — sahifama-sahifa qaror
Uchta PDF: digital, skan, aralash. Fayl darajasidagi is_scanned (7-bob) aralash PDF ni "digital" deydi, chunki birinchi sahifada matn bor. Sahifama-sahifa tekshiruv (10-bob) 2- va 3-sahifani OCR ga yuboradi. PDF sahifasi rasmga PyMuPDF bilan aylantiriladi (poppler o'rnatilmagan mashinada ham ishlaydi; pdf2image bilan farqi yo'q).
lab07_pdf.py
# lab07_pdf.py — 7-bob: PDF ning uch turi va sahifama-sahifa qaror.
# 01_digital.pdf (matn bor), 02_skan_rus.pdf (faqat rasm), 09_aralash.pdf (digital + skan + telefon).
from pathlib import Path

from ocrlib import ocr_stats, ocr_with_confidence, pdf_page_count, pdf_page_text, preprocess, quality_gate, render_pdf_page

HERE = Path(__file__).parent
S = HERE / "samples"
MIN_CHARS = 100
CONF_THRESHOLD = 60


def is_scanned_file(pdf, first_pages=3):
    """7-bobdagi fayl darajasidagi tekshiruv: birinchi 3 sahifada matn bormi?"""
    n = pdf_page_count(pdf)
    for i in range(1, min(first_pages, n) + 1):
        if len(pdf_page_text(pdf, i).strip()) >= MIN_CHARS:
            return False
    return True


for name in ("01_digital.pdf", "02_skan_rus.pdf", "09_aralash.pdf"):
    pdf = S / name
    n = pdf_page_count(pdf)
    print(f"\n{name}: {n} sahifa, fayl darajasida is_scanned = {is_scanned_file(pdf)}")
    for i in range(1, n + 1):
        chars = len(pdf_page_text(pdf, i).strip())
        if chars >= MIN_CHARS:
            print(f"  sahifa {i}: text_layer   ({chars} belgi) -> OCR kerak emas")
            continue
        img = render_pdf_page(pdf, i, dpi=200)
        lang = "rus" if "rus" in name or i == 2 else "uzb"
        # 1-urinish: skaner deb Otsu; conf past bo'lsa telefon surati deb adaptive
        text, conf = ocr_with_confidence(preprocess(img, "otsu"), lang=lang)
        mode = "otsu"
        if conf < CONF_THRESHOLD:
            text2, conf2 = ocr_with_confidence(preprocess(img, "adaptive"), lang=lang)
            if conf2 > conf:
                text, conf, mode = text2, conf2, "adaptive"
        decision = "ocr_tesseract" if conf >= CONF_THRESHOLD else "VLM fallback (6-bob)"
        print(f"  sahifa {i}: rasm ({img.size[0]}x{img.size[1]}) -> {mode:8s} conf={conf:5.1f} -> {decision}")
        print(f"           '{text[:70].replace(chr(10), ' ')}...'")

print("\nDarvoza faqat o'rtacha conf ga qarasa nima bo'ladi? (15_juda_xira.jpg, ochiq surat, juda xira)")
for mode in ("otsu", "adaptive"):
    text, st = ocr_stats(preprocess(S / "15_juda_xira.jpg", mode), lang="uzb")
    print(f"  {mode:9s} conf={st['conf']:5.1f} (chegara 60 dan yuqori!)  past-conf so'zlar={st['low_ratio']:.0%}  "
          f"so'zlar={st['words']}  -> quality_gate: {quality_gate('ocr_tesseract', st)}")
print("  Xulosa: o'rtacha conf 85 bo'lsa ham haqiqiy CER 0.31 (11-bob, 4-lab). Past-conf so'zlar ulushi (>10%) uni ushlaydi.")
01_digital.pdf: 1 sahifa, fayl darajasida is_scanned = False
  sahifa 1: text_layer   (1112 belgi) -> OCR kerak emas

02_skan_rus.pdf: 1 sahifa, fayl darajasida is_scanned = True
  sahifa 1: rasm (1653x2339) -> otsu     conf= 95.2 -> ocr_tesseract
           'ДОГОВОР № 45 г. Ташкент, 15 января 2024 г.  ООО "Нихол" в лице директо...'

09_aralash.pdf: 3 sahifa, fayl darajasida is_scanned = False
  sahifa 1: text_layer   (1112 belgi) -> OCR kerak emas
  sahifa 2: rasm (1653x2339) -> otsu     conf= 95.2 -> ocr_tesseract
           'ДОГОВОР № 45 г. Ташкент, 15 января 2024 г.  ООО "Нихол" в лице директо...'
  sahifa 3: rasm (1653x2339) -> otsu     conf= 92.5 -> ocr_tesseract
           'SHARTNOMA Ne 45  Toshkent shahri, 2024-yil 15-ya  "Nihol" MChJ nomidan...'

Darvoza faqat o'rtacha conf ga qarasa nima bo'ladi? (15_juda_xira.jpg, ochiq surat, juda xira)
  otsu      conf= 85.5 (chegara 60 dan yuqori!)  past-conf so'zlar=12%  so'zlar=108  -> quality_gate: manual_review
  adaptive  conf= 74.3 (chegara 60 dan yuqori!)  past-conf so'zlar=28%  so'zlar=141  -> quality_gate: manual_review
  Xulosa: o'rtacha conf 85 bo'lsa ham haqiqiy CER 0.31 (11-bob, 4-lab). Past-conf so'zlar ulushi (>10%) uni ushlaydi.
Oxirgi qism darvoza haqida. Juda xira suratda o'rtacha confidence 85.5: 8-bobdagi darvoza (chegara 60) uni "accept" deydi. Haqiqiy CER esa 0.31 (9-lab jadvali). Past-conf so'zlar ulushi 12% (yaxshi sahifada 1% dan kam) uni ushlaydi. ocrlib.quality_gate shu uchta signalni birga ishlatadi: o'rtacha conf, past-conf ulushi, so'zlar soni. 12-bob 7-loyihada aynan shu sahifa VLM ga tushadi.
8-lab: tozalash va chunking
lab08_clean_chunk.py
# lab08_clean_chunk.py — 8-bob: OCR matni chunker uchun nega iflos, tozalash nimani o'zgartiradi.
from dataclasses import dataclass
from pathlib import Path

from ocrlib import clean_ocr_text, ocr_text, ocr_with_confidence, preprocess

HERE = Path(__file__).parent
S = HERE / "samples"


def paragraph_chunks(text, max_chars=600):
    """RAG qo'llanmasidagi paragraf chunker: \\n\\n bo'yicha bo'lish, kichiklarini qo'shish."""
    paras = [p.strip() for p in text.split("\n\n") if p.strip()]
    chunks, cur = [], ""
    for p in paras:
        if cur and len(cur) + len(p) > max_chars:
            chunks.append(cur)
            cur = p
        else:
            cur = (cur + "\n\n" + p).strip()
    if cur:
        chunks.append(cur)
    return chunks


img = preprocess(S / "03_uzb_lotin.png", "otsu")

def stats(text, label):
    paras = [p for p in text.split("\n\n") if p.strip()]
    inner_breaks = sum(p.count("\n") for p in paras)          # paragraf ICHIDAGI qator uzilishlari
    ch = paragraph_chunks(text)
    print(f"   {label:28s} paragraf={len(paras):2d}  ichki \\n={inner_breaks:3d}  chunk={len(ch)}  "
          f"o'rtacha chunk={sum(map(len, ch)) // len(ch)} belgi")


print("A) image_to_string chiqishi: paragraflar \\n\\n bilan, lekin har vizual qator \\n bilan tugaydi")
raw = ocr_text(img, lang="uzb")
print("   birinchi 6 qator:", repr(raw.splitlines()[:6]))
stats(raw, "xom (image_to_string)")

print("\nB) image_to_data + qator/paragraf guruhlash (10-bob ocr_with_confidence)")
text, conf = ocr_with_confidence(img, lang="uzb")
stats(text, "guruhlangan (image_to_data)")

print("\nC) clean_ocr_text dan keyin: paragraflar soni o'zgarmaydi, ichki \\n yo'qoladi")
clean = clean_ocr_text(text)
stats(clean, "tozalangan")
print("   3-paragraf, oldin:", repr(text.split("\n\n")[3][:110]))
print("   3-paragraf, keyin:", repr(clean.split("\n\n")[3][:110]))
print("   Nega muhim: 'yetkazib\\nberish' ikki alohida token, 'yetkazib berish' esa bitta ibora —"
      " keyword qidiruv va embedding uchun farq shu yerda.")

print("\nD) Bo'g'in ko'chirish namunasi (sun'iy):")
sample = "Shartnoma tomonlari o'z zimma-\nsiga olgan majburiyatlarni to'-\nliq bajaradi.\n\n- 3 -\n\nYangi paragraf."
print("   oldin:", repr(sample))
print("   keyin:", repr(clean_ocr_text(sample)))


@dataclass
class PageResult:
    page_num: int
    text: str
    method: str
    confidence: float


def quality_gate(p):
    if p.method == "text_layer":
        return "accept"
    if p.method == "ocr_vlm":
        return "accept_with_flag"
    if p.confidence >= 80:
        return "accept"
    if p.confidence >= 60:
        return "accept_with_flag"
    return "manual_review"


print("\nE) Quality gate (8-bob):")
for p in (PageResult(1, "...", "text_layer", 100), PageResult(2, "...", "ocr_tesseract", 91.4),
          PageResult(3, "...", "ocr_tesseract", 67.0), PageResult(4, "...", "ocr_tesseract", 42.5),
          PageResult(5, "...", "ocr_vlm", -1)):
    print(f"   sahifa {p.page_num}: {p.method:14s} conf={p.confidence:6.1f} -> {quality_gate(p)}")
A) image_to_string chiqishi: paragraflar \n\n bilan, lekin har vizual qator \n bilan tugaydi
   birinchi 6 qator: ['SHARTNOMA Ne 45', 'Toshkent shahri, 2024-yil 15-yanvar', '', '"Nihol" MChJ nomidan direktor Karimov Anvar Rustamovich,', 'bundan buyon "Buyurtmachi" deb ataladi, bir tomondan, va', '"Barakat Servis" MChJ nomidan direktor Yusupova Dilnoza']
   xom (image_to_string)        paragraf=14  ichki \n= 13  chunk=2  o'rtacha chunk=562 belgi

B) image_to_data + qator/paragraf guruhlash (10-bob ocr_with_confidence)
   guruhlangan (image_to_data)  paragraf=14  ichki \n= 12  chunk=2  o'rtacha chunk=562 belgi

C) clean_ocr_text dan keyin: paragraflar soni o'zgarmaydi, ichki \n yo'qoladi
   tozalangan                   paragraf=14  ichki \n=  0  chunk=2  o'rtacha chunk=562 belgi
   3-paragraf, oldin: "1.1. Ijrochi Buyurtmachiga ofis jihozlarini yetkazib berish va\no'rnatish xizmatini ko'rsatadi."
   3-paragraf, keyin: "1.1. Ijrochi Buyurtmachiga ofis jihozlarini yetkazib berish va o'rnatish xizmatini ko'rsatadi."
   Nega muhim: 'yetkazib\nberish' ikki alohida token, 'yetkazib berish' esa bitta ibora — keyword qidiruv va embedding uchun farq shu yerda.

D) Bo'g'in ko'chirish namunasi (sun'iy):
   oldin: "Shartnoma tomonlari o'z zimma-\nsiga olgan majburiyatlarni to'-\nliq bajaradi.\n\n- 3 -\n\nYangi paragraf."
   keyin: "Shartnoma tomonlari o'z zimmasiga olgan majburiyatlarni to'liq bajaradi.\n\nYangi paragraf."

E) Quality gate (8-bob):
   sahifa 1: text_layer     conf= 100.0 -> accept
   sahifa 2: ocr_tesseract  conf=  91.4 -> accept
   sahifa 3: ocr_tesseract  conf=  67.0 -> accept_with_flag
   sahifa 4: ocr_tesseract  conf=  42.5 -> manual_review
   sahifa 5: ocr_vlm        conf=  -1.0 -> accept_with_flag
- Kutilgan va kutilmagan. Kitob "chunker har qatorni paragraf deb o'ylaydi" degan edi. Aslida
image_to_stringparagraflar orasiga\n\nqo'yadi, shuning uchun paragraf chunker soni o'zgarmaydi (2 ta chunk oldin ham, keyin ham). O'zgargan narsa chunk ichi: 13 ta sun'iy qator uzilishi yo'qoldi. "yetkazib\nberish" ikki alohida token edi, endi bitta ibora: keyword qidiruv va embedding uchun farq shu yerda. - Apostrof. D qismida
to'-\nliqkitobdagi regex bilanto'- liqbo'lib qolardi.([\w'])bilanto'liq. 8- va 10-boblardagi kod shunga ko'ra tuzatildi. - Darvoza. VLM sahifasi (conf −1) har doim
accept_with_flag: 6-bob, xatosi ko'rinmaydi.
9-lab: evaluate — hamma variant bitta jadvalda
9-bobning intizomi: "preprocessing foyda berdimi?" degan savolga raqam bilan javob. To'rt variant, 17 rasm, bitta buyruq. Til fayl nomidan tanlanadi (lang_for): real loyihada bu metadata yoki til aniqlash bo'ladi.
lab09_evaluate.py
# lab09_evaluate.py — 9-bob: ground_truth/ ustida istalgan OCR variantini bitta buyruq bilan baholash.
# python lab09_evaluate.py           -> 4 ta preprocessing varianti, har rasm uchun CER/WER va o'rtacha
import sys
import time
from pathlib import Path

from ocrlib import ocr_text, preprocess, score, to_gray

HERE = Path(__file__).parent
S, G = HERE / "samples", HERE / "ground_truth"

# Har rasm uchun til (fayl nomidan): kirill -> uzb_cyrl, rus -> rus, qolgani uzb
def lang_for(name):
    if "kirill" in name or "gazeta" in name:
        return "uzb_cyrl"
    if "rus" in name:
        return "rus"
    return "uzb"


def image_samples():
    return sorted(p for p in S.iterdir() if p.suffix in (".png", ".jpg") and (G / (p.stem + ".txt")).exists())


VARIANTS = {
    "none":          lambda p: to_gray(p),
    "otsu":          lambda p: preprocess(p, "otsu", do_deskew=False),
    "otsu+deskew":   lambda p: preprocess(p, "otsu"),
    "adaptive":      lambda p: preprocess(p, "adaptive"),
}


def evaluate(variant_fn, files, label):
    cers, wers, t0 = [], [], time.perf_counter()
    rows = []
    for p in files:
        truth = (G / (p.stem + ".txt")).read_text(encoding="utf-8")
        text = ocr_text(variant_fn(p), lang=lang_for(p.name))
        sc = score(truth, text)
        cers.append(sc["cer"]); wers.append(sc["wer"]); rows.append((p.name, sc["cer"], sc["wer"]))
    print(f"\n== {label}: o'rtacha CER={sum(cers)/len(cers):.3f}  WER={sum(wers)/len(wers):.3f}  ({time.perf_counter()-t0:.0f} s)")
    return rows


if __name__ == "__main__":
    files = image_samples()
    names = [v for v in sys.argv[1:]] or list(VARIANTS)
    table = {}
    for v in names:
        for name, c, w in evaluate(VARIANTS[v], files, v):
            table.setdefault(name, {})[v] = (c, w)
    print(f"\n{'rasm':22s}" + "".join(f"{v:>16s}" for v in names))
    for name in table:
        print(f"{name:22s}" + "".join(f"{table[name][v][0]:8.3f}/{table[name][v][1]:5.2f}   " for v in names))
    print("(har katak: CER/WER; eng kichigi yaxshi)")
== none: o'rtacha CER=0.217  WER=0.312  (12 s)

== otsu: o'rtacha CER=0.194  WER=0.286  (12 s)

== otsu+deskew: o'rtacha CER=0.194  WER=0.284  (12 s)

== adaptive: o'rtacha CER=0.174  WER=0.292  (15 s)

rasm                              none            otsu     otsu+deskew        adaptive
02_skan_rus.png          0.000/ 0.00      0.000/ 0.00      0.000/ 0.00      0.000/ 0.00
03_uzb_lotin.png         0.002/ 0.01      0.002/ 0.01      0.002/ 0.01      0.002/ 0.01
04_uzb_kirill.png        0.005/ 0.03      0.002/ 0.02      0.002/ 0.02      0.008/ 0.05
05_telefon_soya.jpg      0.251/ 0.30      0.200/ 0.27      0.200/ 0.27      0.002/ 0.01
06_qiyshiq.png           0.002/ 0.01      0.006/ 0.03      0.003/ 0.01      0.002/ 0.01
07_jadval.png            0.704/ 0.79      0.696/ 0.79      0.696/ 0.79      0.700/ 0.79
10_chek_1.jpg            0.080/ 0.24      0.031/ 0.18      0.031/ 0.18      0.045/ 0.26
10_chek_2.jpg            0.378/ 0.59      0.394/ 0.63      0.394/ 0.63      0.473/ 0.61
10_chek_3.jpg            0.086/ 0.26      0.012/ 0.12      0.012/ 0.12      0.031/ 0.15
11_past_dpi.png          0.002/ 0.01      0.002/ 0.01      0.002/ 0.01      0.004/ 0.02
12_dogli.png             0.076/ 0.36      0.076/ 0.38      0.076/ 0.38      0.054/ 0.36
13_xira_raqam.png        0.093/ 0.12      0.093/ 0.12      0.093/ 0.12      0.093/ 0.12
14_gazeta_1.png          0.022/ 0.13      0.015/ 0.07      0.015/ 0.07      0.399/ 0.66
14_gazeta_2.png          0.615/ 0.77      0.610/ 0.74      0.610/ 0.74      0.361/ 0.58
14_gazeta_3.png          0.663/ 0.81      0.657/ 0.78      0.657/ 0.78      0.452/ 0.68
15_juda_xira.jpg         0.491/ 0.57      0.306/ 0.43      0.306/ 0.43      0.151/ 0.37
(har katak: CER/WER; eng kichigi yaxshi)
Jadvalni o'qish. Bitta "eng yaxshi" variant yo'q, shuning uchun jadval kerak:
- Toza skanlar (02, 03, 04, 06, 11): hamma variant ≤ 0.006. Preprocessing na foyda, na zarar.
- Telefon surati (05) va juda xira surat (15): faqat adaptive ishlaydi (0.20 → 0.002; 0.31 → 0.15).
- Gazeta (14): adaptive zarar qiladi (0.015 → 0.40): kulrang fon va bleed-through hudud bo'yicha chegarada shovqinga aylanadi. Otsu to'g'ri. Skaner → Otsu qoidasi shu yerda.
- Gazeta 2 va 3 (0.61, 0.66): bu preprocessing xatosi emas, layout xatosi: Tesseract ikki ustunni bitta qilib o'qidi. 1-sahifada esa to'g'ri ajratdi. Bir xil dizayn, har xil natija. Yechim 12-bob 6-loyihada (ustunlarni o'zimiz ajratamiz): 0.66 → 0.026.
- Jadval (07) hamma variantda 0.70: Tesseract ishi emas, VLM ishi (6-lab: 27/28).
- Chek 2 (telefon): otsu 0.39, adaptive 0.47, ikkalasi yomon. Sabab:
1x,1Кдkabi mayda xatolar ko'p va kirill/lotin aralash so'zlar. 12-bob 2-loyihada maydon darajasida baholanadi.
O'rtacha CER 0.17 ko'rinishi yomon, lekin uni bitta raqam sifatida o'qimang: jadvaldagi 17 rasmning 11 tasi 0.03 dan past. O'rtachani 07, 14_2, 14_3 va 15 tortadi, va ularning har birining sababi boshqa. 9-bob: o'rtacha yaxshi bo'lsa ham muhim maydonlar xato bo'lishi mumkin, teskarisi ham to'g'ri.
O'qituvchi eslatmalari: darsda nima deyish, nima so'rash
| Lab | Bir gapda mohiyat | Buzish → tuzatish | Talabaga savol |
|---|---|---|---|
| 0, 1 | Ground truth siz OCR sifati taxmin | Chek truth iga ------ qo'shing → CER 0.24 | Nega bu "xato" xato emas? |
| 2 | Detection matn qayerda, recognition nima deydi | Soyali surat → 29 so'z yo'q | Qizil emas, yo'q: qaysi bosqichda yo'qoldi? |
| 3 | Yomon rasm + zo'r model < yaxshi rasm + oddiy model | Otsu soyada → 0.20; adaptive → 0.003 | Nega 600 DPI 300 dan yomon bo'lishi mumkin? |
| 4 | Til, PSM, confidence: uchta murvat | rus tili lotin matnda → 0.79 | conf 91 va CER 0.20 qanday sig'adi? |
| 5 | Neyron detection surat uchun, lekin o'zbek yo'q | EasyOCR ru → ў қ ғ ҳ yo'q | Qachon EasyOCR, qachon Tesseract+adaptive? |
| 6 | VLM: kuchli, sekin, xatosi ko'rinmaydi | Kitob prompti → kirill; qat'iy prompt | Bank shartnomasini VLM ga ishonasizmi? |
| 7 | Arzon tekshiruv oldin, qimmat ish keyin | is_scanned aralash PDF da adashadi | 200 sahifani birdan ochsak? |
| 8 | OCR matni chunker uchun iflos | to'-liq kitob regexi bilan | (? |
| 9 | Raqam bo'lmasa fikr yo'q | Gazetaga adaptive → 0.40 | O'rtacha CER 0.17: bu yomonmi? |
Jonli demoda buziladigan narsalar. TesseractNotFoundError (Windows da tesseract_cmd yo'li); uzb tili yo'q (tesseract --list-langs); EasyOCR internetdan model yuklayapti (oldindan ishga tushiring); Ollama javob bermayapti (ollama serve, model ollama list da bormi, WSL dan Windows Ollama ga localhost emas, host IP bilan ulanadi); VLM 3 daqiqa o'ylayapti (GPU siz: 3b model yoki saqlangan chiqish); eski snippetlardagi int(conf) (yangi pytesseract "95.2" beradi).
Talabalar so'raydigan savollar. "Google Lens bor-ku?" — maxfiy hujjat cloud ga chiqmaydi, 10 000 sahifa qo'lda yuklanmaydi, confidence va metrika kerak. "Qaysi biri eng yaxshi?" — savol noto'g'ri, 9-lab jadvali: rasm turiga qarab. "VLM hammasini qiladi, qolganini nega o'rganamiz?" — 6-lab F: toza matnga VLM sekin va aniqroq emas, confidence bermaydi, alifboni o'zgartirib yuboradi. "Confidence 90 = 10% xato?" — 4-lab E: yo'q. "Pasport o'qisak bo'ladimi?" — texnik ha, huquqiy faqat offline, ruxsat bilan, saqlamasdan; kursda qilmaymiz.
Xulosa
| Tushuncha | Asosiy fikr |
|---|---|
| Sun'iy namunalar | Matn + buzilish + ground truth bir joyda: printer siz, CER birinchi daqiqadan |
| Preprocessing | Adaptive soyani yengadi (0.25 → 0.003), median tuz-qalampirni (0.06 → 0.003), NL-means emas |
| Tesseract | To'g'ri til va PSM: 0.002; noto'g'ri til: 0.79; PSM 11 chekni buzadi |
| Confidence | Model o'ziga ishonadi, matnga emas: conf 85 va CER 0.31 bir vaqtda bo'ladi; past-conf ulushi kerak |
| VLM | Jadval 27/28, lekin alifboni o'zgartiradi va xatosi ko'rinmaydi: qat'iy prompt + review |
| Layout | Ikki ustunli sahifa: Tesseract 3 tadan 2 tasida adashdi; yechim o'z column-split (12-bob) |
| O'lchash | Bitta jadval, 17 rasm, 4 variant: qaror raqamdan, taxmindan emas |
Bu bobni bepul o'qidingiz.
Kitob o'rgatadi, lekin sizning kodingiz nega ishlamaganini ayta olmaydi. Kursda uy vazifangiz tekshiriladi.