Ma'lumot va masala
Bu kitob haqida
Bu kitob ikkita mavzuni chuqur tushuntiradi: confusion matrix (model qayerda to'g'ri topdi va qayerda adashdi) va nomutanosib ma'lumot (bir klass ikkinchisidan ancha ko'p bo'lganda nima o'zgaradi). Yo'l davomida precision, recall, F1, threshold, ROC curve va AUC ni ham o'rganamiz.
Har bir tushunchada uchta savolga javob beramiz: nima u, nega shunday nomlangan va nega aynan shunday hisoblanadi.
Asos: Aurélien Géron, Hands-On Machine Learning with Scikit-Learn, Keras and TensorFlow, 3-bob (Classification). Hamma misollar haqiqiy MNIST ma'lumotida ishga tushirilgan. Kitobdagi har bir son — kodning haqiqiy natijasi.
Kitobni o'qish uchun nima kerak: Python, pandas, fit va predict, train_test_split, cross-validation.
Kodni o'zingiz ishga tushirsangiz: - MNIST birinchi marta internetdan yuklanadi (taxminan 30 soniya), keyin kompyuterda saqlanib qoladi. - 6-bobdagi RandomForest taxminan 1 minut, 8-bobdagi 10 klassli model taxminan 2 minut o'qitiladi. - Kodni boblar tartibida ishga tushiring: har bir bob oldingi boblardagi o'zgaruvchilardan foydalanadi.
Bu kitobda nima qilamiz va nega?
Model qurish — ishning yarmi. Ikkinchi yarmi — modelni to'g'ri baholash.
Nega bu shunchalik muhim? Chunki baho noto'g'ri bo'lsa, yomon modelni "yaxshi" deb ishga tushirib yuboramiz. Masalan: bank firibgarlikni topadigan model qurdi. Model 99.8% accuracy ko'rsatdi. Model ishga tushirildi va... bitta ham firibgarni ushlamadi. Bu qanday bo'lishi mumkinligini shu kitobda o'z qo'limiz bilan ko'ramiz.
Buning uchun bizga real classification masalasi kerak: o'ylab topilgan emas, haqiqiy ma'lumot. Biz MNIST ni olamiz.
MNIST nima?
- 70 000 ta qo'lda yozilgan raqam rasmi (0 dan 9 gacha).
- Raqamlarni AQSh dagi o'rta maktab o'quvchilari va aholini ro'yxatga olish byurosi (US Census Bureau) xodimlari yozgan. Shuning uchun yozuvlar har xil: kimdir chiroyli, kimdir qiyshiq yozgan.
- Har bir rasm 28 × 28 piksel, oq-qora.
- Har bir rasmga to'g'ri javob yozib qo'yilgan: bu rasmda qaysi raqam. Bu javob label deyiladi.
- ML dagi eng mashhur dataset. Yangi algoritm chiqsa, avval MNIST da sinab ko'rishadi. Shuning uchun uni ML ning "hello world"i deyishadi.
Nega aynan MNIST?
- Xatoni ko'z bilan ko'ramiz. Model "bu 5" desa, rasmni ochib qaraymiz va nega adashganini tushunamiz. Bank jadvalidagi raqamlarda buni qilib bo'lmaydi.
- Ichida tabiiy nomutanosiblik bor. Har bir raqam taxminan 10%. "Bu 5 mi yoki yo'qmi?" degan savol bersak, 9% ga qarshi 91% chiqadi. Bu kitobning ikkinchi mavzusi uchun tayyor misol.
- Katta. 70 000 ta rasmda natijalar tasodifiy emas, barqaror bo'ladi.
- Kitob ham shuni ishlatadi. Natijalarni Géron kitobi bilan solishtirish mumkin.
Kod nima qiladi?
fetch_openml— sklearn ning funksiyasi. U datasetni OpenML saytidan (openml.org, ochiq datasetlar ombori) nomi bo'yicha yuklab oladi. Birinchi marta internetdan yuklaydi va kompyuterdagiscikit_learn_datapapkasida saqlaydi. Keyingi safar diskdan o'qiydi, internet kerak bo'lmaydi."mnist_784"— OpenML dagi datasetning nomi. 784 — har bir rasmdagi piksellar soni.as_frame=False— natijani pandas DataFrame emas, NumPy array qilib beradi. Nega? Rasmni chizish uchun unireshapeqilamiz va 60 000 ta qatorni kesamiz. Array da bu oson va tez. 784 ta ustunli DataFrame bizga kerak emas.return_X_y=True— faqat ikkita narsani qaytaradi:X(rasmlar) vay(javoblar). Bu parametr bo'lmasa, ichida tavsif, ustun nomlari va boshqa ma'lumotlar bor katta obyekt qaytadi.X.shape— massivning o'lchami: (qatorlar soni, ustunlar soni).
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from sklearn.datasets import fetch_openml

X, y = fetch_openml("mnist_784", as_frame=False, return_X_y=True)
X.shape
(70000, 784)
(70000, 784): 70 000 ta qator — har bir qator bitta rasm. 784 ta ustun — har bir ustun bitta piksel.
Nega rasm bitta qatorga aylangan?
sklearn modellari har bir namunani bitta qator sonlar ko'rinishida kutadi. X — jadval: qator — namuna, ustun — feature. Rasm esa 28 × 28 kvadrat. Shuning uchun uni qatorma-qator yoyib, 784 ta sondan iborat bitta qatorga aylantirishgan: birinchi 28 ta son — rasmning eng yuqori qatori, keyingi 28 tasi — ikkinchi qatori va hokazo. 28 × 28 = 784.
Demak model uchun rasm — shunchaki 784 ta son. Model "chiziq", "halqa", "burchak" kabi tushunchalarni bilmaydi. U faqat qaysi pikselda qancha siyoh borligini ko'radi. Bu fikr 8-bobda modelning nega adashishini tushuntirib beradi.
Birinchi rasmni reshape(28, 28) bilan qaytadan kvadrat qilamiz va uning bir bo'lagini (5–12 qatorlar, 4–15 ustunlar) son ko'rinishida ko'ramiz:
pd.DataFrame(X[0].reshape(28, 28).astype(int)).iloc[5:13, 4:16]
    4   5   6   7    8    9    10   11   12   13   14   15
5    0   0   0   0    0    0    0    0    3   18   18   18
6    0   0   0   0   30   36   94  154  170  253  253  253
7    0   0   0  49  238  253  253  253  253  253  253  253
8    0   0   0  18  219  253  253  253  253  253  198  182
9    0   0   0   0   80  156  107  253  253  205   11    0
10   0   0   0   0    0   14    1  154  253   90    0    0
11   0   0   0   0    0    0    0  139  253  190    2    0
12   0   0   0   0    0    0    0   11  190  253   70    0
Har bir son — bitta pikselning rangi: - 0 — oq, ya'ni bo'sh qog'oz. - 255 ga yaqin — qora, ya'ni siyoh. - Orasidagi sonlar — kulrang, chiziqning cheti.
Yuqoridagi 253 lar qatoriga qarang: bu 5 raqamining yuqori gorizontal chizig'i. Pastroqda sonlar o'ngga qarab ketadi: bu 5 ning pastga tushadigan qismi. Kompyuter raqamni aynan shunday "ko'radi".
Endi xuddi shu sonlarni rasm qilib chizamiz. Birinchi 10 ta rasm:
fig, axes = plt.subplots(1, 10, figsize=(12, 1.6))
for ax, rasm, belgi in zip(axes, X, y):
    ax.imshow(rasm.reshape(28, 28), cmap="binary")
    ax.set_title(belgi)
    ax.axis("off")
plt.show()
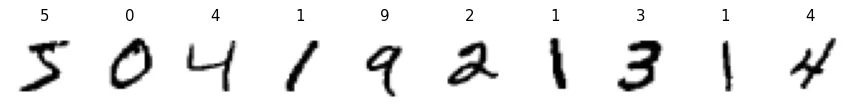
Kodning har bir qatori nima qiladi:
- plt.subplots(1, 10, figsize=(12, 1.6)) — 1 qator va 10 ta kichik oyna (ax) yaratadi. figsize — butun rasmning o'lchami (eni va bo'yi, dyuymda).
- zip(axes, X, y) — har bir oynaga bitta rasm va uning javobini juftlab beradi. zip eng qisqa ro'yxat tugaganda to'xtaydi. Oynalar 10 ta, shuning uchun faqat birinchi 10 ta rasm chiziladi.
- rasm.reshape(28, 28) — 784 ta sonni qaytadan 28 × 28 kvadratga yig'adi. Busiz imshow rasm chiza olmaydi.
- cmap="binary" — rang xaritasi: 0 ni oq, katta sonlarni qora qiladi. Qog'ozdagi yozuvga o'xshab ko'rinadi.
- ax.set_title(belgi) — rasm tepasiga uning label ini yozadi.
- ax.axis("off") — o'q chiziqlari va ulardagi raqamlarni olib tashlaydi. Faqat rasm qoladi.
Tepadagi label lar: 5, 0, 4, 1, 9, 2, ... Birinchi rasm — 5. Ba'zi raqamlarni (masalan, 9 yoki 4 ni) odam ham birinchi qarashda qiyin taniydi. Model ham shunday rasmlarda adashadi.
Label lar qanday saqlangan?
y[:10]
array(['5', '0', '4', '1', '9', '2', '1', '3', '1', '4'], dtype=object)
E'tibor bering: label lar matn (string): '5', '0', '4'. Son emas. OpenML ularni shunday saqlaydi.
Nega bu muhim? Keyingi katakda y_train == "5" deb qo'shtirnoq bilan yozamiz. Agar y_train == 5 (son bilan) yozsak, Python hech qanday xato chiqarmaydi, lekin hamma javob False chiqadi: matn '5' son 5 ga teng emas. Shunda "5 lar yo'q" degan noto'g'ri ma'lumot bilan ishlab ketamiz. Python xato bermaydigan, lekin natijani buzadigan bunday xatolar eng xavflisi.
Masalani soddalashtiramiz: "Bu 5 mi yoki yo'qmi?"
10 ta klass o'rniga avval ikkita klass bilan ishlaymiz: "5" va "5 emas". Bunday model binary classifier deyiladi. Kitobda u "5-detector" deb ataladi.
Nega avval ikkita klass? - Confusion matrix ikki klassda 2 × 2 bo'ladi. To'rtta katakni bittalab tushuntirish oson. 8-bobda 10 × 10 ga o'tamiz. - Real hayotdagi ko'p masalalar aynan shunday tuzilgan: kasal / sog'lom, firibgar / oddiy to'lov, spam / oddiy xat, nuqsonli / yaxshi mahsulot. Bitta klassni qidiramiz, qolgan hammasi "boshqa". "5 / 5 emas" ham xuddi shunday.
Nega birinchi 60 000 ta rasm — train?
MNIST tayyor bo'lingan: birinchi 60 000 tasi train, oxirgi 10 000 tasi test. Train qismi allaqachon aralashtirilgan, shuning uchun har bir bo'lakda hamma raqamlar bor.
Test qismini oxirigacha ochmaymiz. Nega? Test — bu modelning "yangi, hech qachon ko'rilmagan ma'lumot"dagi natijasi. Agar test ga qarab nimanidir tanlasak (model, threshold, parametr), test ham train ning bir qismiga aylanadi. Keyin modelning yangi ma'lumotda qanday ishlashini bilishning halol yo'li qolmaydi. Shuning uchun test faqat eng oxirida, hamma tanlov qilib bo'lingandan keyin, bir marta ishlatiladi (7-bob oxirida).
X_train, X_test, y_train, y_test = X[:60000], X[60000:], y[:60000], y[60000:]
y_train_5 = y_train == "5"
y_test_5 = y_test == "5"

pd.Series(y_train_5).value_counts().to_frame().assign(ulushi=lambda d: d["count"] / len(y_train_5))
       count   ulushi
False  54579  0.90965
True    5421  0.09035
Kod nima qildi:
- X[:60000] — birinchi 60 000 qator, X[60000:] — qolganlari.
- y_train == "5" — har bir label ni "5" bilan solishtiradi va True/False massivini qaytaradi: rasm 5 bo'lsa True, aks holda False. Bu bizning yangi javoblarimiz.
- value_counts() — nechta True va nechta False borligini sanaydi. ulushi — har birining umumiy sondagi ulushi.
Natija: 60 000 ta rasmdan atigi 5421 tasi (9%) 5. Qolgan 54 579 tasi (91%) 5 emas.
Demak bu ma'lumot allaqachon nomutanosib: bir klass ikkinchisidan 10 baravar ko'p. Bu bizni qanday aldashini keyingi qismda ko'ramiz.
Bu bobni bepul o'qidingiz.
Kitob o'rgatadi, lekin sizning kodingiz nega ishlamaganini ayta olmaydi. Kursda uy vazifangiz tekshiriladi.